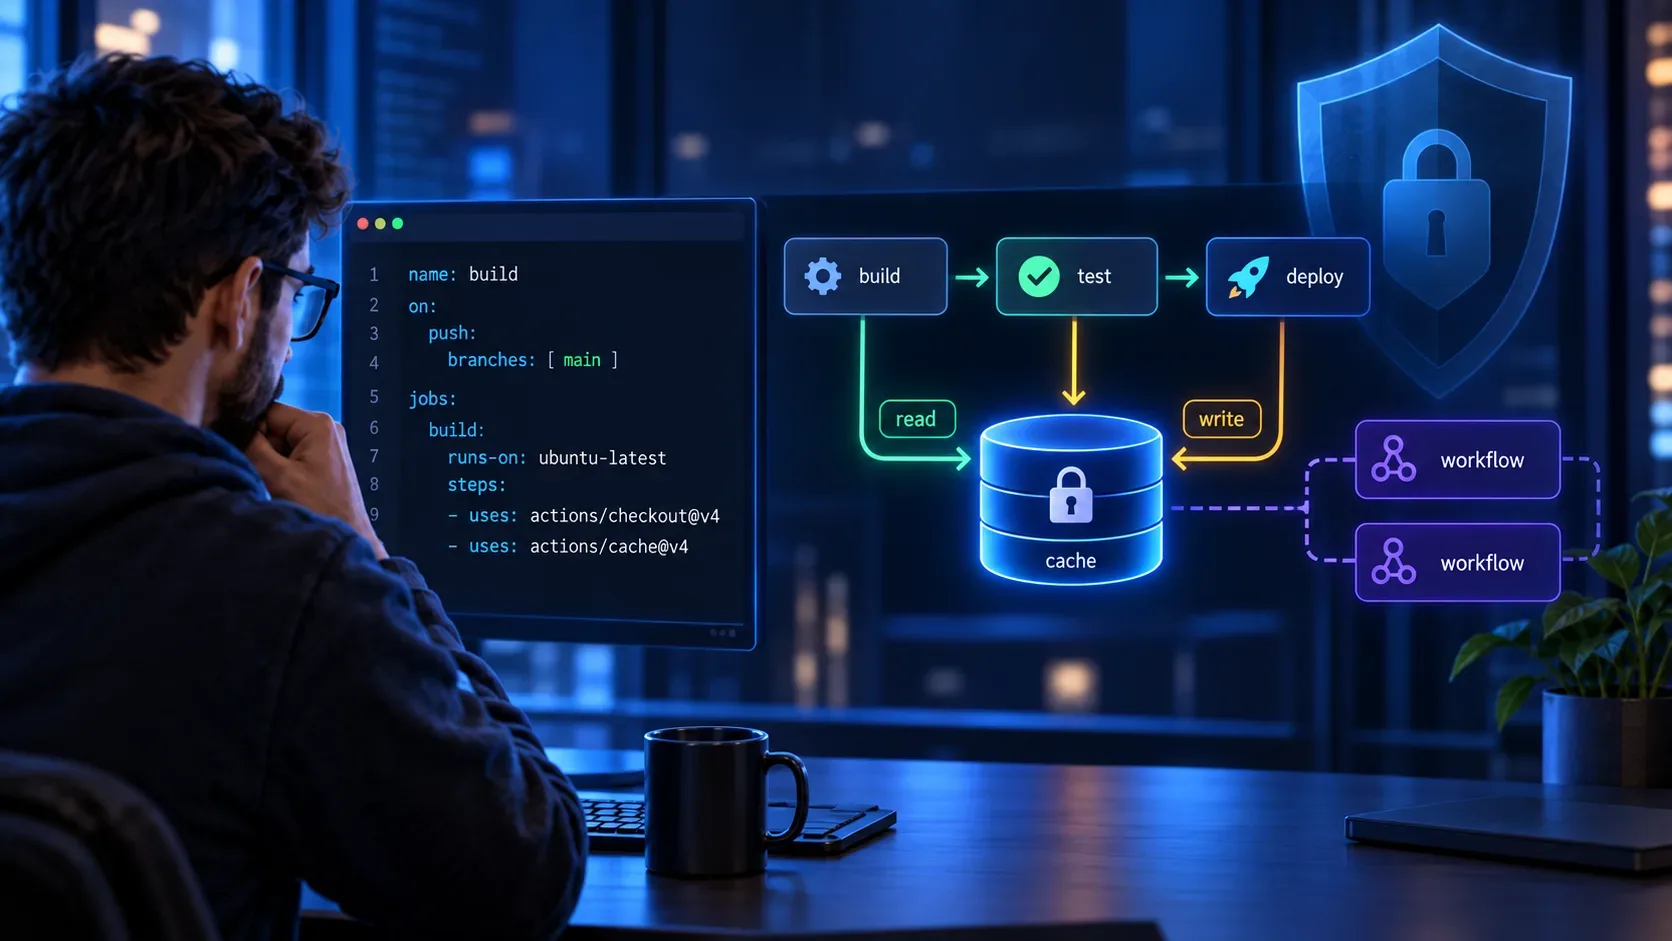
cache-mode de GitHub Actions permite separar de forma explícita quién puede restaurar cachés y quién puede guardarlas. La función pasó a disponibilidad general en GitHub.com el 10 de septiembre de 2026 y puede configurarse para todo un workflow o para un job específico. El objetivo es simple: dar a cada job únicamente la capacidad de caché que realmente necesita, reduciendo la superficie para cache poisoning sin convertir cada ejecución del pipeline en un cache miss.
En la práctica, la decisión no es solamente “caché activada o desactivada”. Hay cuatro niveles: read, write, write-only y none. El detalle más importante es que el modo también se propaga a los workflows reutilizables, y un límite explícito en el llamador impide que el workflow llamado solicite más acceso a la caché del que recibió.
Respuesta corta: ¿qué cache-mode usar en cada situación?
| Modo | ¿Restaura caché? | ¿Guarda caché? | Uso típico |
|---|---|---|---|
| read | Sí | No | Pruebas, validaciones de PR y jobs que solo necesitan acelerar instalaciones o builds. |
| write | Sí | Sí | Build confiable que consume y actualiza la caché, normalmente en push a una rama protegida o predeterminada. |
| write-only | No | Sí | Job productor que publica una caché nueva, pero no necesita confiar en contenido ya existente. |
| none | No | No | Deploys, jobs sensibles o tareas en las que la caché no aporta valor. |
Las definiciones oficiales están en la documentación de sintaxis de workflows y en la referencia de dependency caching. El anuncio de disponibilidad general también explica el objetivo de mínimo privilegio y protección frente a cache poisoning en el GitHub Changelog.
Los valores por defecto dependen del evento
Si no declaras cache-mode, GitHub aplica un valor por defecto según el nivel de confianza del evento. Los disparadores considerados confiables reciben acceso efectivo write. Los disparadores de baja confianza que resuelven a la rama predeterminada reciben read.
Entre los eventos que pueden crear o sobrescribir cachés en el ámbito de la rama predeterminada por defecto están push, workflow_dispatch, repository_dispatch, delete, registry_package, page_build y schedule. Otros eventos que resuelven a la rama predeterminada reciben acceso de solo lectura; la documentación cita pull_request_target, issue_comment y workflow_run como ejemplos.
Existe una excepción importante: pull_request no se ve afectado de la misma forma porque las cachés creadas por ese evento quedan asociadas al ref de merge del PR, en refs/pull/.../merge. Esas cachés no pueden escribirse directamente en el ámbito de la rama predeterminada ni reutilizarse por otros pull requests como si hubieran sido creadas en la rama base.
Define un valor restrictivo en el workflow y abre excepciones por job
cache-mode puede configurarse en el nivel superior del workflow y aplicarse a todos los jobs. Un valor en jobs.<job_id>.cache-mode sustituye ese valor solamente para ese job. Esto permite partir de una política conservadora y conceder escritura únicamente a los jobs que realmente mantienen la caché.
cache-mode: read
jobs:
test:
runs-on: ubuntu-latest
build-main:
if: github.event_name == 'push'
cache-mode: write
runs-on: ubuntu-latest
En este diseño, todos los jobs empiezan con acceso solo de lectura. El job build-main obtiene restauración y guardado únicamente en el flujo previsto para actualizar la caché. Así se reduce la posibilidad de que un job nuevo herede permiso de escritura por accidente.
Matriz práctica: escenario × modo recomendado
| Escenario | Modo inicial | Por qué |
|---|---|---|
| Pruebas de PR que solo instalan dependencias | read | Reutiliza una caché existente sin permitir que el job la modifique. |
| Build confiable en push a la rama predeterminada | write | Necesita restaurar la caché actual y guardar una nueva entrada cuando sea necesario. |
| Job dedicado a calentar o publicar caché | write-only | Evita confiar en una caché anterior y permite publicar un resultado nuevo. |
| Deploy o job con credenciales elevadas sin necesidad de caché | none | Elimina una superficie de estado compartido que no aporta beneficio a la tarea. |
| pull_request_target, issue_comment o workflow_run con entrada influenciable por terceros | read | Mantiene el valor seguro y evita reintroducir capacidad de cache poisoning. |
| Job que llama a un workflow reutilizable | Define el límite explícitamente | El valor explícito del llamador limita lo que puede solicitar el workflow reutilizable. |
Esta matriz es un punto de partida. La pregunta correcta para cada job es si necesita leer, escribir, hacer ambas cosas o ninguna. El mejor modo es el conjunto mínimo de capacidades que todavía permite hacer el trabajo.
Forks y pull_request_target: dónde aumenta el riesgo
El problema que cache-mode ayuda a contener es especialmente importante cuando código o datos no confiables pueden influir en lo que se guarda. En un ataque de cache poisoning, contenido controlado por un atacante puede introducirse en una caché y después ser restaurado por un workflow con más privilegios.
Por eso, declarar explícitamente write o write-only en disparadores de baja confianza puede saltarse el valor de solo lectura. GitHub advierte sobre este caso. Si un job con pull_request_target procesa código de un fork, datos controlados por el PR u otra entrada manipulable antes de guardar la caché, la escritura debe tratarse como una excepción de alto riesgo.
- Prefiere cache-mode: read en el workflow de baja confianza.
- Mantén la caché actualizada desde un workflow confiable disparado por push en la rama predeterminada.
- Si el job solo necesita restaurar, considera una operación explícita de solo restore, como actions/cache/restore, para dejar clara la intención.
- Nunca guardes secretos, tokens ni credenciales en rutas cacheadas; quien pueda leer la caché puede extraer su contenido.
- Trata los archivos restaurados desde caché como entrada no confiable, especialmente antes de ejecutarlos en jobs con privilegios mayores.
Workflows reutilizables: el límite debe estar explícito en el llamador
Los workflows reutilizables requieren atención especial porque existe una diferencia entre un valor por defecto derivado del evento y un límite declarado explícitamente. cache-mode se propaga al workflow llamado, y un valor explícito en el job llamador —o heredado explícitamente del workflow llamador— limita el máximo acceso a caché que puede solicitar el reutilizable.
Sin embargo, si el job llamador no define ni hereda un cache-mode explícito, un workflow reutilizable puede solicitar explícitamente write incluso cuando el disparador de baja confianza del llamador tendría read por defecto. Para imponer un techo real, configura el modo en el job que realiza la llamada.
jobs:
shared-tests:
cache-mode: read
uses: org/repo/.github/workflows/tests.yml@v1
Si el workflow llamado solicita una capacidad superior al límite explícito, la ejecución no comienza y GitHub devuelve un error de validación. Esto también se aplica a combinaciones que no forman una jerarquía simple: read y write-only conceden capacidades diferentes y no superpuestas, por lo que un llamador limitado a una de ellas no autoriza automáticamente la otra. El comportamiento se detalla en la documentación sobre reutilización de workflows.
write-only sirve cuando quieres producir sin consumir
write-only es el modo menos obvio y encaja en un patrón concreto: jobs que generan contenido derivado confiable para la caché pero no necesitan restaurar nada previamente. Al bloquear la lectura, reduces la dependencia del estado cacheado anterior y, al mismo tiempo, permites publicar el resultado del job para ejecuciones futuras.
No es un “write más restrictivo” dentro de una escala simple read → write. Es una capacidad distinta: guardar sin restaurar. Por eso, en workflows reutilizables, una solicitud de read no cabe dentro de un límite write-only y viceversa.
Qué ocurre cuando el modo prohíbe una operación
El runner expone el modo efectivo mediante la variable ACTIONS_CACHE_MODE. La acción actions/cache y el toolkit @actions/cache respetan ese valor. Cuando no se permite leer, la restauración se omite y se trata como cache miss. Cuando no se permite escribir, el guardado no se realiza. Las operaciones omitidas no tienen que hacer fallar el job: la ejecución continúa y el log informa del comportamiento.
Esto facilita la migración porque puedes aplicar una política más estricta y observar qué jobs realmente intentaban escribir. Aun así, no dependas solo de warnings o logs: la mejor configuración expresa la intención directamente en el YAML.
Estrategia de migración sin romper la caché
- Haz un inventario de quién restaura y quién guarda. Busca actions/cache, actions/cache/restore, actions/cache/save y acciones de setup que administran caché automáticamente.
- Empieza con un valor restrictivo. En muchos pipelines, cache-mode: read a nivel del workflow es un buen punto de partida.
- Concede write solo a los mantenedores de caché. Normalmente son pocos jobs de build en eventos confiables.
- Usa none donde no sea necesaria la caché. Deploys y tareas administrativas suelen ser buenos candidatos.
- Revisa los eventos de baja confianza. Presta especial atención a pull_request_target, issue_comment y workflow_run.
- Fija el límite en las llamadas a workflows reutilizables. No confíes solo en el valor derivado del evento; declara el techo en el job llamador.
- Prueba cache hit y cache miss. Comprueba que los jobs de lectura siguen siendo rápidos y que al menos un flujo confiable renueva las claves necesarias.
Ejemplo de política mínima para CI y deploy
cache-mode: read
jobs:
test:
runs-on: ubuntu-latest
cache-builder:
if: github.event_name == 'push'
cache-mode: write-only
runs-on: ubuntu-latest
deploy:
cache-mode: none
runs-on: ubuntu-latest
Este ejemplo muestra tres papeles distintos: prueba que solo consume, productor que solo publica y deploy sin acceso a caché. En otro proyecto, el builder puede necesitar write en lugar de write-only para restaurar dependencias existentes antes de actualizar la caché. La elección depende del flujo real, no de una regla universal.
Regla práctica de mínimo privilegio para la caché
Usa read como techo para jobs que solo se benefician de contenido existente; write únicamente cuando el job necesita consumir y actualizar la caché; write-only cuando debe publicar sin confiar en el estado anterior; y none cuando la caché no forma parte de la tarea. En workflows reutilizables, convierte ese techo en una configuración explícita en el llamador.
La ventaja no es solamente “más seguridad”. Una política clara también hace que el pipeline sea más fácil de revisar: quien lee el YAML puede ver, antes de inspeccionar cada step, qué jobs pueden influir en el estado compartido de la caché.