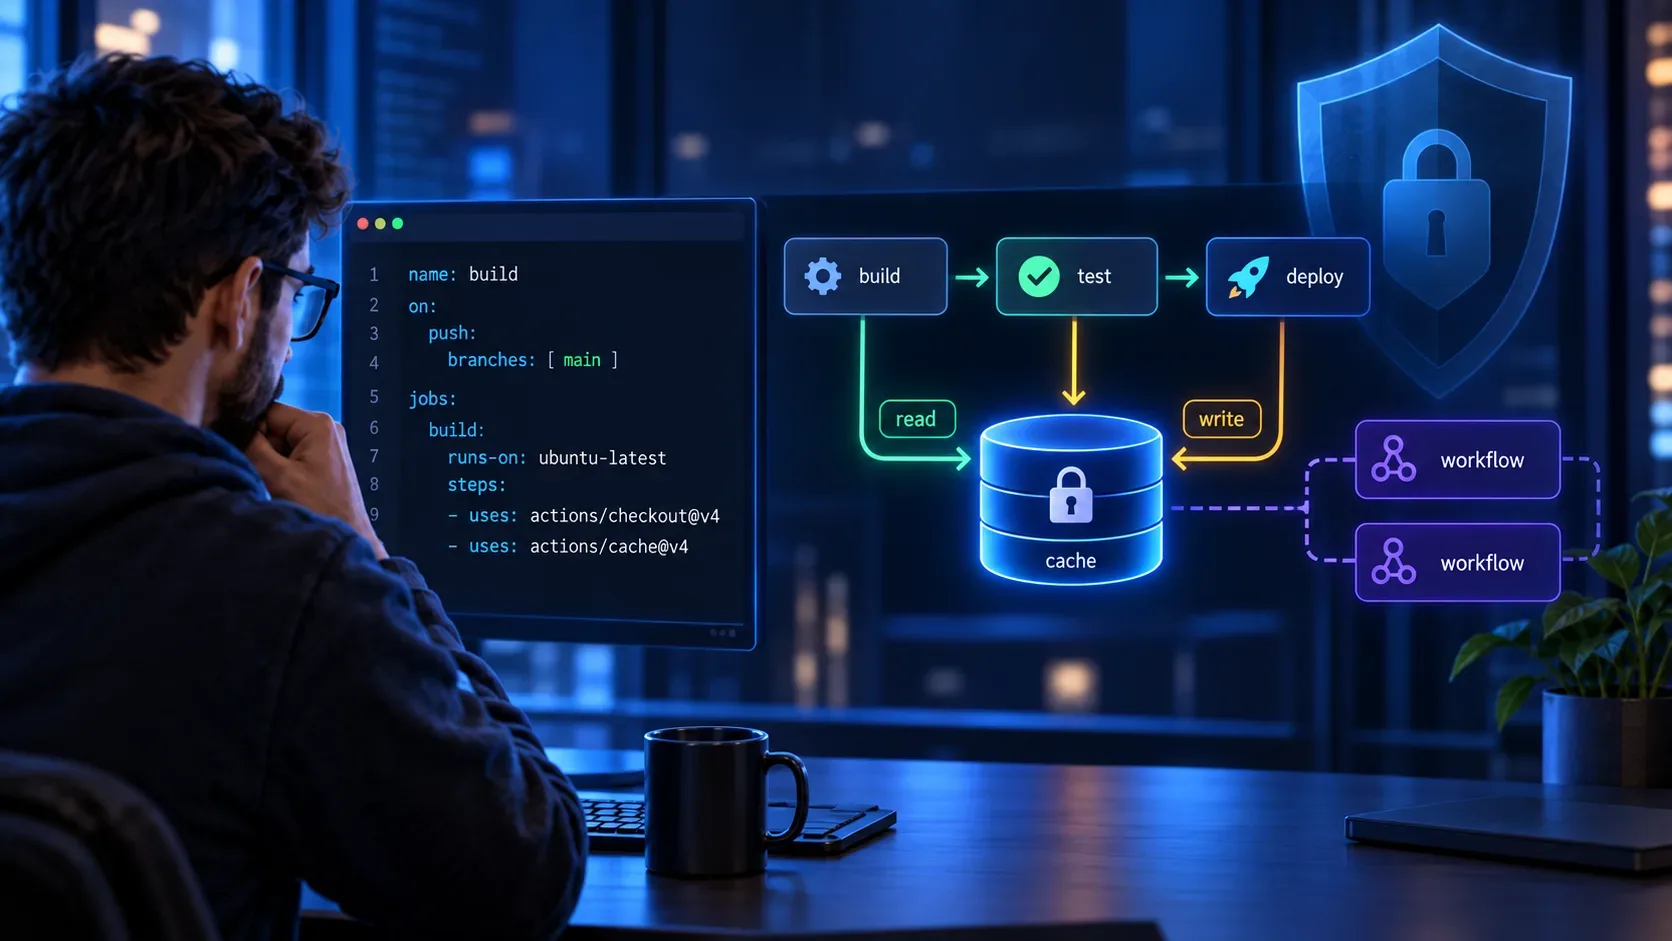
O cache-mode do GitHub Actions permite separar, de forma explícita, quem pode restaurar caches e quem pode salvá-los. O recurso ficou disponível de forma geral no GitHub.com em 10 de setembro de 2026 e pode ser definido no workflow inteiro ou em um job específico. A ideia é simples: dar a cada job apenas a capacidade de cache de que ele realmente precisa, reduzindo a superfície para cache poisoning sem transformar todo pipeline em cache miss.
Na prática, a decisão não deve ser “cache ligado ou desligado”. Há quatro níveis: read, write, write-only e none. O ponto mais importante é que o modo também é propagado para reusable workflows, e um limite explícito no chamador impede que o workflow chamado peça mais acesso do que recebeu.
Resposta curta: qual cache-mode usar em cada situação?
| Modo | Restaura cache? | Salva cache? | Uso típico |
|---|---|---|---|
| read | Sim | Não | Testes, validações de PR e jobs que só precisam acelerar instalação ou build. |
| write | Sim | Sim | Build confiável que consome e atualiza o cache, normalmente em push para branch protegida ou padrão. |
| write-only | Não | Sim | Job produtor que publica um cache novo, mas não precisa confiar em conteúdo já existente. |
| none | Não | Não | Deploy, jobs sensíveis ou etapas em que o cache não agrega valor. |
A definição oficial está na documentação de sintaxe de workflows e na referência de dependency caching. O anúncio de disponibilidade geral também explica o objetivo de least privilege e proteção contra cache poisoning no GitHub Changelog.
Os padrões dependem do gatilho
Se você não declarar cache-mode, o GitHub aplica um padrão baseado no nível de confiança do evento. Em gatilhos considerados confiáveis, o acesso efetivo é write. Em gatilhos de baixa confiança que resolvem para a branch padrão, o padrão é read.
Entre os eventos que podem criar ou sobrescrever caches no escopo da branch padrão por padrão estão push, workflow_dispatch, repository_dispatch, delete, registry_package, page_build e schedule. Outros eventos que resolvem para a branch padrão recebem somente leitura; a documentação cita como exemplos pull_request_target, issue_comment e workflow_run.
Há uma exceção importante: pull_request não entra nessa restrição da mesma forma porque o cache criado por esse evento fica associado ao ref de merge do PR, em refs/pull/.../merge. Esse cache não pode ser gravado diretamente no escopo da branch padrão nem reutilizado por outros PRs como se tivesse sido criado na base.
Defina um padrão restritivo no workflow e abra exceções por job
cache-mode pode ficar no nível superior do workflow e valer para todos os jobs. Um valor em jobs.<job_id>.cache-mode substitui esse padrão apenas naquele job. Isso permite começar de uma política conservadora e liberar escrita somente para quem realmente mantém o cache.
cache-mode: read
jobs:
test:
runs-on: ubuntu-latest
build-main:
if: github.event_name == 'push'
cache-mode: write
runs-on: ubuntu-latest
Nesse desenho, todos os jobs começam com leitura apenas. O job build-main ganha leitura e gravação somente quando for executado no fluxo previsto para atualizar o cache. Isso reduz a chance de um job novo herdar permissão de escrita por descuido.
Matriz prática: cenário × modo recomendado
| Cenário | Modo de partida | Por quê |
|---|---|---|
| Testes de PR que apenas instalam dependências | read | Reaproveita cache existente sem permitir que o job o altere. |
| Build confiável em push para a branch padrão | write | Precisa restaurar o cache atual e salvar uma nova entrada quando necessário. |
| Job dedicado a aquecer/publicar cache | write-only | Evita confiar em um cache anterior e permite publicar um novo resultado. |
| Deploy ou job com credenciais elevadas sem necessidade de cache | none | Remove uma superfície que não traz benefício para a tarefa. |
| pull_request_target, issue_comment ou workflow_run com entrada influenciável por terceiros | read | Mantém o padrão seguro e evita reintroduzir capacidade de cache poisoning. |
| Job que chama reusable workflow | Defina explicitamente o limite | O valor explícito do chamador limita o que o workflow reutilizável pode solicitar. |
Essa matriz é um ponto de partida. A pergunta correta para cada job é: ele precisa ler, escrever, fazer as duas coisas ou nenhuma? O melhor modo é o menor conjunto de capacidades que ainda atende ao trabalho.
Forks e pull_request_target: onde o risco aumenta
O problema que cache-mode ajuda a conter é especialmente relevante quando código ou dados não confiáveis podem influenciar o que será salvo. Em um ataque de cache poisoning, conteúdo controlado por um invasor pode ser colocado em um cache e depois restaurado por um workflow mais privilegiado.
Por isso, declarar explicitamente write ou write-only em gatilhos de baixa confiança pode contornar o padrão de somente leitura. O GitHub alerta para esse caso. Se um job com pull_request_target processa código de fork, dados do PR ou outra entrada controlável antes de salvar o cache, a escrita deve ser tratada como uma exceção de alto risco.
- Prefira cache-mode: read no fluxo de baixa confiança.
- Mantenha o cache atualizado por um workflow confiável disparado por push na branch padrão.
- Se o job só precisa restaurar, considere usar uma operação explicitamente de restore, como actions/cache/restore, para deixar a intenção clara.
- Nunca coloque segredos, tokens ou credenciais em caminhos cacheados; quem consegue ler o cache pode extrair seu conteúdo.
- Trate arquivos restaurados do cache como entrada não confiável, especialmente antes de executá-los em jobs com privilégios maiores.
Reusable workflows: o limite precisa estar no chamador
O comportamento com reusable workflows merece atenção porque há uma diferença entre o padrão calculado pelo evento e um limite declarado explicitamente. O cache-mode é propagado para o workflow chamado, e um valor explícito no job chamador — ou herdado explicitamente do workflow chamador — limita o máximo que o reutilizável pode pedir.
Porém, se o job chamador não definir nem herdar um cache-mode explícito, um reusable workflow pode declarar write mesmo quando o gatilho de baixa confiança do chamador teria read como padrão. Portanto, para garantir um teto real, configure o modo no job que faz a chamada.
jobs:
shared-tests:
cache-mode: read
uses: org/repo/.github/workflows/tests.yml@v1
Se o workflow chamado solicitar uma capacidade acima do limite explícito, a execução não começa e o GitHub retorna erro de validação. Isso também vale para combinações que não são uma simples escala linear: read e write-only concedem capacidades diferentes e não sobrepostas, então um chamador limitado a um deles não autoriza automaticamente o outro. A regra está detalhada na documentação de reutilização de workflows.
write-only é útil quando você quer produzir sem consumir
write-only é o modo menos óbvio e pode resolver uma classe específica de pipeline: jobs que geram um artefato derivado confiável para cache, mas que não precisam restaurar nada previamente. Ao impedir leitura, você reduz a dependência de conteúdo cacheado anterior e ainda permite que o resultado do job seja disponibilizado para execuções futuras.
Ele não é um “write mais restrito” no sentido hierárquico de read → write. É uma capacidade diferente: salvar sem restaurar. Isso explica por que, em reusable workflows, uma solicitação de read não cabe dentro de um limite write-only e vice-versa.
O que acontece quando uma operação é proibida pelo modo
O runner expõe o modo efetivo na variável ACTIONS_CACHE_MODE. A ação actions/cache e o toolkit @actions/cache respeitam esse valor. Quando a leitura não é permitida, a restauração é ignorada e tratada como cache miss. Quando a escrita não é permitida, o save não é realizado. Essas operações puladas não precisam derrubar o job: a execução continua e o log informa o comportamento.
Isso ajuda na migração porque você pode aplicar uma política mais restritiva e observar quais jobs realmente tentavam escrever. Ainda assim, não dependa apenas de warnings ou logs: a melhor configuração é aquela que expressa a intenção diretamente no YAML.
Estratégia de migração sem quebrar o cache
- Inventarie quem restaura e quem salva. Procure por actions/cache, actions/cache/restore, actions/cache/save e ações de setup que gerenciam cache automaticamente.
- Comece com um padrão restritivo. Em muitos pipelines, cache-mode: read no nível do workflow é um bom ponto de partida.
- Dê write somente aos mantenedores do cache. Normalmente são poucos jobs de build em eventos confiáveis.
- Use none em jobs que não precisam de cache. Deploy e tarefas administrativas são candidatos frequentes.
- Revise eventos de baixa confiança. Dê atenção especial a pull_request_target, issue_comment e workflow_run.
- Fixe o limite nas chamadas de reusable workflows. Não confie apenas no padrão derivado do evento; declare o teto no job chamador.
- Teste cache hit e cache miss. Garanta que jobs de leitura continuam rápidos e que pelo menos um fluxo confiável renova as chaves necessárias.
Exemplo de política enxuta para um pipeline com CI e deploy
cache-mode: read
jobs:
test:
runs-on: ubuntu-latest
cache-builder:
if: github.event_name == 'push'
cache-mode: write-only
runs-on: ubuntu-latest
deploy:
cache-mode: none
runs-on: ubuntu-latest
Esse exemplo ilustra três papéis diferentes: teste que só consome, produtor que só publica e deploy sem acesso. Em outro projeto, o builder pode precisar de write em vez de write-only para restaurar dependências existentes antes de atualizar o cache. A escolha depende do fluxo real, não de uma regra universal.
Regra prática para least privilege no cache
Use read como teto para jobs que só se beneficiam de conteúdo existente; write apenas quando o job realmente precisa consumir e atualizar o cache; write-only quando ele deve publicar sem confiar no estado anterior; e none quando cache não faz parte da tarefa. Em reusable workflows, transforme esse teto em uma configuração explícita no chamador.
O ganho não é apenas “mais segurança”. Uma política clara também torna o pipeline mais legível: quem revisa o YAML consegue ver, antes de abrir cada step, quais jobs podem influenciar o estado compartilhado de cache.