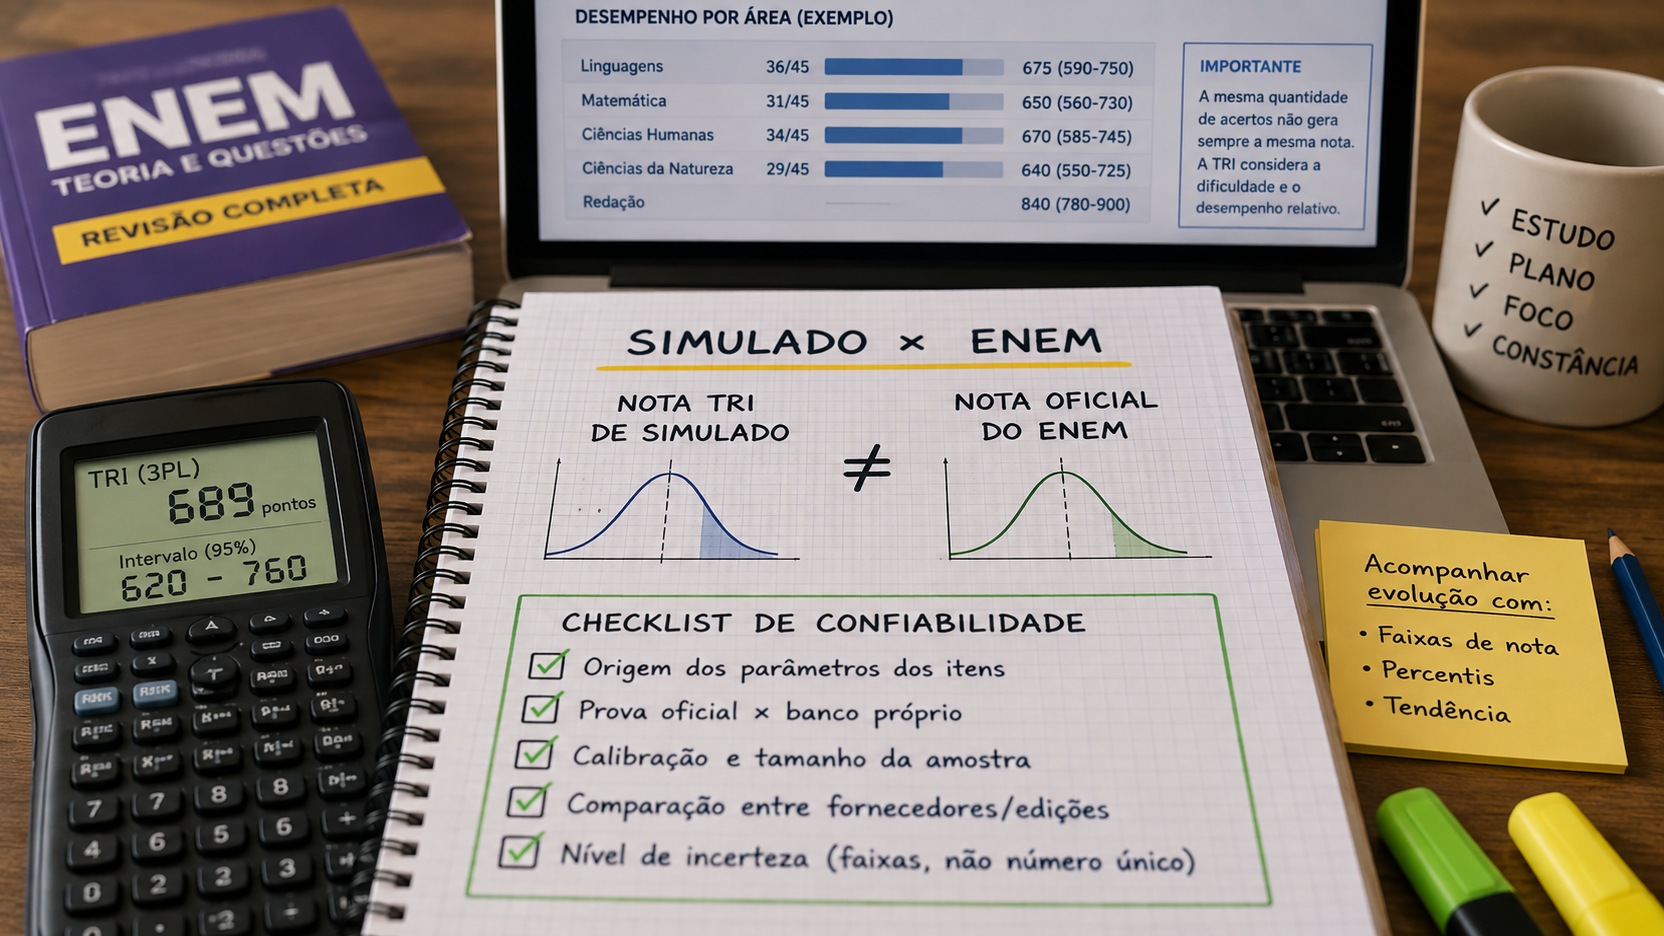
La respuesta corta es: la puntuación de una prueba TRI puede ser útil, pero no debe leerse automáticamente como la puntuación que obtendrías en el Enem. El valor es más fiable cuando la simulación utiliza ítems bien calibrados, una escala comparable a la del examen y un método de estimación documentado. Cuando estos elementos no se conocen, la nota funciona mejor como indicador de tendencia que como pronóstico puntual.
El cuidado es importante porque la teoría de respuesta al ítem no transforma simplemente un número de aciertos en un número fijo. El propio Inep informa que las competencias de las pruebas objetivas del Enem se calculan con base en el TRI. En los materiales del instituto, la lógica se explica por tres características de los ítems: discriminación, dificultad y probabilidad de acierto aleatorio. Esto te ayudará a comprender por qué dos personas con el mismo número de respuestas correctas pueden terminar con calificaciones diferentes.
La puntuación del TRI en la simulación no es, por definición, la puntuación del Enem
Dos plataformas pueden escribir "TRI" en la pantalla y aun así producir números que no son directamente comparables. El nombre del modelo no garantiza que los ítems hayan sido calibrados en la misma escala, que el banco de preguntas tenga la misma composición que el Enem o que la transformación final a la escala mostrada siga el mismo procedimiento.
En Enem, la calificación se produce dentro de un sistema de evaluación creado para ese examen. Los ítems pasan por procesos de elaboración, pretest y análisis. El Inep ya explicó que el pretest se realiza con una población similar a la que realizará la evaluación y que los resultados sirven para calibrar los ítems. Este detalle es central: no basta con clasificar informalmente una pregunta como fácil, media o difícil y asignarle un peso.
Por lo tanto, una calculadora que solo recibe el número total de aciertos y devuelve un único número está haciendo una aproximación. Puede utilizar datos históricos y producir una referencia útil, pero pierde información sobre qué ítems se respondieron correctamente y el patrón de respuestas que considera el TRI. Cuanta menos información se incluya en el cálculo, mayor será la precaución con la precisión presentada.
Qué hace que una estimación del IRT sea más confiable
¿De dónde vienen los parámetros de los elementos?
Este es el primer punto a comprobar. En el modelo de tres parámetros utilizado como referencia en los materiales del Inep, cada ítem tiene parámetros vinculados a la discriminación, la dificultad y la precisión del azar. Si la simulación utiliza preguntas oficiales de una edición anterior y trabaja con información de ítems publicada por el Inep, existe una base más auditable que en una conversión genérica de respuestas correctas a puntos.
Esto todavía no significa que ninguna herramienta reproducirá exactamente la nota oficial. Es necesario saber cómo se estima la competencia, cómo se tratan los ítems cancelados o adaptaciones y cómo se construye la escala final. La presencia de parámetros oficiales aumenta la transparencia, pero no elimina la necesidad de una metodología coherente.
Cuando el banco es propiedad, la pregunta cambia: ¿cómo se calibraron estos elementos? Un banco privado puede utilizar el TRI de manera técnicamente seria, pero necesita contar con suficientes datos de solicitud, una muestra adecuada y un procedimiento de calibración.. Si la plataforma no explica nada al respecto, no tendrás forma de distinguir una estimación psicométrica de una regla interna que simplemente imita la apariencia de la escala Enem.
¿La prueba utiliza elementos oficiales o su propio banco?
Una simulación compuesta por preguntas de ediciones anteriores de Enem tiene una ventaja de trazabilidad: se conoce el origen de los ítems y se pueden consultar pruebas, plantillas e informaciones publicadas por el Inep. Una base de datos patentada puede ser mejor para medir contenido nuevo y evitar la memorización, pero requiere su propia evidencia de calidad.
El error es imaginar que "pregunta estilo Enem" equivale automáticamente a "elemento en la escala Enem". El estilo pedagógico y la calibración estadística son cosas diferentes. Una pregunta puede parecer muy similar a las oficiales y aún no tener parámetros estimados en una población compatible.
¿Hubo calibración con una muestra adecuada?
El TRI depende de los datos de respuesta. Para estimar los parámetros de un ítem con calidad, es necesario observar cómo responden al mismo las personas con diferentes niveles de competencia. El tamaño de la muestra importa, pero no es el único punto. También importa quién conforma esta muestra y si se parece a la audiencia para la que se utilizará la medida.
Esto explica por qué una plataforma puede tener muchos usuarios y aun así producir una escala sesgada hacia un grupo específico. Un curso muy selectivo, por ejemplo, puede reunir a participantes con un perfil diferente al del grupo nacional. La estimación puede seguir siendo útil en ese entorno, pero no debe tratarse como intercambiable con una calificación oficial sin un procedimiento de vinculación de escala.
¿Es realmente comparable la escala entre pruebas y proveedores?
Este es uno de los puntos que más confusión genera. Dos pruebas pueden utilizar TRI y aun así estar en escalas diferentes. Si cada proveedor calibra su banco por separado y luego presenta una puntuación entre 0 y 1000, el hecho de que ambos muestren "680" no prueba que hayan medido el mismo nivel de competencia.
Para comparar números entre diferentes instrumentos, es necesario algún tipo de vínculo entre escalas, con ítems de referencia, parámetros compatibles u otro procedimiento psicométrico documentado. Sin esto, la comparación más segura es longitudinal dentro del mismo sistema: mismo
plataforma, metodología estable, evidencia de estructura similar e interpretación de resultados como tendencia.
¿La herramienta muestra incertidumbre o finge precisión?
Una estimación de competencia no es una medición libre de errores. Cuanto más pequeño o menos informativo sea el conjunto de elementos, mayor tiende a ser la incertidumbre. Por lo tanto, un rango suele ser más honesto que un número presentado como si fuera exacto.
Si una calculadora arroja 689 puntos, por ejemplo, vale la pena preguntarse qué significa ese 689. ¿Es una mediana histórica? ¿Una estimación basada en el patrón de respuestas? ¿Una regresión basada en el número total de respuestas correctas? ¿Existe un error estándar o un rango? Sin esta explicación, los decimales o la apariencia de precisión pueden transmitir más confianza de la que permite el método.
Por qué el mismo número de respuestas correctas no genera una única puntuación
Imagínese a dos estudiantes con 30 respuestas correctas en Matemáticas. Se acertaron la mayoría de los elementos fáciles y medios y también algunos difíciles.. El otro se equivocó en varias preguntas que, debido al comportamiento observado durante la calibración, son más accesibles y acertó en una secuencia de ítems más difíciles. Los dos tienen el mismo total, pero los patrones de respuesta transportan información diferente al modelo.
Esto no significa que el TRI "castigue" automáticamente a cualquiera que responda mal una pregunta fácil, ni tampoco significa que exista un peso fijo secreto para cada elemento. La competencia se estima considerando el conjunto de respuestas y las características estadísticas de los ítems. La idea de coherencia ayuda a explicar el fenómeno, pero debe entenderse como el comportamiento del modelo, no como una simple regla como "cometiste un error fácil, perdiste tantos puntos".
Los microdatos del Enem 2025, puestos a disposición por el Inep, permiten estudiar ese efecto con datos oficiales porque reúne pruebas, hojas de respuestas, información sobre ítems y calificaciones, entre otras variables. En lugar de buscar una tabla como "30 respuestas correctas = 700 puntos", un mejor análisis agrupa a los participantes con el mismo número de respuestas correctas en un área y observa la distribución de las notas obtenidas.
El resultado útil de este tipo de consulta no es un número mágico. Es un rango: por ejemplo, mediana y percentiles, además del rango observado después de excluir situaciones que no son comparables. El objetivo es visualizar que el mismo número total de respuestas correctas puede ocupar más de un punto en la escala. La amplitud de esta distribución es precisamente lo que tiende a ocultar una simple conversión de visitas.
Cómo utilizar microdatos sin crear una promesa de calificación falsa
Los microdatos oficiales son excelentes para construir referencias históricas, pero también deben interpretarse con cuidado. Una edición de Enem tiene su propia composición de elementos y las distribuciones de una prueba anterior no son una promesa para la siguiente. Muestran lo que pasó en ese grupo de participantes y en ese instrumento.
Para transformar los datos en una referencia de estudio, una actitud prudente es separar por área, contar las respuestas correctas de cada participante en la edición analizada y, para cada número total de respuestas correctas, resumir la distribución de puntuaciones. En lugar de publicar solo el promedio, es mejor observar la mediana y los percentiles como el 25 y 75, o el 10 y 90 cuando la muestra es grande. Esto hace explícito el grado de variación.
La lectura correcta sería: "en una edición pasada, los participantes con este número total de respuestas correctas ocuparon este rango de puntuaciones". La lectura incorrecta sería: "si hago este total, mi nota será esa". La primera declaración describe datos; el segundo transforma una distribución histórica en un pronóstico individual determinista.
Qué métricas utilizar para realizar un seguimiento de tu progreso
Los impactos de área siguen siendo la medida más transparente
Para monitorear el estudio semana a semana, el número de respuestas correctas en cada área es una métrica simple y verificable que no depende del proveedor. No reemplaza al TRI, pero te ayuda a saber si estás resolviendo más elementos correctamente.
Evite sumar las cuatro áreas y tratar el total general como si fueran una sola prueba. Enem calcula las competencias por área y la composición de cada área es diferente. Es más útil seguir por separado Idiomas, Humanidades, Naturaleza y Matemáticas.
Utilice la puntuación estimada como rango y tendencia
Si la simulación ofrece una estimación del TRI, registre el rango o rango informado, no solo el punto central. Al comparar maquetas del mismo proveedor, observe si el centro y el rango cambian consistentemente en múltiples aplicaciones. Un aumento aislado puede reflejar evidencia más favorable; una tendencia repetida es más informativa.
Cuando la plataforma solo ofrece un número, trátelo como un índice interno hasta que la metodología demuestre comparabilidad externa. Esto reduce la tentación de interpretar una pequeña diferencia, como 15 o 20 puntos, como un progreso real sin considerar la incertidumbre del instrumento.
Comparar percentiles solo dentro del mismo grupo de referencia
El percentil responde a una pregunta diferente a la calificación: muestra tu posición en relación al grupo que realizó esa evaluación. Puede resultar útil en simulaciones grandes, pero sólo tiene sentido saber quiénes componen este grupo. El percentil de una plataforma nacional abierta y el percentil de una clase de alto rendimiento no son equivalentes.
Lo mismo ocurre con la comparación de ediciones. Si la audiencia cambia mucho, la posición relativa puede aumentar o disminuir sin que su competencia cambie en la misma proporción. Utilice el percentil como complemento, no como sustituto de las respuestas correctas y la estimación de competencia.
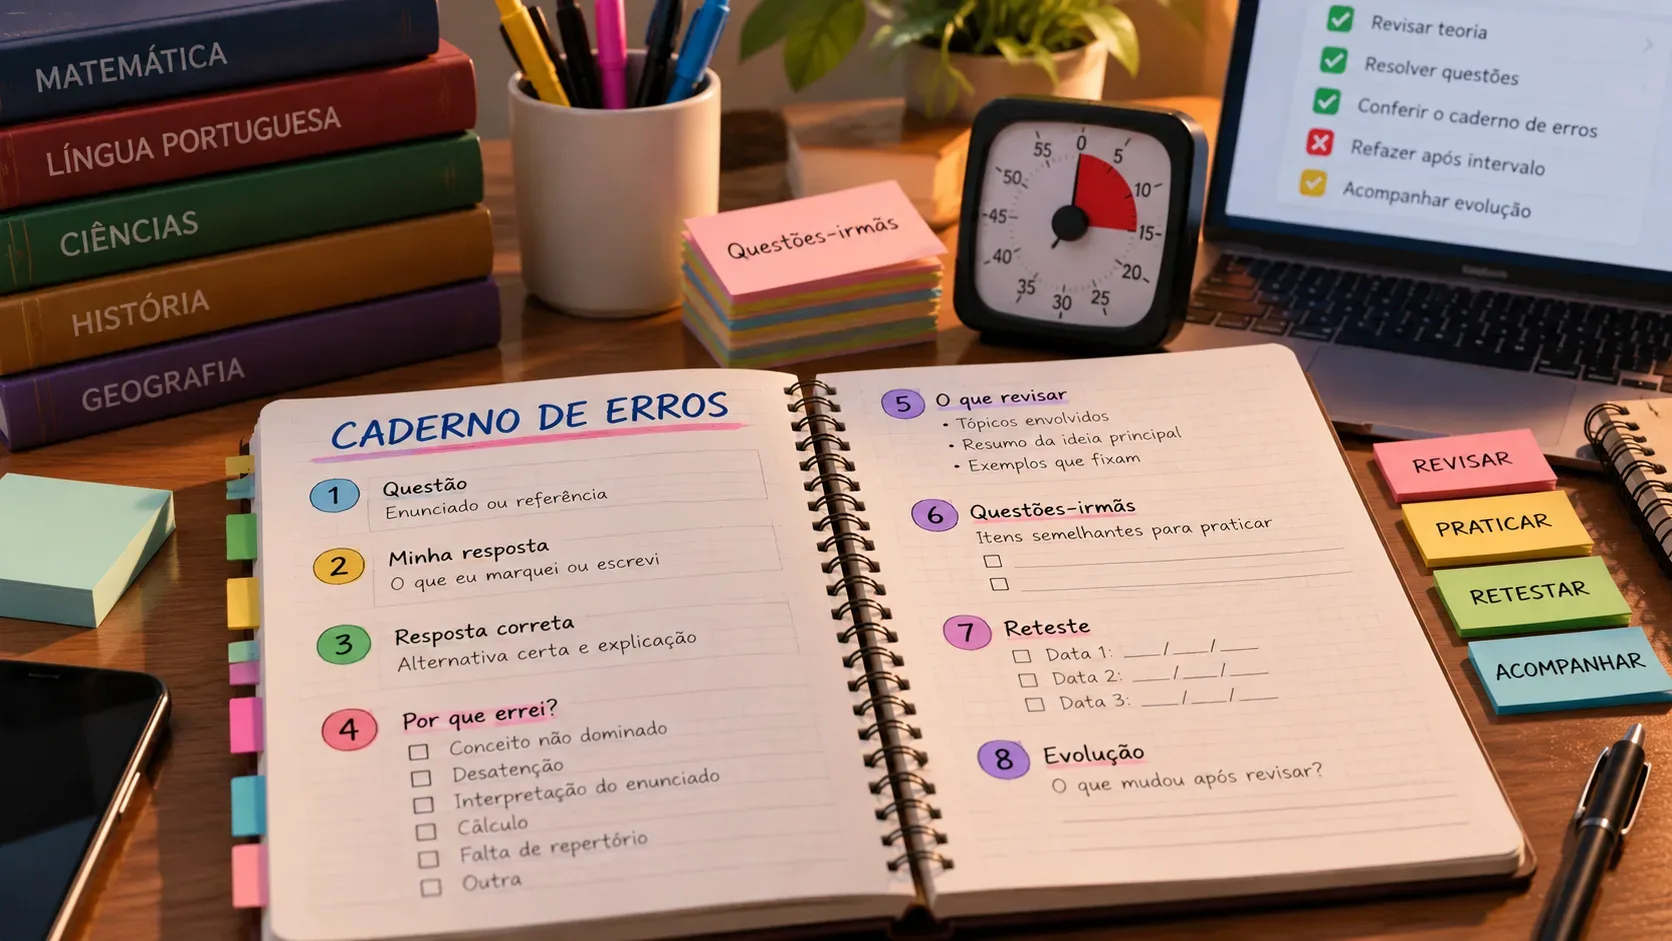
Realice un seguimiento del patrón de errores, no solo de la puntuación
Para decidir qué estudiar, la nota es insuficiente. Registre qué habilidades y tipos de elementos continúan generando un error, especialmente cuando el problema se repite en diferentes pruebas. La verdadera evolución aparece cuando empiezas a responder nuevas preguntas del mismo tipo, no solo cuando memorizas la corrección de un test anterior.
Si la plataforma clasifica la dificultad según parámetros o tasa de aciertos, esta información puede ayudar a separar los errores básicos de las lagunas más avanzadas. Pero mira cómo se definió la dificultad. "Difícil" podría significar un parámetro TRI alto, una tasa de aciertos baja en el grupo o simplemente una calificación editorial del proveedor.
¿Puedo comparar la puntuación de una prueba con otra?
La comparación es más fuerte cuando las dos aplicaciones pertenecen al mismo sistema, utilizan una metodología estable y tienen una estructura similar. Aun así, prefiera observar una serie de resultados, no una diferencia específica.
Entre diferentes proveedores, primero compare las métricas que requieren menos suposiciones: respuestas correctas por área, tiempo de prueba, preguntas en blanco y desempeño por contenido. Si ambos están presentes
tenga en cuenta que TRI solo trata los números como equivalentes cuando hay una explicación clara de cómo se vincularon las escalas con la referencia de Enem.
Si un proveedor utiliza parámetros oficiales de pruebas anteriores y otro utiliza su propia base de datos calibrada, ambos pueden producir estimaciones útiles, pero a través de caminos diferentes. El número final no debe tratarse como una unidad universal sólo porque aparece en un rango numérico similar al utilizado en las estimaciones de Enem.
¿Qué tal un objetivo como 700 puntos?
Los objetivos son útiles, pero la pregunta "¿cuántos aciertos necesito para 700?" No existe una respuesta única que se aplique a todas las áreas, cuestiones y patrones de respuesta. Una mejor manera de utilizar datos históricos es buscar la distribución de puntuaciones entre los participantes con totales cercanos a su objetivo y observar en qué parte de esa distribución aparece 700.
Esto convierte la portería en un campo de seguridad.. Si, en los datos históricos, un determinado total de aciertos aparece tanto por debajo como por encima de 700, sabrá que se encuentra en una zona de incertidumbre y que necesita aumentar el margen. Si unos totales ligeramente mayores concentran la mayor parte de la distribución por encima del objetivo, proporcionan un punto de referencia más conservador para la planificación.
Aun así, esta es una referencia histórica, no una garantía. La futura prueba tendrá otros ítems y otra composición. El objetivo es tomar mejores decisiones de estudio, no predecir una calificación oficial antes de que exista.
Lista de control final para confiar más - o menos - en la simulación IRT
¿El proveedor explica el origen de los artículos y parámetros?
En caso afirmativo, puedes valorar si la puntuación proviene de datos oficiales, de un banco calibrado o de una conversión estadística de respuestas correctas. Cuanto más rastreable sea el origen, mayores serán las posibilidades de auditoría.
¿Hay información sobre calibración y muestreo?
Una descripción mínima de población, volumen de respuestas y método de calibración muestra que la plataforma reconoce que la calidad de la medición depende de los datos utilizados para construir la escala.
¿La nota va acompañada de banda, error o distribución?
Los fajines comunican incertidumbre de manera más honesta. Un solo número puede ser práctico, pero no debe ocultar que la competencia estimada varía según el instrumento y el patrón de respuesta.
¿Es posible comparar ediciones desde la propia plataforma de forma coherente?
Para el seguimiento personal, la coherencia interna es más importante que la promesa de obtener exactamente la puntuación futura de Enem. Si el método cambia con cada edición, la serie histórica pierde valor.
¿La plataforma evita prometer equivalencias oficiales?
Una herramienta responsable diferencia las estimaciones de los resultados oficiales. El puntaje real del Enem es el calculado por el Inep a partir de las respuestas a la edición realizada. Cualquier valor anterior o externo debe ser tratado como una referencia, no como un reemplazo.
La regla general para no cometer errores con tu calificación
Utilice el TRI de la simulación para responder "¿Está mejorando mi tendencia?" y "¿en qué rango es probable que me encuentre dentro de este método?" No uses el número para decir "esta es la nota que obtendría hoy en Enem" sin conocer la metodología y la incertidumbre.
Para monitorear el progreso, combine los aciertos por área, el rango de calificaciones estimado, la coherencia del método entre aplicaciones y el análisis de errores. Para comparar proveedores, tenga cuidado con las equivalencias automáticas y busque evidencia de calibración y vinculación de escala. Y, cuando utilices datos oficiales del Inep para convertir hits en referencias, preserva la distribución: la pista cuenta la historia que un solo número borra.