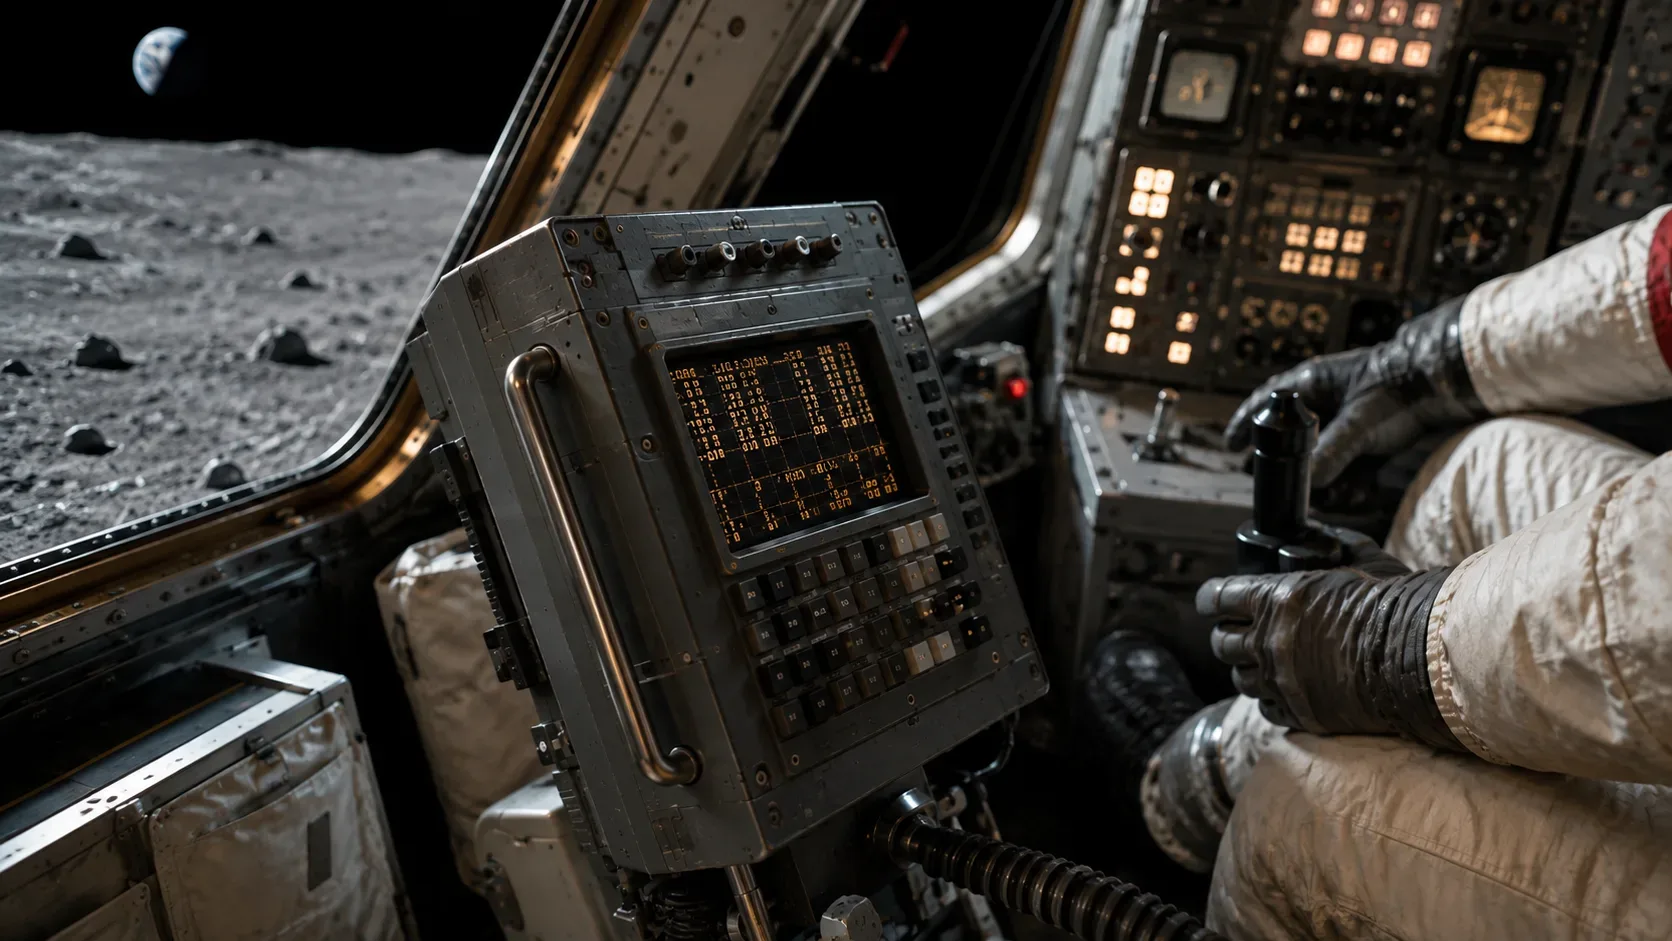
Apenas unos minutos antes del primer aterrizaje humano en la Luna, el 20 de julio de 1969, la computadora del módulo lunar Eagle comenzó a emitir alarmas inesperadas. Aparecieron los primeros 1202. Luego, otro 1202. Más cerca de la superficie, llegó el 1201 y el nuevo 1202. Hubo cinco apariciones durante el descenso. Neil Armstrong y Buzz Aldrin no tenían una respuesta preparada para esos códigos y pidieron a Houston una evaluación.
La respuesta breve a lo sucedido es esta: La computadora de guía Apollo estaba sobrecargada, pero no había dejado de funcionar. Su software detectó que le faltaban recursos para realizar todas las tareas, inició procedimientos de recuperación y reanudó el trabajo esencial. En Houston, los controladores siguieron la trayectoria, interpretaron las alarmas y concluyeron que el descenso aún podía continuar.
En la práctica, tres capas trabajaron juntas:
- la computadora recibió una carga de procesamiento mayor de la esperada;
- el software detectó el exceso, recuperó y conservó las funciones prioritarias;
- El equipo de Houston verificó que el sistema continuaba guiando correctamente al Eagle antes de autorizar que continuara el aterrizaje.
Es precisamente esta combinación la que hace que las alarmas 1201 y 1202 sean más interesantes que la versión simplificada de que "la computadora casi falla".
¿Qué significaron las alarmas 1201 y 1202
Los dos códigos pertenecían a la misma familia de problemas: un Executive overflow, es decir, una situación en la que el sistema ejecutivo del ordenador no podía reservar los recursos necesarios para iniciar otra tarea.
El software de Apollo trabajaba con áreas temporales de memoria asociadas con trabajos en ejecución. Entre ellos se encontraban los llamados conjuntos básicos y las áreas VAC, para acumulador vectorial. Cuando era necesario iniciar una nueva tarea, el sistema buscaba espacio disponible para ello.
Los códigos distinguían qué recurso se había agotado:
- 1201: no había área VAC disponible;
- 1202: no había ningún conjunto básico disponible para la nueva tarea.
El código fuente conservado del programa Luminary muestra 1201 asociado con la falta de áreas VAC y 1202 con la falta de conjuntos de núcleos. Esto es importante porque las cifras no describen una avería general de la computadora. Eran diagnósticos específicos que producía el sistema ejecutivo al reconocer que su cola de trabajo había superado una condición prevista.
Por qué la computadora estaba sobrecargada
Una explicación común es que el radar de encuentro estaba encendido y enviaba datos innecesarios a la computadora durante el aterrizaje. La idea básica es correcta, pero omite un detalle importante: encender este radar no fue simplemente un error de Armstrong o Aldrin.
En el informe técnico de la misión, los astronautas explicaron que el radar de encuentro se encendió según una configuración que se había utilizado en procedimientos y simulaciones. Mantenerlo disponible tenía sentido porque el equipo sería necesario si se abortara el descenso y el módulo lunar tuviera que reunirse con el módulo de comando Columbia.
Un análisis técnico adicional realizado por Don Eyles, uno de los ingenieros que programó el software de aterrizaje del módulo lunar en el Laboratorio de Instrumentación del MIT, fue más específico. Según él, había un problema no corregido en la interfaz con el radar de encuentro. Ciertas condiciones eléctricas hicieron que el sistema generara actividad innecesaria para la computadora, un fenómeno conocido como robo de ciclo. Eyles calculó que esto consumió aproximadamente el 13 % del tiempo de procesamiento disponible durante el descenso.
Trece por ciento parece poco si no se tiene en cuenta que el programa de aterrizaje ya utilizó gran parte de la capacidad disponible. La computadora continuó realizando sus tareas normales de navegación, guía, control y visualización mientras el sistema de radar consumía ciclos adicionales. Las tareas comenzaron a acumularse más rápido de lo que podían completarse.
Entonces surgieron las alarmas.
El detalle cambia la interpretación del episodio. No se trataba simplemente de “demasiados datos” en un sentido genérico o de que un astronauta presionara la tecla equivocada. Fue una interacción entre el hardware, la interfaz eléctrica, los procedimientos operativos y una máquina que ya estaba funcionando cerca de su límite previsto.
Qué hizo el software cuando le faltaba capacidad
Aquí es donde la historia deja de tratarse solo de las limitaciones de la computadora y se centra en la arquitectura del software.
La computadora de orientación Apollo utilizó un sistema ejecutivo basado en prioridades. No todo el trabajo era igualmente importante. Mantener la orientación, la navegación y el control de la nave espacial tenía prioridad sobre las tareas que podían posponerse o reiniciarse sin poner inmediatamente en riesgo el vehículo.
Cuando el ejecutivo encontró la condición que produjo un 1201 o 1202, no se quedó paralizado esperando por espacio. El software activó su mecanismo de recuperación, reinició la ejecución y reanudó programas seleccionados desde puntos de reinicio protegidos. Se devolvieron las tareas críticas; No era necesario reconstruir todos los trabajos que habían contribuido a llenar las colas de la misma manera.
Es más exacto decir que hubo reinicios controlados del software que decir que la computadora “falló y regresó”.
También es inexacto imaginar que la máquina tomó una decisión abstracta para “salvar el aterrizaje”. Los ingenieros habían definido y probado las prioridades y los mecanismos de recuperación. Durante la misión, el ordenador simplemente ejecutó esta arquitectura: detectó la falta de recursos, marcó el problema y reanudó la ejecución según reglas ya incorporadas en el sistema.
El resultado fue una forma temprana y sofisticada de degradación controlada. Cuando se enfrentaba a una carga excesiva, el sistema no necesitaba tratar cada función como igualmente indispensable.
¿Dónde entra Margaret Hamilton en esta historia?
La contribución de Margaret Hamilton debe explicarse sin convertir un esfuerzo colectivo en el trabajo de una sola persona.
En 1969, el desarrollo del software de vuelo Apollo se llevó a cabo en el Laboratorio de Instrumentación del MIT, institución que luego se convirtió en el Laboratorio Charles Stark Draper.. Hamilton dirigió la División de Ingeniería de Software del laboratorio y el equipo responsable del software integrado para los módulos lunares y de comando.
La NASA destacó posteriormente entre sus aportaciones y las de su equipo conceptos relacionados con software asíncrono, programación de prioridades, pruebas de extremo a extremo y mecanismos capaces de afrontar situaciones inesperadas durante la misión.
Esto no significa que Hamilton escribió personalmente cada rutina asociada con las alarmas 1201 y 1202. El software Apollo fue el resultado del trabajo de muchos ingenieros. Don Eyles escribió partes clave del programa de descenso; Peter Adler trabajó en los programas de vuelo del módulo lunar; otros expertos desarrollaron el ejecutivo, las rutinas de reinicio, la navegación, la orientación y las interfaces.
El papel de Hamilton se entiende más correctamente como el liderazgo de una organización de software que necesitaba entregar un sistema integrado capaz de operar en tiempo real, con recursos extremadamente limitados y sin posibilidad de mantenimiento físico durante una misión lunar.
Las alarmas del Apolo 11 terminaron proporcionando una demostración concreta de por qué los mecanismos de detección y recuperación eran tan importantes.
Lo que Houston tuvo que decidir en apenas unos segundos
Un buen mecanismo de recuperación no fue suficiente. Armstrong y Aldrin aún necesitaban saber si la alarma permitía continuar el aterrizaje.
Después del primer 1202, Armstrong le pidió a Houston una interpretación. Unos segundos después, CAPCOM Charlie Duke transmitió la autorización para continuar. El audio y la transcripción de la misión registran la rápida transición entre la solicitud de la tripulación y la respuesta de que el vuelo estaba autorizado a proceder ante esa alarma.
Detrás de la breve comunicación había una cadena de decisiones.
Jack Garman, un ingeniero de la NASA que apoya al equipo de orientación, había preparado una lista de posibles alarmas informáticas. Cuando Steve Bales, encargado de orientación en la sala de control, recibió 1202, Garman reconoció la condición como una sobrecarga temporal que, en ese contexto, no requería automáticamente un aborto.
Bales combinó esta información con lo que los controladores observaron en telemetría: la trayectoria se mantuvo coherente y el sistema de guía siguió funcionando. La recomendación pasó por la estructura de control de vuelo y Duke transmitió el “adelante” a Eagle.
Cuando apareció 1201, la reacción fue aún más rápida porque Houston ya sabía que se trataba del mismo tipo general de sobrecarga. La transcripción registra la confirmación casi inmediata de que la tripulación podía continuar.
Esto ayuda a corregir otra simplificación: Houston no ignoró la alarma porque confiaba ciegamente en la computadora. Los controladores aceptaron la continuación porque comprendieron la importancia de la condición y, al mismo tiempo, observaron que los parámetros esenciales del aterrizaje permanecían normales.
Buzz Aldrin también redujo la carga durante el descenso
La tripulación no se limitó a esperar decisiones desde tierra.
Después de uno de los 1202, Aldrin notó que las alarmas parecían coincidir con una solicitud de una pantalla de computadora en particular, el comando Verb 16 Noun 68. Esta pantalla presentaba información útil para el descenso, pero agregaba otra pequeña demanda a un sistema ya sobrecargado.
En lugar de insistir en la consulta, parte del seguimiento comenzó a realizarse sobre el terreno. Houston podría proporcionar la información que la tripulación necesitaba sin requerir la misma interacción con esa pantalla durante el momento crítico.
Este cambio no eliminó la causa raíz del problema, que seguía relacionada con la interfaz del radar, pero sí redujo una demanda evitable mientras se gestionaban las alarmas.
Armstrong tuvo que lidiar con la computadora y el terreno al mismo tiempo
Las alarmas tuvieron una consecuencia operativa que va más allá de la electrónica: consumieron la atención de la tripulación.
En la sesión informativa posterior, Armstrong explicó que el período en el que normalmente evaluaría más intensivamente el terreno y el punto de aterrizaje estaba parcialmente ocupado por la necesidad de monitorear las alarmas, confirmar que el vehículo seguía siendo controlable y evaluar si sería necesario abortar.
Cuando finalmente pudo prestar más atención al exterior, Armstrong se dio cuenta de que el punto al que los llevaba el sistema estaba cerca de una zona cubierta por rocas y un gran cráter. Luego tomó un mayor control sobre la fase final del descenso, entró en el programa P66 y guió al Eagle más allá del terreno inadecuado antes de aterrizar.
Esta actuación también encaja en una trayectoria que comenzó mucho antes del Apolo 11. Armstrong tenía experiencia en ingeniería aeronáutica, trabajó como investigador y piloto de pruebas para NACA/NASA y participó tanto en los aspectos de pilotaje como de ingeniería de programas como el X-15. La formación técnica de Neil Armstrong ayuda a comprender por qué pudo tratar una máquina experimental no sólo como piloto, sino como parte de un sistema que necesitaba ser evaluado constantemente. Este viaje previo es el tema del artículo relacionado “Neil Armstrong antes de la Luna”.
Esto no disminuye el papel de la computadora ni de Houston. Al contrario: el aterrizaje funcionó porque diferentes responsabilidades permanecían conectadas. La máquina realizaba orientación y control; Aldrin monitoreó instrumentos y computadoras; Armstrong evaluó el vuelo y el terreno; Houston vio la telemetría y reunió a expertos que sabían lo que significaban las alarmas.
El problema se entendió antes de que el Águila abandonara la Luna
El trabajo técnico no terminó cuando el módulo lunar aterrizó.
Después del aterrizaje, equipos de la NASA y el MIT investigaron el origen de la sobrecarga. El comportamiento del radar de encuentro se convirtió en una de las principales pistas. Antes del despegue desde la superficie lunar, Houston cambió los procedimientos para evitar que el mismo tipo de carga afectara a la computadora durante el ascenso. Entre las instrucciones dadas a la tripulación estaba la de mantener abiertos los disyuntores del radar de encuentro en los momentos en que su operación no fuera necesaria.
La respuesta, por lo tanto, se produjo en dos etapas. Durante el aterrizaje, la prioridad era si Eagle podía continuar con seguridad. Después del aterrizaje, la prioridad pasó a comprender la causa y evitar que reapareciera en el despegue.
Lo que realmente demostraron las alarmas 1201 y 1202
El Apolo 11 no llegó a la Luna porque su computadora nunca encontró ningún problema. Llegó a pesar de un problema porque diferentes capas del sistema fueron capaces de detectarlo, absorberlo y tomar decisiones coherentes.
El hardware tenía límites claros. La interfaz del radar logró consumir una parte inesperada del procesamiento. El software reconoció que sus recursos de ejecución se habían agotado y desencadenó la recuperación prevista por los ingenieros. Houston supo interpretar estas señales en contexto. Armstrong y Aldrin continuaron evaluando si el barco seguía respondiendo como debería.
Por tanto, los códigos 1201 y 1202 no son sólo una curiosidad en la historia de la informática. Muestran una idea que sigue siendo central para los sistemas críticos:no basta con intentar prevenir todos los fallos; También es necesario diseñar el sistema para reconocer condiciones anormales, preservar el trabajo esencial y permitir que personas calificadas decidan qué hacer a continuación.
En el aterrizaje del Apolo 11, esto es exactamente lo que sucedió.