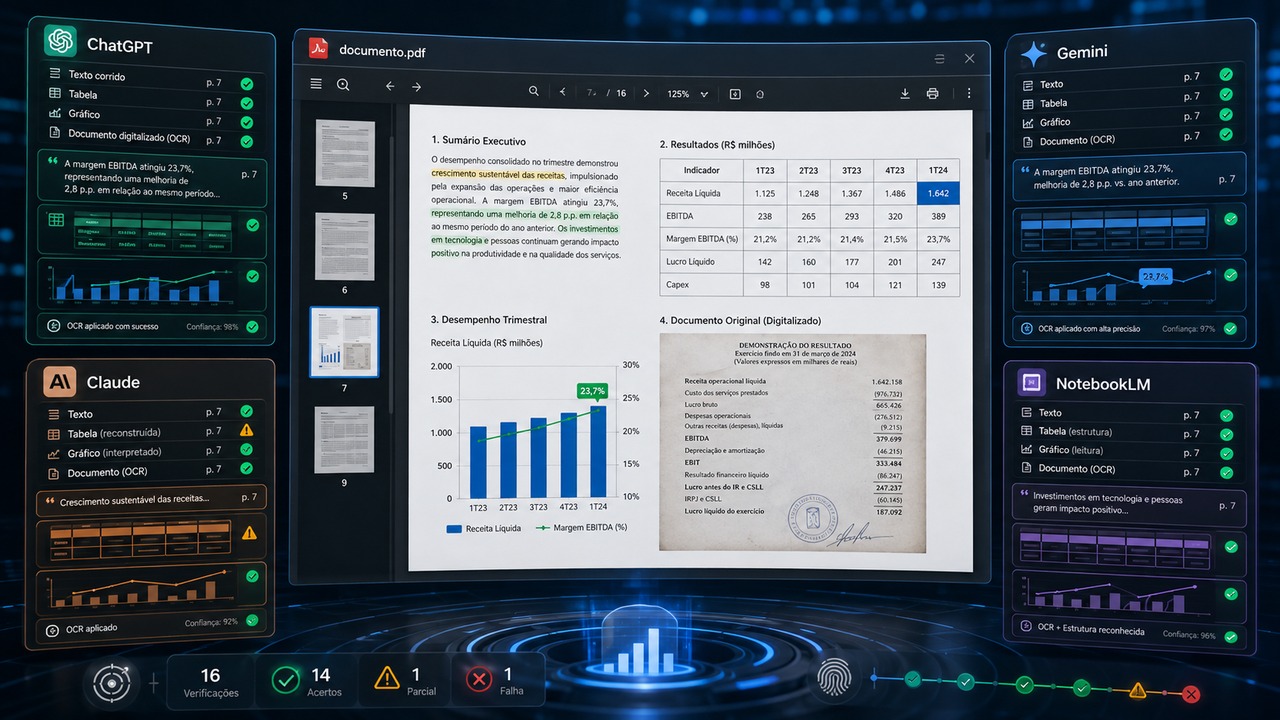
A pergunta “qual IA analisa melhor PDFs?” parece simples, mas costuma ser respondida com o critério errado. Aceitar upload de PDF não significa enxergar tudo o que existe nele, localizar a evidência correta nem resistir à tentação de completar uma lacuna com uma resposta plausível. Para comparar ChatGPT, Claude, Gemini e NotebookLM de forma útil, o teste precisa separar leitura de texto, leitura visual, OCR, reconstrução de tabelas, localização de páginas e controle de alucinações.
Em 17 de agosto de 2026, a própria documentação das quatro plataformas já mostra diferenças que mudam o resultado antes mesmo de qualquer pergunta. Por isso, não é correto declarar uma campeã universal sem rodar os mesmos arquivos, prompts e critérios nas mesmas condições. O caminho mais confiável é usar um benchmark reproduzível, registrar plano, modelo e data do teste e publicar também as respostas brutas, não apenas um placar final.
O primeiro corte é entender que nem todo PDF é o mesmo problema
Um PDF com texto digital permite que uma ferramenta extraia caracteres e procure trechos sem necessariamente “olhar” para a página. Já um PDF escaneado pode ser apenas uma coleção de imagens. Tabelas, gráficos, diagramas, carimbos e anotações também podem carregar informação que desaparece se o sistema trabalhar somente com texto extraído.
Essa distinção explica por que uma IA pode acertar perfeitamente a resposta a uma pergunta sobre um parágrafo e falhar no gráfico da página seguinte. Não é contradição: pode ser diferença no modo de ingestão do arquivo. Um benchmark que mistura tudo em uma única nota, sem separar texto e visão, esconde justamente o tipo de falha que o
leitor precisa conhecer.
O que a documentação atual já obriga a controlar no teste
ChatGPT: o plano e o modo de anexar o PDF mudam o que pode ser visto
A documentação da OpenAI informa que o ChatGPT aceita uploads de documentos e que arquivos de texto e documentos têm um limite de 2 milhões de tokens por arquivo, além do limite duro de 512 MB por arquivo. O ponto mais importante para este comparativo, porém, é visual: a recuperação visual de elementos incorporados em PDFs é documentada como recurso do ChatGPT Enterprise.
Fora dessa condição, a documentação diz que o processamento de documentos é baseado em texto e que imagens incorporadas são descartadas. Há ainda uma diferença de fluxo dentro do próprio Enterprise: PDFs usados como arquivos de projeto ou conhecimento de GPT são processados por recuperação textual, enquanto PDFs enviados pelo usuário durante a conversa podem usar recuperação visual. Assim, um teste sério precisa registrar não apenas “ChatGPT”, mas também o plano e o caminho de upload.
Claude: PDFs curtos e longos entram por caminhos diferentes
A Anthropic documenta que Claude pode analisar texto e elementos visuais de PDFs com até 100 páginas. Entre 101 e 1000 páginas, o processamento passa a ser somente textual. A plataforma também orienta que, ao pedir localização, o usuário se refira ao número de página mostrado pelo visualizador do PDF, e não ao número impresso dentro do documento.
Isso cria dois controles essenciais. O primeiro é manter o PDF visual abaixo de 100 páginas quando a prova depende de gráfico, imagem ou página escaneada. O segundo é definir antecipadamente qual numeração vale no gabarito. Sem isso, uma resposta pode estar semanticamente correta e ainda parecer errada porque o documento chama de “página 1” algo que o arquivo PDF considera página 7.
Gemini: é preciso separar o aplicativo da capacidade documentada na API
Nos Apps do Gemini, o Google documenta upload e análise de documentos, com até 10 arquivos no mesmo comando quando o recurso está disponível e limite de 100 MB para cada arquivo aceito que não seja vídeo. A própria ajuda alerta que arquivos muito grandes podem produzir respostas com menos correlações ou detalhes quando o conteúdo ultrapassa a janela de contexto disponível.
Na Gemini API, a documentação técnica é mais explícita sobre PDF multimodal: o Google descreve visão nativa capaz de analisar texto, imagens, diagramas, gráficos e tabelas em documentos de até 1000 páginas. Essa é uma capacidade importante, mas não autoriza tratar “Gemini Apps” e “Gemini API” como se fossem exatamente o mesmo produto. O benchmark deve escolher uma superfície e permanecer nela do começo ao fim.
NotebookLM: a rastreabilidade é parte do produto, mas não substitui o gabarito
O NotebookLM trabalha a partir das fontes selecionadas no notebook. A documentação do Google informa que o chat usa trechos, texto e imagens das próprias fontes como citações e permite navegar da citação para o contexto original. Também registra limite de até 500 mil palavras por fonte ou 200 MB para uploads locais, sem limite de páginas declarado, e informa que PDFs protegidos contra cópia podem falhar na importação.
Essa arquitetura torna a rastreabilidade especialmente fácil de medir: não basta perguntar se a resposta está certa; é possível verificar se a citação realmente sustenta a frase. Ainda assim, citação não é sinônimo de acurácia. Uma resposta pode apontar para um trecho real e interpretar esse trecho de forma errada. No benchmark, “resposta correta” e “evidência correta” precisam receber notas separadas.
Por que um ranking simples costuma premiar a coisa errada
Comparações de vitrine frequentemente medem se a ferramenta aceitou o arquivo, gerou um resumo convincente e respondeu algumas perguntas óbvias. Isso favorece fluência. O problema é que o usuário que consulta um relatório financeiro, um edital, um paper ou um manual técnico geralmente precisa de outra coisa: precisão verificável.
Uma ferramenta pode soar excelente e ainda trocar uma linha de tabela, confundir um valor absoluto com percentual, indicar a página errada ou inventar um dado ausente. Outra pode ser mais cautelosa, responder menos e obter melhor taxa de acerto. Se o objetivo é confiabilidade, uma omissão consciente pode ser preferível a uma resposta completa e errada.
Como montar um PDF de benchmark que tenha gabarito de verdade
O melhor arquivo de teste é sintético. Isso evita direitos autorais, permite publicar o material completo e dá controle sobre cada resposta. Em vez de usar um relatório real e discutir depois qual interpretação estava correta, crie um documento fictício com números, textos, tabelas e gráficos desenhados especificamente para o teste.
Um exemplo pode ter 24 páginas. As primeiras páginas trazem texto digital normal, com fatos distribuídos em seções diferentes. Em seguida entram tabelas com cabeçalhos parecidos e valores próximos. Depois aparecem gráficos que contêm informação não repetida no texto. As páginas finais reproduzem o mesmo universo fictício como digitalizações, com pequenas rotações, ruído leve e contraste reduzido para testar OCR sem transformar o arquivo em uma armadilha impossível.
O conteúdo deve incluir valores deliberadamente semelhantes. Por exemplo, uma margem de 23,7%, uma melhora de 2,8 pontos percentuais e uma receita de 1.642 unidades podem aparecer em contextos diferentes. Isso obriga o sistema a distinguir unidade, período e métrica, em vez de simplesmente encontrar o número que parece combinar com a pergunta.
Também vale inserir perguntas cuja resposta correta seja “não consta no documento”. Esse é um dos testes mais informativos, porque mede se a ferramenta reconhece a ausência de evidência ou fabrica uma continuação provável.
As perguntas precisam medir habilidades diferentes
Extração factual
Faça perguntas cuja resposta esteja literalmente no texto digital e peça o valor, a unidade e o período. A pontuação deve cair se a IA acertar o número, mas errar a unidade ou o contexto. Esse bloco mede a capacidade mais básica e serve como controle: se a ferramenta falha aqui, qualquer análise mais sofisticada precisa ser interpretada com cautela.
Localização de página e trecho
Peça a resposta acompanhada da página do arquivo PDF e do título da seção. Defina no enunciado que “página” significa a posição mostrada no visualizador, começando na primeira página física do arquivo. Isso reduz a ambiguidade entre paginação impressa e paginação do PDF.
O teste deve verificar se a localização é exata, não apenas próxima. Uma ferramenta que responde corretamente mas aponta para a página errada dificulta auditoria e aumenta o custo de revisão humana.
Reconstrução de tabela
Escolha uma tabela em que linhas e colunas tenham nomes parecidos. Peça somente um subconjunto, como três indicadores em dois períodos, e determine uma ordem fixa para a saída. O gabarito deve conferir célula por célula.
A falha mais perigosa não é uma tabela incompleta; é a tabela visualmente organizada com células deslocadas. Por isso, o placar deve distinguir omissão de valor e associação errada entre linha, coluna e número.
Leitura de gráfico
Inclua pelo menos um gráfico em que a conclusão não possa ser recuperada do texto ao redor. Pergunte qual série atinge o maior valor, em que período isso ocorre e qual relação visual existe entre duas séries. Assim, uma ferramenta que só extrai texto não consegue passar no teste por coincidência.
Esse bloco é especialmente útil para revelar diferenças de plano e de modo de processamento. Se o sistema não recebe as imagens incorporadas ao PDF, o resultado deve ser marcado como limitação de entrada, não como simples erro de raciocínio.
OCR em página escaneada
Crie uma página sem camada de texto pesquisável e confirme isso antes do teste. A pergunta deve exigir a leitura de uma frase e de um número presentes apenas na imagem. Faça uma segunda versão com leve inclinação ou ruído para medir robustez.
O gabarito deve considerar caracteres, acentos, separadores decimais e sinais negativos.
Uma leitura “quase certa” pode ser inútil em documentos legais ou financeiros, então o critério precisa ser mais rigoroso do que em um resumo narrativo.
Controle de alucinação
Inclua perguntas plausíveis sobre informações que não existem no arquivo. A resposta ideal é reconhecer a ausência e, quando possível, indicar quais elementos relacionados foram encontrados. Inventar um valor, uma data ou uma conclusão deve receber a penalidade mais alta do benchmark.
Esse teste impede que uma ferramenta ganhe pontos apenas por responder sempre. Em análise documental, recusar uma conclusão sem evidência pode ser sinal de confiabilidade, não de fraqueza.
Uma rubrica simples torna o resultado auditável
Cada pergunta pode receber 0, 1 ou 2 pontos. Zero significa resposta errada, inventada ou incompatível com a evidência. Um ponto significa resposta parcialmente correta, com omissão ou localização imprecisa. Dois pontos significam resposta correta, completa dentro do pedido e rastreável ao gabarito.
Para evitar que perguntas fáceis dominem a nota, o resultado final pode ser ponderado. Uma distribuição razoável para este tipo de teste é 40% para acurácia factual, 20% para rastreabilidade de página e trecho, 15% para tabelas, 15% para leitura visual e OCR e 10% para controle de alucinação. Os pesos são uma escolha editorial do benchmark e devem ser publicados junto com o resultado.
Também é importante repetir cada pergunta. Três execuções independentes por ferramenta ajudam a revelar respostas instáveis. O placar pode usar a média das três rodadas e registrar, à parte, quantas vezes a resposta mudou de correta para incorreta sem alteração no prompt.
As condições do teste precisam ser mais rígidas do que o placar
Cada ferramenta deve começar em uma conversa ou notebook novo, sem histórico relacionado ao benchmark. O mesmo arquivo deve ser enviado diretamente pela superfície que está sendo avaliada. Pesquisa na web, conectores, memória de conversas anteriores e ferramentas externas devem permanecer desativados quando a tarefa for responder exclusivamente a partir do PDF.
O prompt deve ser idêntico sempre que as interfaces permitirem. Não vale corrigir a ferramenta depois de uma resposta ruim e comparar essa segunda tentativa com a primeira tentativa das concorrentes. Se houver uma rodada de reparo, ela deve ser uma etapa separada e aplicada às quatro.
Registre data, plano, nome do modelo quando ele for visível, plataforma usada, caminho de upload e qualquer configuração relevante. Produtos de IA mudam rapidamente; sem esses metadados, um resultado publicado hoje pode ser impossível de reproduzir alguns meses depois.
O que publicar para o benchmark ser realmente reproduzível
O pacote público deve conter o PDF original, o gabarito, o conjunto de perguntas, a rubrica, o peso de cada critério e o hash do arquivo testado. Também deve guardar as respostas brutas das ferramentas, sem reescrita editorial, além do placar calculado a partir delas.
Quando uma ferramenta não consegue processar um componente por limitação documentada do plano ou do fluxo escolhido, isso deve aparecer como resultado. Não substitua o PDF por imagens avulsas apenas para uma concorrente, a menos que exista uma segunda categoria explicitamente chamada de “melhor resultado com preparação manual”. Misturar condições transforma o benchmark em demonstração, não comparação.
O que dá para concluir antes de rodar o placar
A documentação já permite formular hipóteses, mas não coroar uma vencedora. Em PDFs visuais, um ChatGPT fora do fluxo Enterprise com recuperação visual parte de uma condição diferente porque a documentação diz que imagens incorporadas são descartadas no processamento textual. Claude documenta análise visual até 100 páginas e processamento textual em PDFs maiores. O Gemini tem documentação técnica de visão nativa de PDFs na API, enquanto os Apps do Gemini têm limites e contexto próprios que precisam ser testados separadamente. O NotebookLM oferece uma camada de citações e navegação para a fonte que facilita auditar a resposta.
Essas diferenças sugerem que haverá vencedores por tarefa, não necessariamente uma ferramenta dominante em tudo. Um sistema pode liderar em rastreabilidade e ficar atrás na reconstrução de uma tabela escaneada; outro pode interpretar gráficos muito bem e ser menos consistente na localização de páginas. O benchmark precisa preservar essas dimensões em vez de escondê-las em uma única nota.
Como escolher uma IA para o seu PDF sem esperar pelo benchmark completo
Comece identificando o tipo de documento. Se tudo é texto digital, faça cinco perguntas difíceis e verificáveis em trechos distantes do arquivo. Se há gráficos, páginas escaneadas ou tabelas visuais, confirme primeiro se o plano e o fluxo usados realmente processam esses elementos.
Depois, peça sempre evidência. Solicite página, seção e trecho de apoio, e abra o PDF para conferir. Faça pelo menos uma pergunta cuja resposta você já conhece e outra sobre algo que não consta no documento. Essa pequena prova não substitui um benchmark, mas detecta rapidamente ferramentas que respondem com confiança maior do que a evidência permite.
No fim, a melhor IA para PDF não é a que produz o resumo mais elegante. É a que acerta mais no seu tipo de documento, erra de forma detectável e mostra a origem da resposta. Sem isso, “aceita PDF” é recurso de interface, não medida de confiabilidade.