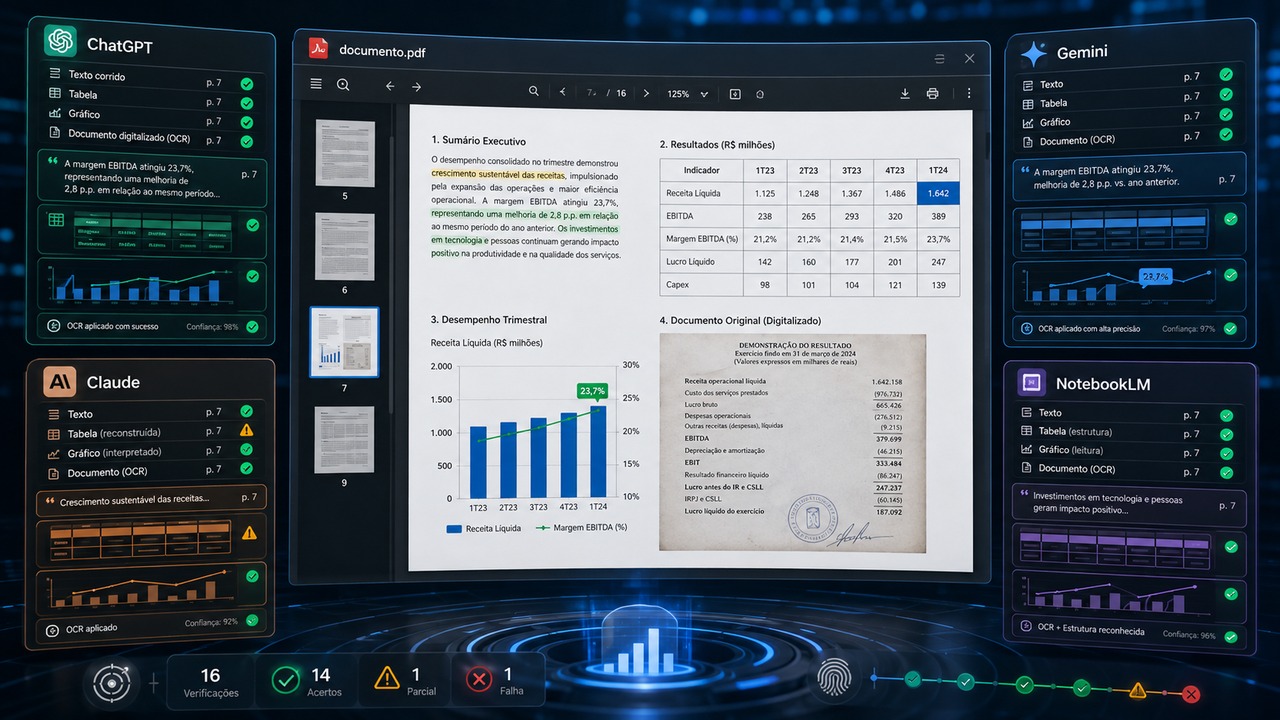
La pregunta "¿qué IA analiza mejor los archivos PDF?" Parece sencillo, pero muchas veces se responde con criterios equivocados. Aceptar la carga de un PDF no significa ver todo lo que contiene, localizar la evidencia correcta o resistir la tentación de llenar un vacío con una respuesta plausible. Para comparar ChatGPT, Claude, Gemini y NotebookLM de manera útil, la prueba debe separar la lectura de texto, la lectura visual, el OCR, la reconstrucción de tablas, la localización de páginas y el control de alucinaciones.
El 17 de agosto de 2026, la documentación de las cuatro plataformas ya muestra diferencias que cambian el resultado incluso antes de que se hagan preguntas. Por lo tanto, no es correcto declarar un campeón universal sin ejecutar los mismos archivos, indicaciones y criterios en las mismas condiciones. El camino más confiable es utilizar un punto de referencia reproducible, registrar el plan de prueba, el modelo y la fecha, y publicar también las respuestas sin procesar, no solo una puntuación final.
El primer corte es entender que no todos los PDF tienen el mismo problema
Un PDF con texto digital permite a una herramienta extraer caracteres y buscar pasajes sin necesariamente “mirar” la página. Un PDF escaneado puede ser simplemente una colección de imágenes. Tablas, gráficos, diagramas, sellos y notas también pueden contener información que desaparece si el sistema funciona sólo con texto extraído.
Esta distinción explica por qué una IA puede obtener la respuesta perfectamente correcta a una pregunta en un párrafo y fallar en el gráfico de la página siguiente. No es una contradicción: podría haber una diferencia en la forma en que se ingiere el archivo. Un referente que mezcla todo en una sola nota, sin separar texto y visión, esconde precisamente el tipo de defecto que tiene el
el lector necesita saberlo.
Lo que la documentación actual ya requiere que controles en la prueba
ChatGPT: el plan y forma de adjuntar el PDF cambia lo que se ve
La documentación de OpenAI establece que ChatGPT acepta cargas de documentos y que los archivos de texto y documentos tienen un límite de 2 millones de tokens por archivo, además del límite estricto de 512 MB por archivo. Sin embargo, el punto más importante de esta comparación es visual: la recuperación visual de elementos incrustados en archivos PDF está documentada como una característica de ChatGPT Enterprise.
Aparte de esta condición, la documentación dice que el procesamiento de documentos se basa en texto y que las imágenes incrustadas se descartan. También hay una diferencia en el flujo dentro de la propia Enterprise: los PDF utilizados como archivos de proyecto o conocimiento GPT se procesan mediante recuperación textual, mientras que los PDF enviados por el usuario durante la conversación pueden utilizar la recuperación visual. Por lo tanto, una prueba seria debe registrar no solo “ChatGPT” sino también el plan y la ruta de carga.
Claude: Los PDF cortos y largos se presentan de diferentes maneras
Documentos antrópicos que Claude puede analizar texto y elementos visuales desde archivos PDF de hasta 100 páginas. Entre 101 y 1000 páginas, el procesamiento pasa a ser únicamente textual. La plataforma también advierte que, al solicitar la ubicación, el usuario haga referencia al número de página que muestra el visor de PDF, y no al número impreso en el interior del documento.
Esto crea dos controles esenciales. La primera es mantener el PDF visual por debajo de 100 páginas cuando la prueba depende de un gráfico, imagen o página escaneada.. La segunda es definir de antemano qué número es válido en la plantilla. Sin esto, una respuesta podría ser semánticamente correcta y aun así parecer incorrecta porque el documento llama "página 1" algo que el archivo PDF considera página 7.
Gemini: necesitas separar la aplicación de las capacidades documentadas en la API
En Gemini Apps, Google carga y analiza documentos, con hasta 10 archivos en el mismo comando cuando la función está disponible y un límite de 100 MB para cada archivo aceptado que no sea video. La propia ayuda advierte que los archivos muy grandes pueden producir respuestas con menos correlaciones o detalles cuando el contenido excede la ventana de contexto disponible.
En la API de Gemini, la documentación técnica es más explícita sobre el PDF multimodal: Google describe una visión nativa capaz de analizar texto, imágenes, diagramas, gráficos y tablas en documentos de hasta 1000 páginas. Esta es una capacidad importante, pero no autoriza a tratar las “Aplicaciones Gemini” y la “API Gemini” como si fueran exactamente el mismo producto. El referente debe elegir una superficie y permanecer en ella de principio a fin.
NotebookLM: la trazabilidad es parte del producto, pero no reemplaza la plantilla
NotebookLM funciona con las fuentes seleccionadas en el cuaderno. La documentación de Google afirma que el chat utiliza extractos, texto e imágenes de las propias fuentes como citas y le permite navegar desde la cita hasta el contexto original. También registra un límite de hasta 500.000 palabras por fuente o 200 MB para cargas locales, sin límite de páginas declarado, e informa que los archivos PDF protegidos contra copia pueden no importarse.
Esta arquitectura hace que la trazabilidad sea especialmente fácil de medir: no basta con preguntar si la respuesta es correcta; es posible comprobar si la cita realmente respalda la oración. Aún así, citar no es sinónimo de precisión. Una respuesta puede apuntar a un fragmento real y malinterpretarlo. En el punto de referencia, la "respuesta correcta" y la "evidencia correcta" deben calificarse por separado.
Por qué una simple clasificación a menudo recompensa lo incorrecto
Las comparaciones de productos a menudo miden si la herramienta aceptó el archivo, generó un resumen convincente y respondió algunas preguntas obvias. Esto promueve la fluidez. El problema es que el usuario que consulta un informe financiero, un aviso, un documento o un manual técnico generalmente necesita algo más: exactitud verificable.
Una herramienta puede parecer excelente y aún así cambiar una línea de tabla, confundir un valor absoluto con un porcentaje, indicar la página incorrecta o inventar datos faltantes. Otro puede ser más cauteloso, responder menos y obtener una mayor tasa de éxito. Si el objetivo es la confiabilidad, una omisión consciente puede ser preferible a una respuesta completa e incorrecta.
Cómo crear un PDF de referencia que tenga una respuesta real
El mejor archivo de prueba es el sintético. Esto evita derechos de autor, te permite publicar el material completo y te da control sobre cada respuesta. En lugar de utilizar un informe real y discutir después qué interpretación fue la correcta, cree un documento ficticio con números, texto, tablas y gráficos diseñados específicamente para la prueba.
Un ejemplo puede tener 24 páginas. Las primeras páginas presentan texto digital normal, con hechos distribuidos en diferentes secciones. Luego, aparecen tablas con encabezados similares y valores similares.. Luego aparecen gráficos que contienen información no repetida en el texto. Las páginas finales reproducen el mismo universo ficticio que los escaneos, con pequeñas rotaciones, ligero ruido y contraste reducido para probar el OCR sin convertir el archivo en una trampa imposible.
El contenido debe incluir valores deliberadamente similares. Por ejemplo, un margen del 23,7%, una mejora de 2,8 puntos porcentuales y unos ingresos de 1.642 unidades pueden aparecer en diferentes contextos. Esto obliga al sistema a distinguir entre unidad, período y métrica, en lugar de simplemente encontrar el número que parece coincidir con la pregunta.
También vale la pena insertar preguntas cuya respuesta correcta sea “no incluida en el documento”. Esta es una de las pruebas más informativas, porque mide si la herramienta reconoce la ausencia de evidencia o fabrica una continuación probable.
Las preguntas deben medir diferentes habilidades
Extracción de hechos
Haz preguntas cuya respuesta esté literalmente en el texto digital y pregunta por el valor, unidad y período. La puntuación debería bajar si la IA acierta el número pero se equivoca en la unidad o el contexto. Este bloque mide la capacidad más básica y sirve como control: si la herramienta falla aquí, cualquier análisis más sofisticado debe interpretarse con cautela.
Ubicación de la página y del extracto
Solicite la respuesta acompañada de la página del archivo PDF y el título de la sección. Defina en la declaración que “página” significa la posición que se muestra en el visor, comenzando desde la primera página física del archivo. Esto reduce la ambigüedad entre la paginación impresa y la paginación de PDF.
La prueba debe verificar que la ubicación sea precisa, no solo cercana. Una herramienta que responde correctamente pero apunta a la página incorrecta dificulta la auditoría y aumenta el costo de la revisión humana.
Reconstrucción de mesa
Elija una tabla en la que las filas y columnas tengan nombres similares. Ordene sólo un subconjunto, como tres indicadores en dos períodos, y determine un orden fijo para el resultado. La plantilla debe comprobarse celda por celda.
El defecto más peligroso no es una tabla incompleta; es la tabla visualmente organizada con celdas desplazadas. Por tanto, el marcador debe distinguir la omisión de valor y la asociación errónea entre línea, columna y número.
Lectura de gráficos
Incluya al menos un gráfico donde la conclusión no se pueda recuperar del texto circundante. Pregunte qué serie alcanza el valor más alto, en qué periodo ocurre y qué relación visual existe entre dos series. Por lo tanto, una herramienta que solo extrae texto no puede pasar la prueba por coincidencia.
Este bloque es especialmente útil para revelar diferencias en el plan y el modo de procesamiento. Si el sistema no recibe las imágenes incrustadas en el PDF, el resultado debe marcarse como una limitación de entrada, no como un simple error de razonamiento.
OCR en página escaneada
Cree una página sin una capa de texto con capacidad de búsqueda y confírmela antes de realizar la prueba. La pregunta debe requerir la lectura de una frase y un número presente únicamente en la imagen. Haga una segunda versión con una ligera inclinación o ruido para medir la robustez.
La plantilla debe considerar caracteres, acentos, separadores decimales y signos negativos.
Una lectura “casi segura” puede resultar inútil en documentos legales o financieros, por lo que los criterios deben ser más rigurosos que en un resumen narrativo.
Control de alucinaciones
Incluya preguntas plausibles sobre información que no existe en el expediente. La respuesta ideal es reconocer la ausencia y, cuando sea posible, indicar qué elementos relacionados se encontraron. Inventar un valor, una fecha o una conclusión debería recibir la penalización de referencia más alta.
Esta prueba evita que una herramienta gane puntos solo por responder siempre. En el análisis de documentos, rechazar una conclusión sin evidencia puede ser un signo de confiabilidad, no de debilidad.
Una rúbrica simple hace que el resultado sea auditable
Cada pregunta puede recibir 0, 1 o 2 puntos. Cero significa respuesta incorrecta, inventada o incompatible con la evidencia. Un punto significa una respuesta parcialmente correcta, con omisión o ubicación imprecisa. Dos puntos significan una respuesta correcta, completa dentro de la solicitud y rastreable hasta la clave de respuestas.
Para evitar que las preguntas fáciles dominen la calificación, se puede ponderar el resultado final. Una distribución razonable para este tipo de prueba es 40% para precisión fáctica, 20% para trazabilidad de páginas y extractos, 15% para tablas, 15% para lectura visual y OCR, y 10% para control de alucinaciones. Las ponderaciones son una elección editorial del benchmark y deben publicarse junto con el resultado.
También es importante repetir cada pregunta. Tres ejecuciones independientes por herramienta ayudan a revelar respuestas inestables. El marcador puede utilizar el promedio de las tres rondas y registrar, por separado, cuántas veces la respuesta cambió de correcta a incorrecta sin cambiar la indicación.
Las condiciones de la prueba deben ser más estrictas que el marcador
Cada herramienta debe comenzar en una nueva conversación o cuaderno, sin historial relacionado con el punto de referencia. El mismo archivo deberá ser enviado directamente por la superficie a evaluar. La búsqueda web, los conectores, la memoria de conversaciones anteriores y las herramientas externas deben permanecer deshabilitadas al responder exclusivamente desde el PDF.
El mensaje debe ser idéntico siempre que las interfaces lo permitan. No vale la pena corregir la herramienta después de una mala respuesta y comparar este segundo intento con el primer intento de los competidores. Si hay una ronda de reparación, debe ser un paso separado y aplicarse a los cuatro.
Registre la fecha, el plan, el nombre del modelo cuando esté visible, la plataforma utilizada, la ruta de carga y cualquier configuración relevante. Los productos de IA cambian rápidamente; Sin estos metadatos, un resultado publicado hoy puede ser imposible de reproducir unos meses después.
Qué publicar para que el benchmark sea verdaderamente reproducible
El paquete público debe contener el PDF original, la clave de respuestas, el conjunto de preguntas, la rúbrica, el peso de cada criterio y el hash del archivo probado. También debes guardar las respuestas sin procesar de las herramientas, sin reescritura editorial, además de la puntuación calculada a partir de ellas.
Cuando una herramienta no puede procesar un componente debido a una limitación documentada del plan o flujo elegido, esto debería aparecer como resultado. No reemplace el PDF con imágenes individuales solo para un competidor, a menos que haya una segunda categoría llamada explícitamente "mejor resultado con preparación manual". La combinación de condiciones convierte el punto de referencia en una demostración, no en una comparación.
¿Qué puedes concluir antes de ejecutar el marcador?
La documentación ya nos permite formular hipótesis, pero no coronar a un ganador. En archivos PDF visuales, un ChatGPT fuera del flujo empresarial con recuperación visual comienza desde una condición diferente porque la documentación dice que las imágenes incrustadas se descartan en el procesamiento de texto. Claude documenta análisis visuales de hasta 100 páginas y procesamiento de textos en archivos PDF de mayor tamaño. Gemini tiene documentación técnica nativa en formato PDF en la API, mientras que las aplicaciones Gemini tienen sus propios límites y contexto que deben probarse por separado. NotebookLM proporciona una capa de citas y navegación para la fuente que facilita la auditoría de la respuesta.
Estas diferencias sugieren que habrá ganadores por tarea, no necesariamente una herramienta dominante. Un sistema puede liderar en trazabilidad y quedarse atrás en la reconstrucción de una tabla escaneada; otro puede interpretar muy bien los gráficos y ser menos consistente al localizar las páginas. El punto de referencia debe preservar estas dimensiones en lugar de ocultarlas en una sola nota.
Cómo elegir una IA para tu PDF sin esperar el benchmark completo
Empiece por identificar el tipo de documento. Si todo es texto digital, haga cinco preguntas difíciles y verificables en partes distantes del archivo. Si hay gráficos, páginas escaneadas o tablas visuales, primero confirme que el plan y el flujo utilizados realmente representen estos elementos.
Entonces, siempre pida pruebas. Solicite una página de apoyo, una sección y un extracto, y abra el PDF para verlo. Haz al menos una pregunta de la que ya sepas la respuesta y otra sobre algo que no esté incluido en el documento. Esta pequeña prueba no reemplaza un punto de referencia, pero detecta rápidamente herramientas que responden con mayor confianza de lo que permite la evidencia.
Al final, la mejor IA para PDF no es la que produce el resumen más elegante. Es el que mejor se adapta a tu tipo de documento, comete errores detectables y muestra el origen de la respuesta. Sin esto, "acepta PDF" es una característica de la interfaz, no una medida de confiabilidad.