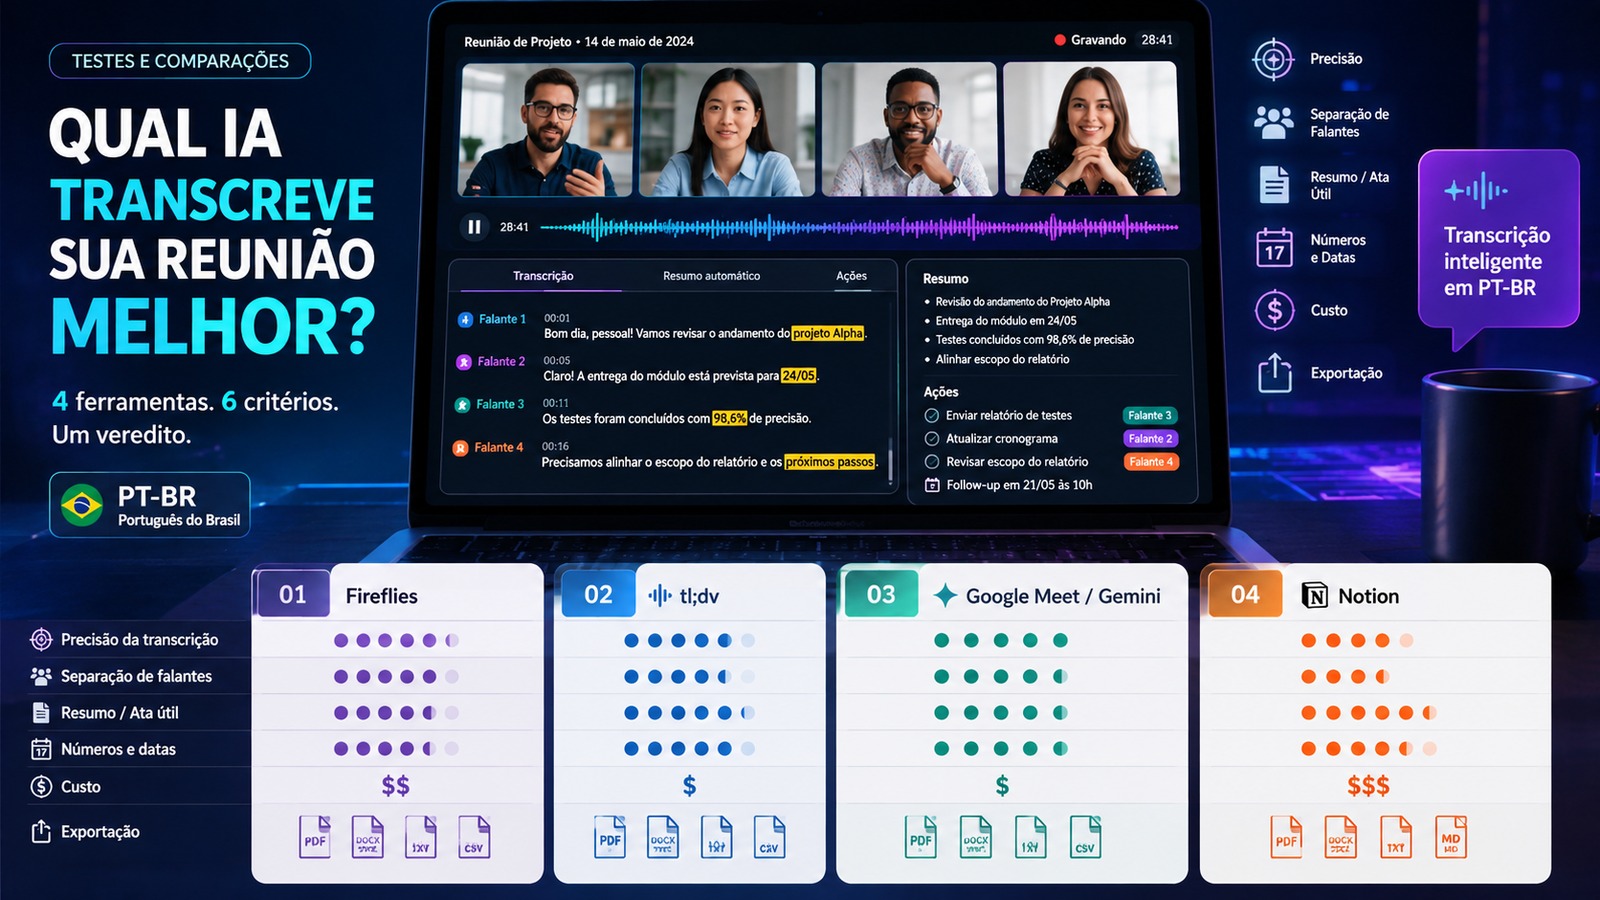
A pergunta “qual IA transcreve melhor reuniões em português?” parece pedir um ranking simples, mas um ranking confiável só existe quando as ferramentas recebem o mesmo áudio e são comparadas contra um gabarito humano. Documentação de produto confirma suporte de idioma e limitações operacionais; ela não prova, sozinha, qual sistema erra menos em uma reunião brasileira real.
No recorte atual, Fireflies e tl;dv declaram suporte explícito a português brasileiro. O Google Meet com Gemini aceita português para o recurso de notas automáticas, mas trabalha com um idioma por vez na reunião. O Notion AI Meeting Notes também aceita português, porém a própria documentação informa que a rotulagem de falantes está disponível atualmente apenas em inglês. Isso já muda a escolha para equipes que precisam saber com segurança quem disse o quê.
A conclusão prática é separar duas perguntas. A primeira é de elegibilidade: a ferramenta atende ao idioma, à plataforma, ao fluxo de trabalho e às exigências de privacidade da equipe? A segunda é de qualidade: quando todas recebem exatamente o mesmo conjunto de reuniões, qual produz a transcrição, a atribuição de falantes e a ata mais fiéis? É a segunda pergunta que um benchmark PT-BR precisa responder.
O que a documentação já permite concluir antes do teste
Fireflies: suporte específico a pt-BR e opção para reuniões multilíngues
A documentação do Fireflies lista Portuguese (Brazil), com código pt-BR, separadamente de português genérico e de português de Portugal. O serviço também informa modos de detecção automática e um modo multilíngue capaz de reconhecer mais de um idioma na mesma conversa. Para equipes brasileiras que alternam português e inglês na mesma chamada, essa é uma diferença operacional relevante antes mesmo de medir precisão.
O que essa documentação não resolve é a pergunta principal do benchmark. Suportar pt-BR não diz quantos nomes próprios serão preservados, se “R$ 1,5 milhão” será transcrito corretamente, se uma sigla interna será reconhecida ou se duas pessoas falando quase ao mesmo tempo serão atribuídas ao falante correto. Esses pontos precisam ser medidos com áudio real.
tl;dv: português brasileiro está na lista e o produto é multiplataforma
O tl;dv informa transcrição em mais de 30 idiomas e dialetos, incluindo Portuguese (Brazil) e Portuguese (Portugal). A ferramenta também é apresentada como compatível com Google Meet, Zoom e Microsoft Teams, o que a coloca naturalmente em uma comparação para equipes que não concentram todas as reuniões em uma única plataforma.
A página do fornecedor descreve gravação, transcrição, resumos e automações, mas a alegação de alta precisão é marketing do próprio produto, não um resultado comparativo independente. Para o benchmark editorial, tl;dv deve ser tratado como candidato, não como vencedor antecipado.
Google Meet/Gemini: integração nativa forte, com limite de um idioma por vez
O recurso “Take notes for me” do Google Meet está disponível em português e gera notas organizadas em Google Docs. Depois da reunião, o documento fica no Google Drive do organizador e pode ser ligado ao evento do Calendar conforme as permissões configuradas. Para uma equipe que já trabalha integralmente em Google Workspace, essa integração reduz etapas de exportação e compartilhamento.
A limitação importante é linguística: o Google informa que o recurso funciona com um idioma por vez e que várias línguas faladas na mesma reunião não são atualmente suportadas. Em empresas brasileiras que trocam com frequência entre português e inglês, esse cenário precisa entrar no conjunto de testes, porque pode afetar tanto a transcrição quanto o resumo.
Notion: português disponível, mas rotulagem de falantes em inglês
O Notion AI Meeting Notes transcreve reuniões, gera pontos-chave e itens de ação, e inclui português entre os idiomas disponíveis. A limitação mais relevante para este comparativo é explícita: a rotulagem de falantes está disponível atualmente em inglês.
Isso não torna o Notion inútil em português. Em uma conversa individual, uma apresentação ou uma reunião em que a identidade de cada fala não seja crítica, o produto pode atender ao fluxo de notas. Mas, se a meta é produzir uma ata auditável de uma reunião com várias pessoas, a ausência de rotulagem de falantes em PT-BR é uma desvantagem concreta que deve pesar antes mesmo do teste de precisão textual.
Como montar um benchmark PT-BR que não favoreça uma ferramenta
O princípio é simples: as quatro soluções precisam receber o mesmo material e ser avaliadas pela mesma referência. Não se deve comparar uma chamada real no Google Meet com um arquivo limpo enviado ao concorrente, nem permitir correção manual em um resultado e deixar os demais brutos.
O conjunto ideal combina reuniões de naturezas diferentes. Uma conversa interna com interrupções testa turnos rápidos; uma reunião com cliente introduz nomes, cargos e termos de negócio; uma discussão técnica pressiona siglas e jargões; uma reunião de planejamento coloca datas, horários, valores e itens de ação no centro. Também convém incluir ao menos um trecho com sobreposição de fala e, se isso fizer parte da rotina da empresa, uma reunião com alternância entre português e inglês.
O gabarito humano deve ser produzido a partir do mesmo áudio, palavra por palavra, com os falantes identificados e sem “limpar” a fala para parecer texto escrito. Pausas, correções, números e nomes precisam ser registrados com critérios consistentes. É contra esse gabarito que cada saída automática será comparada.
WER mede o texto, mas não mede toda a utilidade da reunião
Word Error Rate, ou WER, é uma métrica clássica de reconhecimento de fala. Ela soma substituições, exclusões e inserções e divide o total pelo número de palavras do gabarito. Quanto menor o WER, melhor a correspondência textual. É um ponto de partida importante porque impede que a comparação fique baseada apenas em impressão subjetiva.
Mesmo assim, duas transcrições com WER parecido podem ter utilidade muito diferente. Errar uma preposição e errar o nome do cliente contam como erros, mas o segundo pode ser muito mais grave para quem vai usar a ata. Por isso o benchmark precisa manter métricas adicionais para nomes próprios, siglas, produtos, jargão e termos técnicos.
Em português brasileiro, acentos e palavras curtas também merecem revisão. Um sistema pode produzir frases fluidas e ainda trocar “não” por “no”, confundir “há” e “a” ou converter um valor monetário em outro formato. A leitura final precisa identificar erros que mudam sentido, não apenas contar palavras divergentes.
Atribuição de falantes deve ser medida separadamente
Diarização responde à pergunta “quem falou quando?”. Em reuniões, isso é tão importante quanto reconhecer as palavras. Uma ata que atribui uma decisão ao participante errado pode ser mais perigosa do que uma transcrição com alguns erros ortográficos.
O teste deve marcar cada turno no gabarito e verificar duas coisas: se a ferramenta separou a quantidade correta de vozes e se atribuiu cada trecho à pessoa certa. Fala sobreposta deve receber uma avaliação própria, porque é comum que sistemas funcionem bem em turnos limpos e se confundam quando alguém interrompe o outro.
Esse critério é especialmente decisivo para o Notion no cenário atual, pois a própria documentação limita a rotulagem de falantes ao inglês. Para Fireflies, tl;dv e Google, a existência de nomes na interface não substitui a medição: é preciso verificar o que acontece nos áudios brasileiros usados pela equipe.
Nomes, números e datas merecem uma planilha de erros própria
Em reuniões de trabalho, os erros mais caros raramente são distribuídos de forma uniforme. Nome de pessoa, nome de empresa, código de produto, sigla, número de pedido, porcentagem, valor, data e horário costumam ser a informação que o leitor volta para conferir depois.
Por isso, além do WER geral, o benchmark deve contar quantas entidades críticas foram reconhecidas corretamente. Um trecho como “R$ 42,7 mil até 24 de setembro, com margem de 8,6%” é muito mais informativo para o teste do que uma frase genérica. Também vale inserir nomes brasileiros menos frequentes e termos internos da empresa, porque é aí que diferenças entre modelos costumam aparecer.
Resumo e itens de ação precisam ser comparados com a reunião, não entre si
Um resumo pode soar profissional e ainda estar errado. A avaliação deve verificar se a ferramenta preservou decisões, pendências, responsáveis, prazos e ressalvas sem acrescentar fatos que não foram ditos. O gabarito para essa etapa não precisa ser uma transcrição completa; pode ser uma ata humana curta, preparada depois que a referência verbal estiver pronta.
A fidelidade pesa mais do que o estilo. Se um sistema produz uma ata elegante, mas transforma uma hipótese em decisão, ele deve perder pontos. Da mesma forma, um item de ação só deve contar como correto quando a ação, o responsável e o prazo estiverem realmente sustentados pela conversa.
Latência, custo e exportação entram depois da qualidade mínima
A ferramenta mais precisa pode não ser a melhor escolha se o resultado demora demais, se o plano necessário fica caro para o volume real ou se a saída não encaixa no fluxo da equipe. O custo deve ser calculado com o cenário de uso da empresa: quantidade de usuários, horas mensais, recursos exigidos, armazenamento e eventuais limites do plano. Comparar apenas o preço de entrada pode favorecer artificialmente um produto.
A latência pode ser medida do fim da reunião até o momento em que transcrição, resumo e itens de ação ficam prontos. Para exportação, o teste deve registrar quantos passos são necessários para levar a ata ao destino real: Google Docs, Notion, CRM, sistema de tickets ou arquivo local. Integração nativa pode vencer uma diferença pequena de precisão quando reduz trabalho manual recorrente.
Como transformar as métricas em uma nota sem esconder o que importa
Uma nota única é útil para ordenar os resultados, mas só depois que as métricas individuais forem publicadas. Para um time que usa atas como registro de decisão, precisão textual e atribuição de falantes devem receber o maior peso. Para uma equipe comercial, nomes, valores, CRM e itens de ação podem pesar mais. Para pesquisa ou entrevistas, transcrição literal e facilidade de exportar o conteúdo bruto podem ser prioritárias.
Uma distribuição inicial razoável é dar a maior parcela para transcrição e falantes, reservar uma faixa relevante para nomes, números e datas, e dividir o restante entre resumo, itens de ação, latência, custo e exportação. O importante é declarar os pesos antes de olhar o resultado. Ajustar a fórmula depois de ver quem ganhou destrói a comparabilidade.
O que cada uma precisa provar no teste brasileiro
Fireflies precisa confirmar na prática a vantagem documental do pt-BR
O Fireflies entra forte no pré-teste porque reconhece explicitamente português brasileiro e oferece modo multilíngue. O benchmark precisa mostrar se essa cobertura se traduz em menor WER, boa separação de falantes e preservação de nomes, siglas e números nos áudios da equipe.
tl;dv precisa transformar suporte amplo em acerto mensurável
O tl;dv também declara português brasileiro e opera nas três grandes plataformas de videoconferência. Seu desempenho deve ser medido nos mesmos arquivos, sem usar as próprias alegações de precisão do fornecedor como evidência de vitória. Se tiver vantagem, ela precisa aparecer no gabarito humano.
Google Meet/Gemini precisa mostrar quanto a integração compensa os limites de idioma
Para organizações centradas em Google Workspace, gerar as notas diretamente em Docs e ligá-las ao ecossistema do Meet é um benefício operacional real. O teste, porém, deve medir português falado com sotaques, nomes e jargão da empresa, além de incluir uma reunião bilíngue quando isso fizer parte do cotidiano. O limite de um idioma por vez pode ser decisivo nesse cenário.
Notion precisa ser avaliado com o limite de falantes à vista
O Notion tem a vantagem de manter transcrição, resumo e conhecimento dentro do espaço de trabalho, mas a limitação atual de speaker labeling em inglês pesa diretamente contra um benchmark de reuniões em português com vários participantes. Para equipes que não dependem dessa atribuição, ele ainda pode competir em resumo, itens de ação e fluxo de documentação.
Então, qual IA escolher para reuniões em português?
Sem executar o benchmark controlado, não há base técnica suficiente para declarar Fireflies, tl;dv, Google Meet/Gemini ou Notion como campeão universal de precisão em PT-BR. O que já dá para decidir é a composição da shortlist.
Se a reunião costuma alternar idiomas, o Fireflies tem hoje a vantagem documental mais clara por oferecer um modo multilíngue. Se a equipe trabalha em Google Meet e Google Docs o dia inteiro, Gemini pode ganhar em integração mesmo que outra solução tenha pequena vantagem de reconhecimento. Se a empresa usa Meet, Zoom e Teams e quer comparar uma ferramenta independente da plataforma, Fireflies e tl;dv são candidatos naturais para um teste lado a lado. Se a identificação de falantes em português é requisito obrigatório, a limitação atual do Notion precisa ser tratada como um obstáculo, não como um detalhe.
A melhor escolha, portanto, não começa na nota de uma página de vendas. Começa com quatro ou cinco gravações representativas, um gabarito humano e critérios definidos antes da medição. A ferramenta que vencer nesse material é a que tem maior chance de funcionar no seu ambiente real - e esse resultado é muito mais útil do que qualquer ranking genérico.