A manchete diz “um dia extra”. A pergunta importante é: um dia extra comparado a quê e em quais métricas?
A resposta curta é que o avanço é tecnicamente relevante, mas a expressão precisa ser lida como uma medida de desempenho em benchmark. O estudo do WeatherNext Cyclones, publicado pela Nature em 6 de agosto de 2026, relata uma vantagem média de um dia ou mais em lead time para trajetória, intensidade e extensão dos ventos quando o modelo é comparado a referências operacionais. Isso não significa que qualquer ciclone passe a ser previsto corretamente 24 horas antes, nem que cada previsão individual receba exatamente o mesmo ganho.
A própria documentação pede cautela adicional. A versão disponível na Nature é uma publicação antecipada e não editada, ainda sujeita a revisão editorial antes da versão final. O repositório aberto também classifica o WeatherNext como um projeto experimental de pesquisa e diz explicitamente que ele não substitui alertas e avisos meteorológicos oficiais.
O que “um dia extra” quer dizer no benchmark
O lead time é o intervalo entre a emissão de uma previsão e o momento para o qual ela vale. A vantagem anunciada não foi obtida simplesmente contando quantas horas antes o WeatherNext Cyclones “descobriu” uma tempestade.
Uma forma usada no trabalho para tornar a comparação intuitiva é observar quanto mais longe no futuro o novo modelo consegue chegar mantendo um nível de erro semelhante ao que um modelo de referência tinha em um prazo menor.
Há exemplos concretos no material suplementar. Para trajetória, considerando um patamar de erro de posição de 300 quilômetros, a comparação histórica do WeatherNext Cyclones com o ensemble do ECMWF indica aproximadamente 27 horas de vantagem de lead time. Para intensidade, usando um erro de 15 nós como referência e o HWRF como comparação histórica, a diferença apresentada chega a cerca de 40 horas.
Esses números ajudam a entender por que “um dia” funciona como resumo, mas também mostram seu limite: não existe um ganho fixo de 24 horas aplicado de forma idêntica a trajetória, vento, tamanho da circulação, bacia oceânica, tempestade e prazo de previsão.
Também não se deve confundir o horizonte máximo do modelo com precisão garantida. O WeatherNext Cyclones pode gerar cenários globais que chegam a 15 dias, mas produzir uma saída para o 15º dia não significa ter a mesma habilidade preditiva observada nos primeiros dias.
Contra quais modelos o WeatherNext Cyclones foi comparado
O estudo não escolheu apenas um adversário. Os autores usam como referências centrais modelos de categorias diferentes: o ECMWF ENS, um ensemble numérico global; o HAFS-A, modelo regional voltado a furacões; e o GenCast, outro sistema de previsão meteorológica com IA. O suplemento ainda traz comparações adicionais com ECMWF HRES, GEFS, HAFS-B, HMON e HWRF.
A comparação pode ser resumida assim:
| Alegação analisada | Como foi medida | Referências importantes | Limitação que muda a leitura |
|---|---|---|---|
| Melhor trajetória | Erro geodésico da posição do centro e métricas probabilísticas de posição | ECMWF ENS, HAFS-A e GenCast | Nos agregados pareados, entram apenas ciclos em que os modelos comparados mantêm um ciclone ativo e existe observação correspondente. |
| Melhor intensidade | Erro do vento máximo sustentado; distribuições também avaliadas com métricas probabilísticas | HAFS-A, ENS, GenCast e, no contexto histórico, HWRF | Há regiões e casos individuais nos quais HAFS teve erro de intensidade menor; a superioridade média não vale para cada previsão. |
| Melhor previsão do tamanho dos ventos | Erro dos raios de vento de 34, 50 e 64 nós nos quadrantes da tempestade | ENS, HAFS e outros baselines disponíveis | O raio de vento máximo, RMW, foi previsto pelo sistema, mas não entrou na verificação principal por falta de observações suficientes para significância adequada. |
Há ainda uma sutileza metodológica importante. Parte das comparações determinísticas coloca a média de um ensemble do WeatherNext Cyclones contra uma execução determinística de outro sistema. O próprio suplemento reconhece que uma média de ensemble pode reduzir parte do ruído e, portanto, obter uma vantagem estrutural em erro médio. Os autores justificam a escolha por refletir a forma como ensembles são usados operacionalmente e também apresentam avaliações probabilísticas próprias, com métricas como CRPS e energy score.
Ou seja: o resultado não depende de uma única tabela, mas também não deve ser resumido como uma corrida simples entre dois modelos idênticos.
Quais ciclones entraram nos testes
Aqui existe uma diferença de redação entre as próprias fontes que merece ser preservada.
O resumo publicado pela Nature diz que o WeatherNext Cyclones foi avaliado em ciclones tropicais de 2023 a 2025. Já o anúncio da DeepMind descreve a avaliação histórica principal como cobrindo 2023 e 2024. O material suplementar ajuda a reconciliar os dois recortes: 2025 aparece em uma avaliação determinística adicional, parcial e ligada à operação em tempo real nas bacias do Atlântico Norte e Pacífico Leste.
Por isso, seria impreciso dizer simplesmente que “todos os testes foram feitos uniformemente em todos os ciclones de 2023 a 2025”.
Nos testes pareados, a referência observacional vem do IBTrACS. Os autores incluem sistemas classificados como tropicais ou subtropicais e excluem, para essas métricas, perturbações, sistemas extratropicais e casos sem classificação adequada. Um determinado prazo só entra na comparação homogênea quando os modelos envolvidos preveem um ciclone ativo naquele ciclo e existe observação correspondente.
Esse detalhe importa bastante. O benchmark de erro de trajetória ou intensidade responde bem à pergunta “quando os modelos estão acompanhando o mesmo ciclone, qual deles erra menos?”, mas não equivale sozinho a medir todos os tipos possíveis de falha na detecção, formação ou manutenção de um ciclone.
Em 2025 há outra variável: o rastreador usado com o WeatherNext Cyclones foi atualizado em 25 de setembro. O suplemento relata ganhos perceptíveis sobretudo em intensidade e nos raios de vento depois dessa mudança. Para os experimentos retrospectivos, a inicialização do rastreador também difere da operação em tempo real.
Portanto, “2025” não representa uma única configuração congelada do começo ao fim da temporada.
Por que o ensemble é parte central do avanço
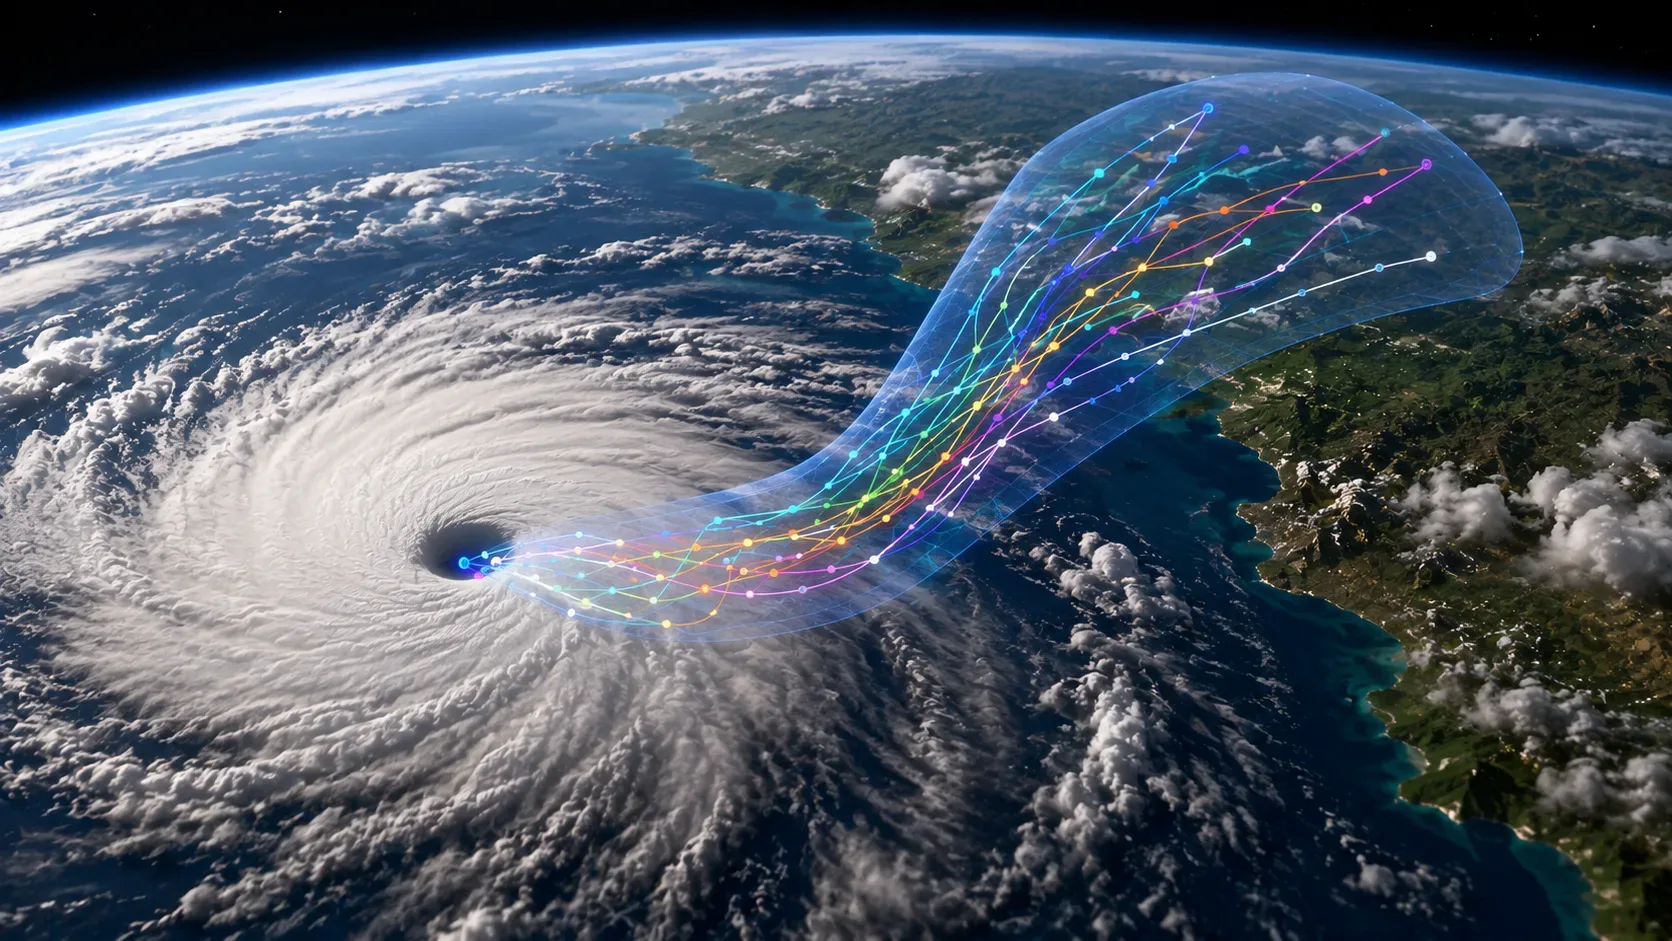
O WeatherNext Cyclones não foi projetado apenas para entregar uma trajetória única. Ele pode gerar muitos cenários plausíveis da atmosfera e do ciclone, formando um ensemble.
Essa diferença é importante porque a decisão operacional raramente depende apenas de onde está a linha central. Um conjunto de membros permite perguntar, por exemplo, qual parcela dos cenários coloca determinada região sob ventos de intensidade específica ou quão dispersas estão as trajetórias possíveis.
A DeepMind mostra ensembles de até 1.000 membros e mapas probabilísticos derivados dessas execuções. O artigo também trabalha com ensembles menores nas avaliações regulares. A ideia é amostrar melhor a distribuição de resultados e, especialmente com conjuntos maiores, examinar eventos menos frequentes.
Isso não transforma os mil membros em mil “votos” independentes nem garante que o cenário verdadeiro esteja entre eles. Tampouco a dispersão deve ser chamada automaticamente de “cone oficial de incerteza”: esse tipo de produto operacional tem definição própria pelas agências meteorológicas.
O ganho real é permitir avaliar a previsão também como uma distribuição de probabilidades, e não apenas pela distância entre uma linha prevista e a trajetória observada.
Os casos negativos continuam existindo
Os próprios resultados suplementares evitam a interpretação de superioridade absoluta.
Na decomposição geográfica dos erros, o WeatherNext Cyclones apresenta melhora predominante sobre o ECMWF ENS, mas há casos raros em que seu erro de trajetória ou intensidade é substancialmente maior. Contra o HAFS, a vantagem de trajetória é mais consistente; em intensidade, o quadro é mais misto, com um número maior de situações em que o HAFS obtém erro menor.
Os autores também aplicam testes por bootstrap, reamostrando no nível do ciclone, para verificar em quais prazos as diferenças atingem significância estatística. Isso fortalece a leitura do resultado médio, mas não elimina a variabilidade de tempestade para tempestade.
Outro limite aparece na estrutura dos ventos. Os raios de 34, 50 e 64 nós puderam ser avaliados, mas o RMW — raio do vento máximo — foi retirado da verificação principal porque havia menos observações e, consequentemente, menor poder estatístico.
É justamente aí que a frase “prevê ciclones com um dia a mais de antecedência” começa a ficar ampla demais. O trabalho mede várias propriedades, com disponibilidade de dados e referências diferentes, e apresenta médias agregadas. Não demonstra que cada característica de cada ciclone esteja correta 24 horas antes.
O que já apareceu na operação real
O modelo não ficou restrito ao laboratório. Em 2025, previsões do WeatherNext Cyclones foram disponibilizadas durante a temporada, e documentos do National Hurricane Center mostram que a orientação da DeepMind, identificada como GDMI, chegou a ser considerada junto com outros modelos e consensos.
No furacão Melissa, por exemplo, uma discussão operacional do NHC registrou uma mudança importante do GDMI entre ciclos, enquanto outros modelos também se deslocavam dentro do envelope de soluções. Em outros boletins, o centro combinou ou comparou GDMI com HCCA, ECMWF e HAFS para formular a previsão oficial.
Isso é um sinal de relevância operacional, não de substituição do processo. O modelo entra como mais uma fonte de orientação em uma decisão que também considera outras simulações, consistência entre rodadas, observações e julgamento dos meteorologistas.
Em entrevista publicada pela Wired em 6 de agosto de 2026, o diretor do NHC, Mike Brennan, reforçou essa leitura: horas adicionais podem ter valor prático para preparação e evacuação, mas nenhum modelo individual tem garantia de ser o melhor na próxima tempestade ou na próxima temporada.
Como reproduzir o comportamento do modelo aberto
A DeepMind publicou código, checkpoints e um notebook de demonstração. Há, porém, uma distinção essencial entre ver o WeatherNext Cyclones funcionando e reproduzir o benchmark do artigo.
- Use o repositório oficial e fixe uma versão do código, em vez de executar automaticamente a ramificação mais recente. A própria documentação alerta que o código de pesquisa pode mudar e não oferece estabilidade de API.
- Para uma demonstração acessível, o notebook oficial usa por padrão o WeatherNext Cyclones Mini, de resolução mais baixa, que pode rodar em uma TPU v5e-1. Ele serve para inspecionar a cadeia de previsão e rastreamento, mas a documentação avisa que seu desempenho não deve ser considerado equivalente ao dos modelos maiores usados no artigo.
- Para uma reprodução científica, escolha o checkpoint compatível com o ano avaliado. O repositório mantém versões treinadas apenas com dados anteriores ao período de teste — por exemplo, modelos destinados a reproduzir resultados de 2023 ou 2024 sem usar dados futuros daquele ano.
- Mantenha o mesmo estado inicial, verdade observacional e regras de pareamento. O trabalho usa IBTrACS para a verificação específica de ciclones e restringe agregados homogêneos aos ciclos disponíveis para todos os modelos em comparação.
- Separe métricas determinísticas e probabilísticas. Comparar apenas a média do ensemble mede uma coisa; avaliar toda a distribuição com CRPS, energy score, confiabilidade e probabilidades mede outra. Misturar as duas leituras produz conclusões erradas sobre o que o sistema melhorou.
- Ao visualizar vários membros, trate a dispersão como distribuição de cenários. Para alegar que o “dia extra” foi reproduzido, ainda seria necessário recuperar os mesmos ciclos dos modelos de referência e recalcular as curvas de erro sob condições equivalentes.
O ponto mais importante é não usar o Mini, obter uma trajetória visualmente plausível e concluir que o benchmark da Nature foi reproduzido. O teste científico exige o mesmo recorte temporal, checkpoints corretos, baselines, observações e métricas.
Então o WeatherNext Cyclones realmente ganhou um dia?
Como resumo de benchmark, sim. Como promessa operacional universal, não.
O estudo apresenta evidência de um ganho substancial e estatisticamente relevante em diferentes dimensões da previsão de ciclones, incluindo trajetória, intensidade e extensão dos ventos. Em determinados critérios, a diferença ultrapassa claramente 24 horas. A capacidade de produzir grandes ensembles também torna o modelo interessante para previsões probabilísticas, não apenas para uma trajetória central.
Mas o resultado vem de médias, recortes homogêneos, métricas específicas e versões definidas do sistema. Há casos negativos, diferenças entre bacias, limitações observacionais e mudanças de rastreador. O benchmark também foi produzido por um grupo que inclui pesquisadores da DeepMind e colaboradores institucionais; a publicação científica aumenta o escrutínio, mas não substitui replicações independentes e várias temporadas de verificação operacional.
Ao acompanhar os próximos testes do WeatherNext Cyclones, vale comparar sempre qual versão foi usada, até quando ela foi treinada, contra qual modelo, em qual bacia, com qual atraso operacional e por qual métrica. Sem esses qualificadores, “um dia extra” é uma boa manchete, mas uma descrição incompleta do resultado.