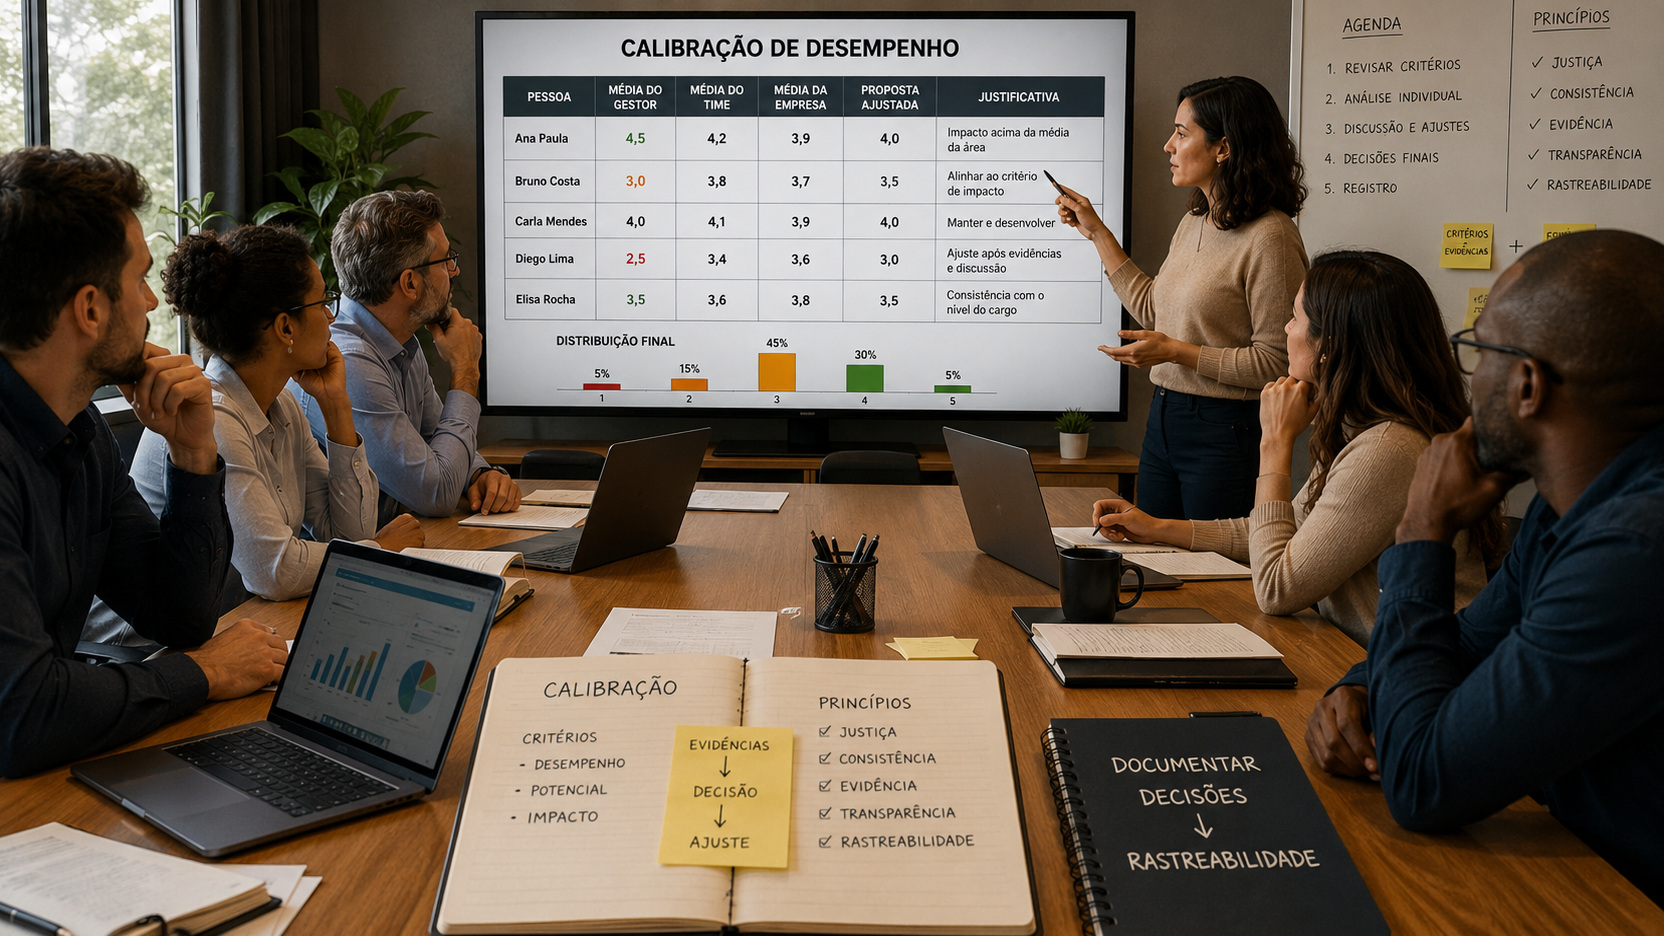
A reunião de calibração serve para testar se gestores diferentes estão aplicando a mesma régua de desempenho de forma comparável. Ela pode mudar notas, mas o objetivo não deveria ser produzir um desenho estatístico bonito nem fazer todas as áreas caberem na mesma distribuição. Uma calibração bem conduzida começa nos critérios, passa pelas evidências e termina com uma decisão registrada. A distribuição das notas entra como sinal para investigar, não como meta a ser obedecida.
Essa distinção importa porque a própria pesquisa sobre calibração mostra um quadro menos simples do que a promessa de "mais justiça". Há evidências de que a discussão entre gestores pode ampliar informação e consistência, mas também de que o comitê pode comprimir notas, favorecer quem consegue defender melhor seus casos e reproduzir assimetrias de poder. O desenho da reunião, portanto, precisa ser tão cuidadoso quanto a escala de avaliação.
O que a calibração deve corrigir - e o que ela não deve tentar fabricar
Calibrar é comparar a aplicação dos critérios. Se dois profissionais de mesmo nível entregaram resultados equivalentes em contextos comparáveis, uma diferença grande de rating pede explicação. Talvez os contextos sejam de fato diferentes. Talvez um gestor esteja usando um padrão mais severo. Talvez uma evidência relevante tenha ficado fora da avaliação. O papel da reunião é tornar essas diferenças examináveis.
Isso é diferente de partir de uma curva desejada e ajustar pessoas até que os percentuais coincidam. Uma distribuição pode revelar que um time está concentrando notas muito altas ou muito baixas, mas o histograma não prova, por si só, que as notas estejam erradas. Quando o facilitador pergunta primeiro "quem vamos baixar para fechar a faixa?", a lógica já mudou: o processo deixou de testar critérios e passou a perseguir uma quota.
A pesquisa de B. William Demeré, Karen Sedatole e Alexander Woods, publicada na Management Science, ajuda a entender o risco. No contexto estudado, comitês de calibração aumentaram a consistência entre supervisores e reduziram viés de leniência, mas também agravaram o viés de centralidade, isto é, a tendência de comprimir avaliações em torno do meio da escala. O achado é um alerta contra tratar convergência como sinônimo automático de qualidade.
A evidência também mostra por que vale a pena calibrar
Em 2019, Andrew B. Speer, Andrew P. Tenbrink e Michael G. Schwendeman publicaram dois estudos de campo sobre reuniões de calibração em Human Performance. Os autores encontraram associações entre participação em calibração e maior percepção de uma referência comum para avaliar, maior accountability dos gestores e maior quantidade de informação disponível para formar os ratings. No segundo estudo, os ratings pós-calibração também se correlacionaram mais com outras medidas do domínio de desempenho do que os ratings anteriores.
Isso não significa que qualquer reunião de calibração melhora qualquer sistema. Significa que a conversa estruturada pode acrescentar informação e alinhar referências. O mecanismo é plausível: um gestor deixa de avaliar apenas dentro do próprio time e precisa explicar sua leitura para outros gestores, ouvir casos comparáveis e responder a perguntas que talvez não aparecessem numa revisão individual.
O contraponto ficou mais explícito em um artigo de 2025 de Jasmijn C. Bol, Andson Braga de Aguiar e Jeremy B. Lill, em Human Resource Management. Com dados de 737 empregados e 114 supervisores de uma organização, os autores encontraram evidências consistentes com compartilhamento estratégico de informação pelos supervisores. Também observaram diferenças em quem tinha seus ratings ajustados: supervisores com menor custo para evitar escrutínio e defender seus ratings receberam menos ajustes e terminaram com notas mais altas, mesmo com controle para desempenho dos empregados. A mensagem prática é clara: a calibração não elimina política organizacional só porque reúne mais pessoas na sala.
Antes da reunião, congele a primeira avaliação
O primeiro controle é simples: cada gestor deve terminar e registrar seus ratings preliminares antes de ver a discussão do grupo. O Equality Action Center, no toolkit Bias Interrupters, recomenda esse tipo de precommitment justamente para reduzir a influência do primeiro posicionamento que domina a sala. Sem uma versão inicial congelada, fica difícil saber o que mudou, por que mudou e se a mudança ocorreu por nova evidência ou por conformidade social.
O registro prévio também cria a base da rastreabilidade. Para cada pessoa avaliada, o processo deve conseguir recuperar a nota inicial, a nota final, os critérios que sustentaram a decisão e a justificativa de qualquer alteração. Se a empresa usa um sistema de desempenho, essa trilha deve permanecer acessível para auditoria interna do ciclo.
Defina a régua antes de comparar pessoas
Uma reunião de calibração não é o melhor lugar para descobrir o que a escala significa. Antes da sessão, RH e liderança precisam ter definições operacionais para cada rating e exemplos de evidência compatíveis com cada nível. Termos como "superou expectativas" ou "excepcional" só ajudam se houver uma ideia compartilhada de quais resultados, comportamentos e impactos justificam a classificação.
A UC Davis, em sua orientação de calibração, recomenda ancorar ratings em resultados e comportamentos observados e considerar o período efetivo da avaliação. O material também separa o processo de rating de decisões de mérito financeiro. Essa separação é útil mesmo fora daquele contexto: se orçamento, bônus ou headcount pressionam a reunião, a nota pode virar instrumento para resolver uma restrição que não nasceu da avaliação de desempenho.
Os critérios também precisam permitir comparação justa. Colocar na mesma disputa pessoas de níveis, funções ou escopos muito diferentes gera uma falsa precisão. Quando a organização precisa calibrar um universo grande, é melhor organizar a discussão por grupos suficientemente comparáveis e explicitar as diferenças de escopo quando um caso atravessar fronteiras.
Leve evidência, não adjetivos
Para cada rating discutido, o gestor deveria conseguir responder a três perguntas: o que aconteceu, qual foi o impacto e por que isso corresponde ao nível proposto na régua. A qualidade da reunião melhora quando a linguagem sai de rótulos como "brilhante", "difícil", "pouco estratégico" ou "não tem presença" e passa para fatos do período de avaliação.
Isso não elimina julgamento. Avaliação de desempenho tem componentes subjetivos, especialmente quando envolve colaboração, liderança, qualidade de decisão ou impacto difícil de reduzir a uma métrica. O ponto é tornar o julgamento examinável. Se alguém diz que uma pessoa "não demonstra liderança", a reunião deve pedir exemplos, contexto e conexão com a competência definida. Se o comentário não muda a leitura do critério, ele não deveria mudar o rating.
O toolkit Bias Interrupters vai nessa direção ao recomendar uma rubrica consistente e uma intervenção ativa quando a conversa se afasta dos critérios. Na prática, o facilitador não precisa acusar ninguém de viés para fazer isso. Basta perguntar: "qual evidência do período sustenta essa diferença?", "estamos aplicando o mesmo padrão que usamos no caso anterior?" ou "esse ponto pertence à rubrica?".
Conduza a reunião por divergências relevantes, não por todos os nomes
Se todos os casos receberem o mesmo tempo, a reunião pode ficar longa sem ficar mais rigorosa. Vale usar a preparação para localizar onde existe incerteza real: notas muito diferentes da distribuição do grupo comparável, desacordo entre evidências e rating, mudança grande em relação a ciclos anteriores sem explicação, ratings extremos, ou gestores cuja régua parece sistematicamente mais alta ou mais baixa.
O cuidado é não transformar esses sinais em condenação automática. Uma equipe pode legitimamente ter vários desempenhos muito fortes. Um gestor pode ter assumido uma unidade madura e excepcional. Uma mudança de nota pode refletir aumento real de escopo. O sinal serve para escolher onde perguntar, não para definir a resposta.
Comece a discussão pela régua
Antes de abrir um caso, o facilitador relembra qual competência ou dimensão está em jogo e o que distingue os níveis relevantes. Isso reduz a chance de o grupo mudar o significado da escala de pessoa para pessoa.
Ouça primeiro quem tem a evidência mais próxima
A hierarquia da sala não é sinônimo de melhor informação. O estudo de Demeré, Sedatole e Woods encontrou que comitês tendiam a respeitar mais a decisão do supervisor quando ele tinha maior vantagem informacional sobre o subordinado em relação aos membros do comitê. Esse princípio é útil: desafiar o gestor direto faz parte da calibração, mas substituí-lo por autoridade sem evidência pode piorar a decisão.
Exija o mesmo padrão para subir e para baixar
Uma nota não deve precisar de documentação apenas quando é alta. Reduções também precisam de fundamento. Se uma divergência termina em ajuste, o grupo deve ser capaz de apontar qual evidência mudou a interpretação e qual critério ficou mais bem aplicado depois da discussão.
Como resolver divergência sem vencer pelo cargo
A pior dinâmica é a decisão por volume de voz ou senioridade. Para evitar isso, a reunião precisa ter uma regra de decisão conhecida antes dos casos difíceis. Em algumas organizações, o gestor direto mantém a decisão salvo evidência nova robusta. Em outras, o comitê decide por consenso ou por uma autoridade final definida. Qualquer modelo pode ser usado, mas o responsável final e a forma de registrar discordâncias precisam estar explícitos.
Quando houver impasse, o facilitador pode separar três situações. A primeira é falta de informação: o caso volta para coleta de evidência e não deveria ser resolvido por palpite. A segunda é divergência sobre o critério: o grupo precisa corrigir a interpretação da régua antes de decidir a pessoa. A terceira é julgamento diferente mesmo com fatos e critérios claros: nesse caso, aplica-se a regra de decisão e registra-se a justificativa.
Esse registro de dissenso é importante porque consenso aparente pode esconder conformidade. Uma nota final pode ser válida mesmo sem unanimidade, desde que a organização saiba quem decidiu, com quais informações e sob qual critério.
Trate o gráfico de distribuição como diagnóstico, não como quota
Mostrar a distribuição antes e depois da calibração pode ser útil. Ela permite enxergar compressão, leniência, severidade e diferenças entre gestores. Mas a pergunta correta é "o que explica esse padrão?", e não "quantas pessoas precisamos mover?".
Uma salvaguarda prática é proibir ajustes cuja única justificativa seja a distribuição. Se a nota muda, o registro precisa citar evidência e critério. A frase "já temos gente demais no 4" não é evidência de desempenho. Se a empresa possui uma política separada de distribuição forçada, essa política deve ser nomeada como tal; não convém escondê-la dentro de uma reunião apresentada como calibração de critérios.
Também é útil olhar para a direção dos ajustes. Se quase toda mudança empurra notas para o centro, o processo pode estar produzindo centralidade. Se um gestor tem quase todas as notas reduzidas e outro quase nunca sofre alteração, há uma diferença que merece diagnóstico. Esses padrões não provam erro, mas indicam onde revisar a consistência do processo.
Registre cada ajuste de modo que outra pessoa consiga reconstruir a decisão
Rastreabilidade não é uma ata com tudo o que foi dito. É um registro mínimo que permite responder depois: qual era o rating inicial, qual ficou final, houve mudança, que critério foi decisivo, que evidência sustentou o ajuste e quem teve autoridade para fechar o caso.
Vale registrar também quando uma questão ficou pendente por falta de evidência. Isso evita que a pressa da reunião transforme ausência de informação em nota definitiva. Se uma informação posterior alterar o caso, o histórico mostra por que houve reabertura e quem aprovou a mudança.
Para RH, o log de decisões permite uma revisão do processo sem reabrir todas as avaliações. É possível verificar quais critérios geraram mais divergência, quais gestores tiveram mais ajustes, em que direção as notas se moveram e onde a rubrica precisa de exemplos melhores no próximo ciclo.
Faça uma checagem de padrões depois, sem usar identidade como atalho na decisão individual
Uma organização que acompanha qualidade e equidade pode analisar padrões agregados depois da calibração, respeitando sua governança de dados e as regras aplicáveis. O objetivo é procurar assimetrias que mereçam investigação, não usar pertencimento a um grupo para substituir evidência de desempenho individual.
O Equality Action Center recomenda olhar tanto para dados quantitativos quanto para padrões de linguagem nas avaliações. O valor dessa checagem é detectar problemas que não aparecem em um caso isolado. Se certos grupos recebem sistematicamente comentários de personalidade enquanto outros recebem comentários sobre resultados e liderança, por exemplo, a organização ganha um sinal para revisar rubricas, treinamento e facilitação.
Depois da reunião, o gestor precisa sustentar a decisão final
Calibração não deveria produzir o roteiro "eu dei uma nota, mas o comitê tirou". Para o empregado, a avaliação final é uma decisão organizacional e precisa ser explicada com os mesmos critérios e evidências usados para fechá-la. Quando o gestor transfere a responsabilidade para uma sala invisível, a rastreabilidade existe internamente, mas a credibilidade do feedback cai.
Também convém guardar os aprendizados do ciclo. Se gestores interpretaram uma competência de três maneiras diferentes, o problema não termina quando as notas são fechadas. A próxima versão da rubrica precisa de definição melhor, exemplos ou treinamento. Uma boa calibração melhora não apenas os ratings daquele ano, mas a capacidade dos gestores de avaliar no ciclo seguinte.
Um roteiro enxuto para a sessão
A reunião pode começar com a confirmação de escopo, escala, grupos comparáveis e regra de decisão. Em seguida, o facilitador revisa rapidamente os critérios que mais geraram dúvida na preparação. Os ratings preliminares já devem estar registrados antes da discussão.
Depois, entram os casos selecionados por divergência ou risco de inconsistência. O gestor apresenta evidência e conexão com a rubrica; os demais fazem perguntas com base no mesmo padrão. Qualquer proposta de ajuste precisa declarar qual fato ou interpretação mudou. Se faltar informação, o caso sai como pendente, com responsável e prazo, em vez de ser decidido por pressão de tempo.
No fechamento, RH confirma os ratings finais, os ajustes e suas justificativas, revisa se houve uso indevido de distribuição como quota e registra questões sistêmicas para o próximo ciclo. A calibragem termina quando as decisões podem ser reconstruídas e defendidas pelo critério - não quando o gráfico fica simétrico.
O teste final da calibração
Uma reunião de calibração funciona quando gestores diferentes conseguem explicar por que duas notas semelhantes são semelhantes e por que duas notas diferentes são diferentes. Isso exige critérios comuns, evidência do período, espaço para discordância, decisão explícita e registro dos ajustes.
A pesquisa disponível não sustenta a ideia de que o comitê, sozinho, torna a avaliação justa. Ele pode aumentar informação, accountability e consistência; também pode comprimir ratings, criar incentivos estratégicos e amplificar a vantagem de quem navega melhor a hierarquia. Por isso, a proteção mais importante não é uma curva ideal. É um processo em que cada mudança de nota precisa sobreviver à pergunta mais simples da reunião: qual evidência e qual critério justificam esta decisão?