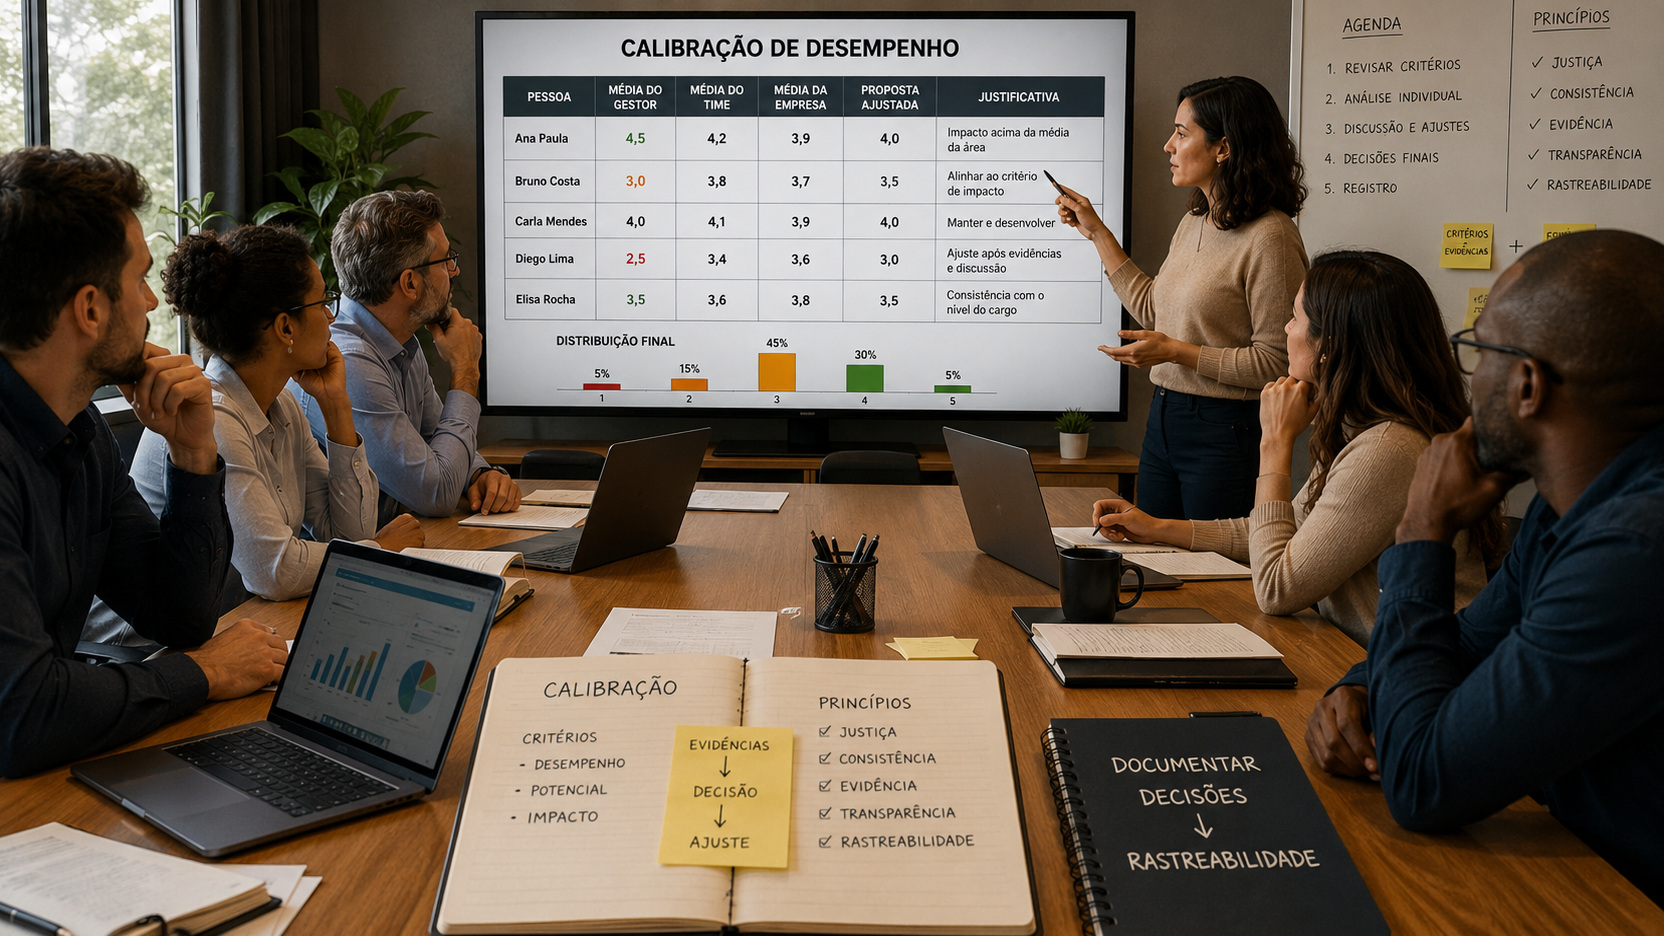
La reunión de calibración sirve para comprobar si distintos gestores están aplicando el mismo estándar de desempeño de forma comparable. Puede cambiar notas, pero el objetivo no debería ser producir una figura estadística bonita ni hacer que todas las áreas encajen en la misma distribución. Una calibración bien conducida empieza por los criterios, pasa por las evidencias y termina con una decisión registrada. La distribución de las notas entra como una señal para investigar, no como una meta que deba obedecerse.
Esa distinción importa porque la propia investigación sobre calibración muestra un panorama menos simple que la promesa de "más justicia". Hay evidencias de que la discusión entre gestores puede ampliar la información y la consistencia, pero también de que el comité puede comprimir las notas, favorecer a quienes logran defender mejor sus casos y reproducir asimetrías de poder. Por lo tanto, el diseño de la reunión debe ser tan cuidadoso como la escala de evaluación.
Qué debe corregir la calibración - y qué no debe intentar fabricar
Calibrar es comparar la aplicación de los criterios. Si dos profesionales del mismo nivel entregaron resultados equivalentes en contextos comparables, una diferencia grande de rating exige una explicación. Tal vez los contextos sean realmente distintos. Tal vez un gestor esté usando un estándar más severo. Tal vez una evidencia relevante haya quedado fuera de la evaluación. El papel de la reunión es hacer que esas diferencias puedan examinarse.
Eso es diferente de partir de una curva deseada y ajustar personas hasta que los porcentajes coincidan. Una distribución puede revelar que un equipo concentra notas muy altas o muy bajas, pero el histograma no demuestra, por sí solo, que las notas sean incorrectas. Cuando el facilitador pregunta primero "¿a quién vamos a bajar para cerrar la franja?", la lógica ya cambió: el proceso dejó de poner a prueba los criterios y
pasó a perseguir una cuota.
La investigación de B. William Demeré, Karen Sedatole y Alexander Woods, publicada en Management Science, ayuda a entender el riesgo. En el contexto estudiado, los comités de calibración aumentaron la consistencia entre supervisores y redujeron el sesgo de lenidad, pero también agravaron el sesgo de centralidad, es decir, la tendencia a comprimir las evaluaciones alrededor del centro de la escala. El hallazgo es una advertencia contra tratar la convergencia como sinónimo automático de calidad.
La evidencia también muestra por qué vale la pena calibrar
En 2019, Andrew B. Speer, Andrew P. Tenbrink y Michael G. Schwendeman publicaron dos estudios de campo sobre reuniones de calibración en Human Performance. Los autores encontraron asociaciones entre la participación en la calibración y una mayor percepción de una referencia común para evaluar, una mayor rendición de cuentas por parte de los gestores y una mayor cantidad de información disponible para formar los ratings. En el segundo estudio, los ratings posteriores a la calibración también se correlacionaron más con otras medidas del dominio del desempeño que los ratings anteriores.
Eso no significa que cualquier reunión de calibración mejore cualquier sistema. Significa que una conversación estructurada puede añadir información y alinear referencias. El mecanismo es plausible: un gestor deja de evaluar solo dentro de su propio equipo y necesita explicar su lectura a otros gestores, escuchar casos comparables y responder preguntas que quizá no aparecerían en una revisión individual.
El contrapunto quedó más explícito en un artículo de 2025 de Jasmijn C. Bol, Andson Braga de Aguiar y Jeremy B. Lill, en Human Resource Management. Con datos de 737 empleados y 114 supervisores de una organización, los autores encontraron evidencias consistentes con el intercambio estratégico de información por parte de los supervisores. También observaron diferencias en quiénes tenían sus ratings ajustados: los supervisores con menor costo para evitar escrutinio y defender sus ratings recibieron menos ajustes y terminaron con notas más altas, incluso controlando el desempeño de los empleados. El mensaje práctico es claro: la calibración no elimina la política organizacional solo porque reúna a más personas en la sala.
Antes de la reunión, congele la primera evaluación
El primer control es simple: cada gestor debe terminar y registrar sus ratings preliminares antes de ver la discusión del grupo. El Equality Action Center, en el toolkit Bias Interrupters, recomienda este tipo de compromiso previo precisamente para reducir la influencia del primer posicionamiento que domina la sala. Sin una versión inicial congelada, resulta difícil saber qué cambió, por qué cambió y si el cambio ocurrió por nueva evidencia o por conformidad social.
El registro previo también crea la base de la trazabilidad. Para cada persona evaluada, el proceso debe poder recuperar la nota inicial, la nota final, los criterios que sustentaron la decisión y la justificación de cualquier cambio. Si la empresa utiliza un sistema de desempeño, esa trazabilidad debe permanecer accesible para la auditoría
interna del ciclo.
Defina el estándar antes de comparar personas
Una reunión de calibración no es el mejor lugar para descubrir qué significa la escala. Antes de la sesión, RR. HH. y liderazgo necesitan definiciones operativas para cada rating y ejemplos de evidencia compatibles con cada nivel. Términos como "superó las expectativas" o "excepcional" solo ayudan si existe una idea compartida de qué resultados, comportamientos e impactos justifican la clasificación.
UC Davis, en su orientación sobre calibración, recomienda anclar los ratings en resultados y comportamientos observados y considerar el período efectivo de la evaluación. El material también separa el proceso de rating de las decisiones de mérito financiero. Esa separación es útil incluso fuera de ese contexto: si el presupuesto, los bonos o la dotación de personal presionan la reunión, la nota puede convertirse en un instrumento para resolver una restricción que no nació de la evaluación del desempeño.
Los criterios también deben permitir una comparación justa. Poner en la misma disputa a personas de niveles, funciones o alcances muy diferentes crea una falsa precisión. Cuando la organización necesita calibrar un universo grande, es mejor organizar la discusión por grupos suficientemente comparables y explicitar las diferencias de alcance cuando un caso atraviese fronteras.
Lleve evidencias, no adjetivos
Para cada rating discutido, el gestor debería poder responder tres preguntas: qué ocurrió, cuál fue el impacto y por qué eso corresponde al nivel propuesto en la escala. La calidad de la reunión mejora cuando el lenguaje sale de etiquetas como "brillante", "difícil", "poco estratégico" o "no tiene presencia" y pasa a hechos del período de evaluación.
Eso no elimina el juicio. La evaluación del desempeño tiene componentes subjetivos, especialmente cuando involucra colaboración, liderazgo, calidad de decisión o impacto difícil de reducir a una métrica. El punto es hacer que el juicio pueda examinarse. Si alguien dice que una persona "no demuestra liderazgo", la reunión debe pedir ejemplos, contexto y conexión con la competencia definida. Si el comentario no cambia la lectura del criterio, no debería cambiar el rating.
El toolkit Bias Interrupters avanza en esa dirección al recomendar una rúbrica consistente y una intervención activa cuando la conversación se aleja de los criterios. En la práctica, el facilitador no necesita acusar a nadie de sesgo para hacerlo. Basta con preguntar: "¿qué evidencia del período sustenta esta diferencia?", "¿estamos aplicando el mismo estándar que usamos en el caso anterior?" o "¿este punto pertenece a la rúbrica?".
Conduzca la reunión por divergencias relevantes, no por todos los nombres
Si todos los casos reciben el mismo tiempo, la reunión puede hacerse larga sin volverse más rigurosa. La preparación puede utilizarse para localizar dónde existe incertidumbre real: notas muy diferentes de la distribución del grupo comparable,
desacuerdo entre evidencias y rating, cambios grandes frente a ciclos anteriores sin explicación, ratings extremos, o gestores cuya vara parece sistemáticamente más alta o más baja.
El cuidado consiste en no convertir esas señales en una condena automática. Un equipo puede legítimamente tener varios desempeños muy fuertes. Un gestor puede haber asumido una unidad madura y excepcional. Un cambio de nota puede reflejar un aumento real de alcance. La señal sirve para elegir dónde preguntar, no para definir la respuesta.
Empiece la discusión por el estándar
Antes de abrir un caso, el facilitador recuerda qué competencia o dimensión está en juego y qué distingue los niveles relevantes. Eso reduce la posibilidad de que el grupo cambie el significado de la escala de una persona a otra.
Escuche primero a quien tiene la evidencia más cercana
La jerarquía de la sala no es sinónimo de mejor información. El estudio de Demeré, Sedatole y Woods encontró que los comités tendían a respetar más la decisión del supervisor cuando este tenía una mayor ventaja informativa sobre el subordinado que los miembros del comité. Ese principio es útil: cuestionar al gestor directo forma parte de la calibración, pero sustituirlo por autoridad sin evidencia puede empeorar la decisión.
Exija el mismo estándar para subir y para bajar
Una nota no debe necesitar documentación solo cuando es alta. Las reducciones también necesitan fundamento. Si una divergencia termina en ajuste, el grupo debe poder indicar qué evidencia cambió la interpretación y qué criterio quedó mejor aplicado después de la discusión.
Cómo resolver una divergencia sin que gane el cargo
La peor dinámica es la decisión por volumen de voz o jerarquía. Para evitarlo, la reunión necesita una regla de decisión conocida antes de los casos difíciles. En algunas organizaciones, el gestor directo mantiene la decisión salvo que aparezca nueva evidencia robusta. En otras, el comité decide por consenso o mediante una autoridad final definida. Cualquier modelo puede utilizarse, pero el responsable final y la forma de registrar los desacuerdos deben estar explícitos.
Cuando haya un impasse, el facilitador puede separar tres situaciones. La primera es la falta de información: el caso vuelve a la recopilación de evidencia y no debería resolverse por conjeturas. La segunda es la divergencia sobre el criterio: el grupo necesita corregir la interpretación del estándar antes de decidir sobre la persona. La tercera es un juicio distinto aun con hechos y criterios claros: en ese caso se aplica la regla de decisión y se registra la justificación.
Ese registro del disenso es importante porque un consenso aparente puede ocultar conformidad. Una nota final puede ser válida incluso sin unanimidad, siempre que la organización sepa quién decidió, con qué información y bajo qué criterio.
Trate el gráfico de distribución como diagnóstico, no como cuota
Mostrar la distribución antes y después de la calibración puede ser útil. Permite ver compresión, lenidad, severidad y diferencias entre gestores. Pero la pregunta correcta es "¿qué explica este patrón?", y no "¿cuántas personas necesitamos mover?".
Una salvaguarda práctica es prohibir ajustes cuya única justificación sea la distribución. Si la nota cambia, el registro debe citar evidencia y criterio. La frase "ya tenemos demasiada gente en 4" no es evidencia de desempeño. Si la empresa tiene una política separada de distribución forzada, esa política debe llamarse por su nombre; no conviene esconderla dentro de una reunión presentada como calibración de criterios.
También es útil observar la dirección de los ajustes. Si casi todos los cambios empujan las notas hacia el centro, el proceso puede estar produciendo centralidad. Si un gestor tiene casi todas las notas reducidas y otro casi nunca recibe modificaciones, hay una diferencia que merece diagnóstico. Esos patrones no demuestran error, pero indican dónde revisar la consistencia del proceso.
Registre cada ajuste de modo que otra persona pueda reconstruir la decisión
Trazabilidad no es un acta con todo lo que se dijo. Es un registro mínimo que permite responder después: cuál era el rating inicial, cuál quedó al final, si hubo cambio, qué criterio fue decisivo, qué evidencia sustentó el ajuste y quién tenía autoridad para cerrar el caso.
También conviene registrar cuando una cuestión quedó pendiente por falta de evidencia. Eso evita que la prisa de la reunión transforme la ausencia de información en una nota definitiva. Si información posterior modifica el caso, el historial muestra por qué se reabrió y quién aprobó el cambio.
Para RR. HH., el registro de decisiones permite revisar el proceso sin reabrir todas las evaluaciones. Es posible verificar qué criterios generaron más divergencia, qué gestores tuvieron más ajustes, en qué dirección se movieron las notas y dónde la rúbrica necesita mejores ejemplos en el siguiente ciclo.
Revise patrones después, sin usar la identidad como atajo en la decisión individual
Una organización que acompaña la calidad y la equidad puede analizar patrones agregados después de la calibración, respetando su gobernanza de datos y las reglas aplicables. El objetivo es buscar asimetrías que merezcan investigación, no usar la pertenencia a un grupo para sustituir la evidencia de desempeño individual.
El Equality Action Center recomienda observar tanto los datos cuantitativos como los patrones de lenguaje en las evaluaciones. El valor de esa revisión es detectar problemas que no aparecen en un caso aislado. Si ciertos grupos reciben sistemáticamente comentarios sobre personalidad mientras otros reciben comentarios sobre resultados y liderazgo, por ejemplo, la organización obtiene una señal para revisar rúbricas, capacitación y facilitación.
Después de la reunión, el gestor debe sostener la decisión final
La calibración no debería producir el guion "yo di una nota, pero el comité me la quitó". Para el empleado, la evaluación final es una decisión organizacional y debe explicarse con los mismos criterios y evidencias utilizados para cerrarla. Cuando el gestor traslada la responsabilidad a una sala invisible, la trazabilidad existe internamente, pero la credibilidad de la retroalimentación cae.
También conviene conservar los aprendizajes del ciclo. Si los gestores interpretaron una competencia de tres maneras distintas, el problema no termina cuando se cierran las notas. La próxima versión de la rúbrica necesita una definición mejor, ejemplos o capacitación. Una buena calibración mejora no solo los ratings de ese año, sino también la capacidad de los gestores para evaluar en el siguiente ciclo.
Un guion conciso para la sesión
La reunión puede comenzar con la confirmación del alcance, la escala, los grupos comparables y la regla de decisión. A continuación, el facilitador revisa rápidamente los criterios que más dudas generaron durante la preparación. Los ratings preliminares ya deben estar registrados antes de la discusión.
Después entran los casos seleccionados por divergencia o riesgo de inconsistencia. El gestor presenta la evidencia y la conexión con la rúbrica; los demás formulan preguntas con base en el mismo estándar. Cualquier propuesta de ajuste debe declarar qué hecho o interpretación cambió. Si falta información, el caso sale como pendiente, con responsable y plazo, en lugar de decidirse por presión de tiempo.
Al cierre, RR. HH. confirma los ratings finales, los ajustes y sus justificaciones, revisa si hubo un uso indebido de la distribución como cuota y registra cuestiones sistémicas para el siguiente ciclo. La calibración termina cuando las decisiones pueden reconstruirse y defenderse por el criterio - no cuando el gráfico queda simétrico.