Quando um agente envia o e-mail errado, altera um arquivo, muda uma permissão ou executa uma operação inesperada em um repositório, guardar apenas a conversa não responde às perguntas mais importantes do incidente. É preciso descobrir quem iniciou a execução, o que o agente tentou fazer, quais chamadas realmente foram executadas, que autorização estava válida e qual estado mudou no sistema externo.
Essa abordagem é compatível com a orientação do NIST para monitoramento pós-implantação de sistemas de IA, resposta e recuperação de incidentes e revisões posteriores. O perfil de IA generativa do NIST também recomenda definir responsabilidades para monitoramento de incidentes, fazer after-action reviews e manter políticas de retenção de registros pertinentes.
Nem toda ação errada de um agente é, por definição, um incidente de segurança. Pode ser um bug de orquestração, uma interpretação incorreta, uma política inadequada ou uma falha operacional. Mas, quando existe impacto relevante, a reconstrução precisa seguir princípios forenses: determinar a sequência de eventos, preservar dados e metadados, registrar as ações tomadas durante a investigação e manter a integridade e a proveniência desses registros. A SP 800-61 Rev. 3 do NIST, publicada em abril de 2025, trata esses pontos explicitamente na análise de incidentes.
O incidente precisa ser reconstruído como uma cadeia causal
O erro não deve ser investigado como uma única linha de log. Em um agente com acesso a Drive, e-mail, GitHub ou outros serviços, diferentes componentes veem partes diferentes da execução.
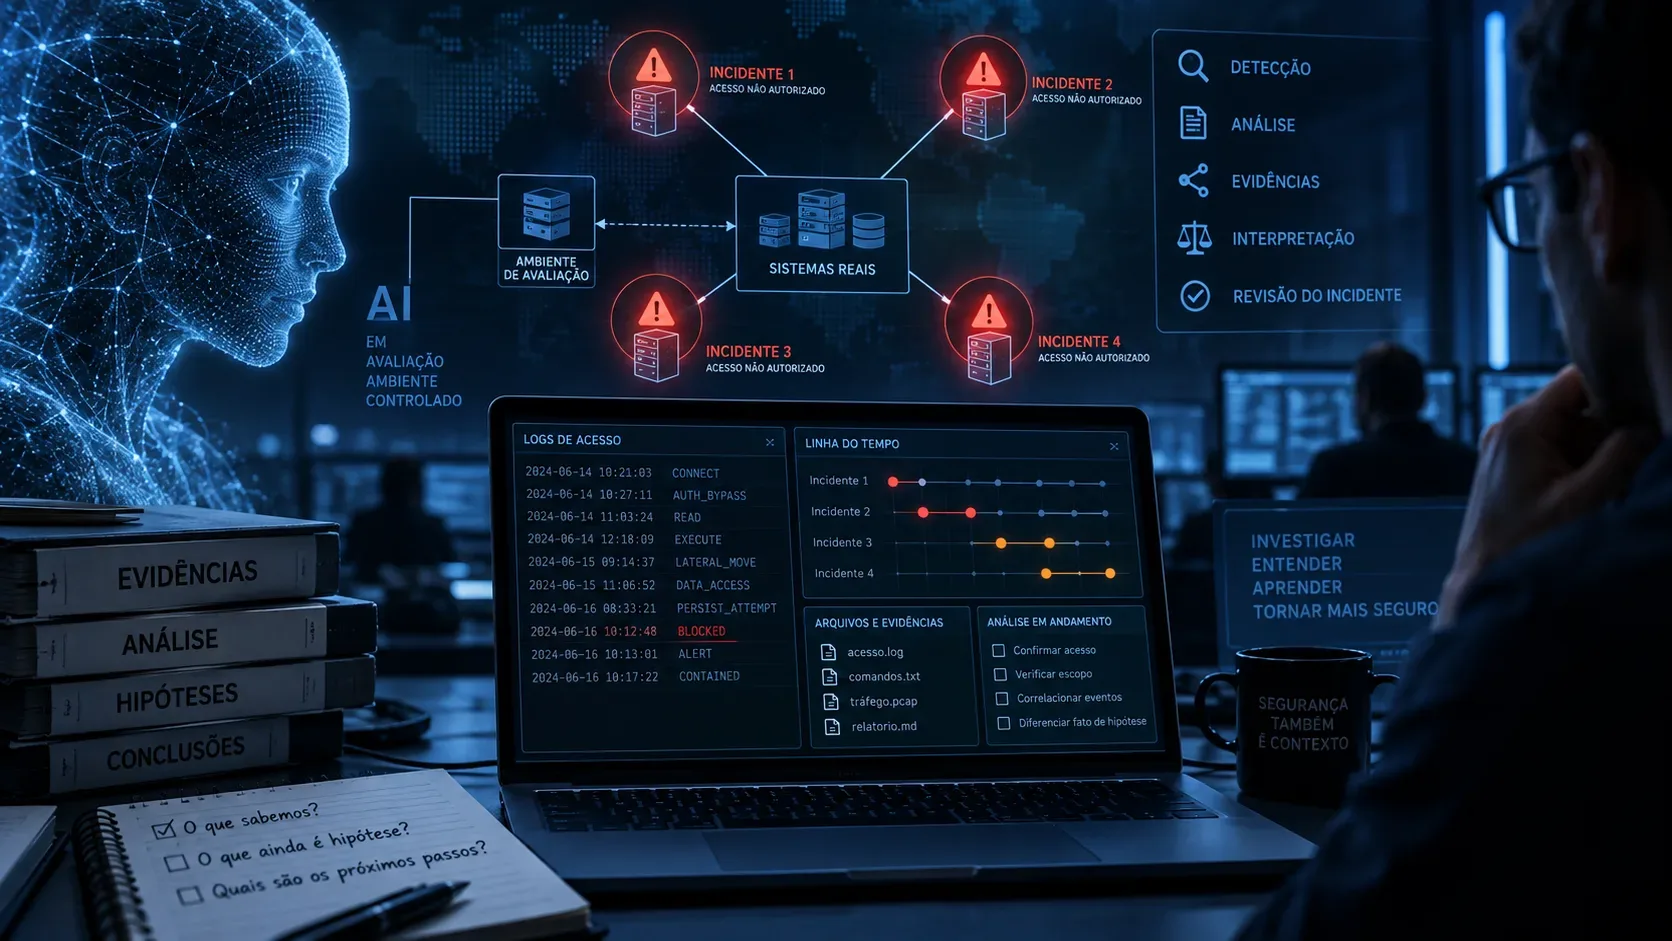
Uma forma prática de organizar a investigação é reconstruir a cadeia solicitação → execução do agente → chamada de ferramenta → autorização → operação no provedor → estado resultante. Essa estrutura é uma síntese operacional: padrões de observabilidade já distinguem chamadas do agente e execuções de ferramentas, enquanto provedores externos mantêm suas próprias trilhas de atividade e autorização.
| Camada de evidência | Pergunta que precisa responder | Registro que deve ser correlacionado |
|---|---|---|
| Origem | Quem iniciou aquela execução? | identidade autenticada, sessão ou execução, horário e identificador de correlação |
| Agente | Qual agente e configuração participaram? | identificador e versão do agente, modelo quando pertinente, workflow e políticas aplicáveis |
| Ferramenta | O que o agente tentou chamar? | nome da ferramenta, ID da chamada, parâmetros necessários, resultado ou erro |
| Autorização | A ação foi permitida? Em quais condições? | decisão allow/deny, política e versão, identidade delegada, credencial ou token e escopos pertinentes |
| Sistema externo | A operação chegou ao provedor e foi aceita? | log de auditoria ou atividade do Drive, GitHub, e-mail ou outro serviço |
| Estado | O que efetivamente mudou? | recurso afetado, estado anterior quando disponível, alteração observada e estado posterior |
A distinção é importante porque uma chamada de ferramenta não prova, sozinha, que houve uma alteração externa. Da mesma forma, possuir um token com determinado escopo não prova que uma operação específica foi autorizada por todas as políticas intermediárias.
O que preservar assim que a ação indevida for descoberta
Se o incidente ainda estiver produzindo dano, contenção e preservação de evidências precisam ser coordenadas. O NIST observa que estratégias de resposta podem envolver um equilíbrio entre investigação mais profunda e recuperação rápida; não se deve manter uma execução perigosa ativa apenas para conseguir uma trilha mais perfeita.
Uma ordem útil é:
- Interrompa novas ações indevidas quando necessário e abra um identificador único para o incidente. Registre o momento da detecção e quem iniciou a resposta.
- Preserve os registros já existentes em sua forma original. Exporte logs de execução, traces, eventos de autorização e auditorias dos sistemas externos antes que políticas de retenção eliminem dados relevantes.
- Capture os identificadores de correlação. Trace ID, span ID, run ID, tool call ID, request ID e identificadores do recurso permitem ligar eventos registrados por componentes diferentes.
- Preserve a configuração que estava válida no momento. Isso pode incluir versão do agente, workflow, conjunto de ferramentas, política de autorização e revisão da política usada na decisão.
- Colete evidência nos sistemas de destino. Não se limite ao que o agente disse que fez; procure a operação na trilha de auditoria do serviço que recebeu a chamada.
- Registre separadamente o estado logo após o incidente e o estado atual. Outra pessoa ou automação pode ter modificado o mesmo recurso depois.
- Documente a própria investigação. Quem coletou cada registro, quando, de onde e que transformações foram feitas também fazem parte da evidência.
A SP 800-61 Rev. 3 recomenda que ações realizadas durante a investigação sejam registradas, que a integridade e a proveniência desses registros sejam preservadas e que dados e metadados do incidente sejam coletados e retidos conforme os procedimentos de preservação e retenção da organização.
Como determinar quem pediu a ação
“Quem pediu?” pode ter três respostas diferentes.
A primeira é o iniciador da tarefa: a pessoa, serviço, evento ou automação que originou a execução. A segunda é o agente ou processo que decidiu chamar a ferramenta. A terceira é a identidade apresentada ao serviço externo, que pode ser um usuário delegado, uma conta de serviço, uma aplicação OAuth ou outro principal.
Misturar essas identidades pode levar a uma conclusão errada. Se o log do provedor mostra uma conta técnica, isso não significa necessariamente que aquela conta originou a intenção. Ela pode ter sido apenas a identidade usada para executar uma solicitação iniciada anteriormente por outra pessoa ou sistema.
Por isso, o identificador de uma execução precisa acompanhar a cadeia até onde for tecnicamente possível. Registros externos também podem ajudar. O Google Workspace Reports API, por exemplo, inclui campos de ator e informações sobre aplicações OAuth em seus registros de atividade; o audit log do GitHub pode registrar ator, ação, horário e, conforme o evento, informações sobre a forma de autenticação utilizada.
O objetivo não é escolher um único “culpado” no log, mas responder com precisão: quem iniciou, quem executou e com qual identidade a operação chegou ao destino.
Como provar o que o agente chamou
A camada de observabilidade do agente deve registrar a execução da ferramenta independentemente da conversa exibida ao usuário.
As convenções atuais de GenAI do OpenTelemetry, ainda classificadas como Development, definem um span específico para execução de ferramenta. Na convenção consultada, gen_ai.operation.name e gen_ai.tool.name são elementos centrais; um identificador de chamada pode ser registrado quando disponível, enquanto argumentos e resultados são campos opt-in.
Isso oferece um modelo útil para uma trilha técnica:
execução do agente → nome da ferramenta → ID da chamada → parâmetros → resultado ou erro.
Há, porém, uma restrição importante. As próprias convenções do OpenTelemetry alertam que instruções, mensagens, argumentos e resultados de ferramentas podem conter informações sensíveis. Instrumentar tudo indiscriminadamente pode transformar o sistema de observabilidade em um novo repositório de credenciais, dados pessoais ou conteúdo confidencial.
A solução não é abandonar parâmetros úteis para investigação, mas definir antecipadamente o que será registrado, mascarado, truncado ou excluído. Segredos e tokens não precisam ser armazenados em texto aberto para que uma chamada seja correlacionada.
Também é preciso diferenciar resultado da ferramenta de efeito comprovado. Uma resposta de sucesso pode indicar que uma API aceitou a solicitação, mas a confirmação do estado deve vir do sistema responsável pelo recurso sempre que isso for relevante para o incidente.
Como provar o que estava autorizado
Esta é uma das partes mais fáceis de reconstruir de forma incompleta.
Há pelo menos três níveis diferentes de autorização:
O grant ou credencial disponível. Mostra a capacidade que uma aplicação recebeu. No Google Workspace, por exemplo, os registros de OAuth podem mostrar eventos de autorização, negação e revogação, além dos escopos associados.
A decisão de política para aquela operação. Em arquiteturas que usam um mecanismo de autorização externo, o ideal é conservar uma decisão correlacionável. O Open Policy Agent, por exemplo, oferece decision logs que podem conter decision_id, trace_id, revisão do bundle de políticas, entrada fornecida à política, resultado da decisão e horário.
A decisão do sistema de destino. Mesmo que a aplicação tenha um token e uma política intermediária retorne “permitido”, a API final ainda pode aceitar, rejeitar ou tratar a solicitação de modo diferente.
Essa separação evita um erro recorrente: afirmar que “a ação estava autorizada” apenas porque o token possuía um escopo amplo. O escopo ajuda a explicar o limite de capacidade daquela credencial; a investigação da operação específica também precisa verificar a decisão aplicada naquele instante e a resposta do destino.
Um registro de autorização realmente útil deve permitir responder: qual principal pediu acesso, a qual recurso e operação, usando qual política, qual versão da política, qual decisão foi tomada e qual execução originou a consulta.
O provedor externo é a referência para saber se a ação aconteceu
Depois de identificar a chamada do agente, procure a mesma operação no sistema conectado.
No Google Drive, a Drive Activity API fornece histórico de atividades com elementos como ação, ator, alvo e horário. A documentação também alerta que nem toda atividade será necessariamente visível para todo usuário autenticado: a visibilidade pode depender das permissões sobre o objeto. Portanto, ausência em uma consulta específica não deve ser automaticamente interpretada como prova de que a ação nunca ocorreu.
Para ambientes Google Workspace administrados, o Drive Activity Report pode fornecer eventos de criação, edição, compartilhamento e outras atividades e documenta uma janela de consulta de até 180 dias.
No GitHub Enterprise Cloud, o audit log de organização registra atividades que afetam a organização e pode incluir ator, ação, repositório, horário, método de autenticação e outros campos conforme o evento. A documentação consultada informa uma retenção de 180 dias para a trilha geral da organização, enquanto eventos Git possuem condições específicas e retenção de apenas sete dias em determinados acessos ao audit log.
Esses prazos mostram por que a coleta não deve ficar para depois. A janela útil de investigação pode ser menor que a expectativa da equipe, e políticas ou produtos podem mudar. Retenção, licenciamento e disponibilidade de determinados eventos devem ser verificadas no provedor utilizado no momento do incidente.
O estado final exige mais do que encontrar um evento de sucesso
Encontrar a operação no audit log responde “uma alteração aconteceu”. Ainda falta responder “qual foi o resultado relevante?”.
Para isso, separe quatro pontos no tempo:
- o último estado conhecido antes da operação;
- o evento de alteração atribuído à execução investigada;
- o estado observado imediatamente depois, quando houver registro;
- o estado atual.
Essa separação evita atribuir ao agente uma alteração posterior feita por uma pessoa, webhook, workflow ou segundo agente.
Imagine um caso em que um agente de manutenção de repositórios tente alterar uma configuração. O trace confirma a chamada da ferramenta; a decisão de autorização confirma que aquela solicitação foi permitida; o audit log confirma uma mudança no repositório; horas depois, um administrador modifica a configuração novamente. O estado atual já não representa, sozinho, o efeito original do agente.
Quando o sistema oferecer versionamento, histórico de alterações, IDs de evento ou revisões do recurso, essas referências podem aumentar a confiança da reconstrução. Quando o estado anterior não puder ser recuperado, o relatório deve dizer isso explicitamente em vez de reconstruí-lo por suposição.
Monte a cronologia por evidência, não pela narrativa do agente
O relatório do incidente deve ordenar os eventos por timestamps normalizados e usar identificadores para ligá-los.
Uma sequência hipotética poderia mostrar que a tarefa foi iniciada em uma sessão autenticada, que uma execução específica do agente gerou uma chamada de ferramenta, que uma política retornou permissão, que o provedor recebeu a operação e que uma leitura posterior confirmou o novo estado.
O que importa é que cada passagem seja demonstrada por sua fonte adequada. Algumas combinações mudam bastante a conclusão:
- Há chamada de ferramenta, mas não há operação correspondente no provedor e o recurso não mudou: pode ter havido falha, bloqueio ou operação sem efeito. A chamada sozinha não comprova a alteração.
- Há mudança no provedor, mas não existe trace correspondente do agente: existe uma lacuna de telemetria ou a mudança pode ter outra origem. Não atribua causalidade apenas pela proximidade de horário.
- Há decisão “permitido”, mas a chamada falhou: a autorização existia, mas isso não prova execução bem-sucedida.
- Há uma mudança atribuída ao agente e outra mudança posterior feita por outro ator: preserve as duas; o estado atual não deve ser atribuído integralmente ao primeiro evento.
A orientação atual do NIST para resposta a incidentes enfatiza justamente a determinação da sequência de eventos e dos ativos envolvidos, em vez de depender de uma única fonte de evidência.
A confiança da reconstrução deve aparecer no relatório
Nem todos os incidentes terminarão com a mesma qualidade de prova.
Uma conclusão de alta confiança pode combinar identidade autenticada, trace correlacionado, chamada de ferramenta, decisão de autorização, evento do provedor e confirmação do estado.
Uma conclusão de confiança média pode ter uma lacuna — por exemplo, o provedor confirma a operação e o trace confirma a ferramenta, mas a decisão de política daquele instante não foi preservada.
Uma conclusão de baixa confiança depende principalmente de horário aproximado, conversa ou inferências sem IDs comuns entre as camadas.
Registrar essa diferença é mais útil do que preencher a lacuna com certeza artificial. O NIST recomenda preservar integridade e proveniência dos dados de incidente e também reconhece que evidência coletada deve ser tratada conforme procedimentos de retenção e preservação da organização.
Guardar tudo também é um risco
Observabilidade forense não significa registrar permanentemente todo prompt, documento, argumento de ferramenta e resposta de API.
Os dados mais ricos para depuração são justamente os que podem conter informações pessoais, conteúdo confidencial, segredos ou dados empresariais. As convenções de GenAI do OpenTelemetry assinalam explicitamente o risco de informações sensíveis em mensagens, instruções, argumentos e resultados.
O desenho de logs precisa equilibrar investigação e exposição: identificadores e metadados podem permanecer disponíveis por mais tempo, enquanto conteúdo sensível pode exigir mascaramento, acesso restrito ou retenção menor. Os próprios registros da investigação também precisam de proteção de confidencialidade e integridade, como recomenda a SP 800-61 Rev. 3.
O fechamento do incidente deve produzir controles para a próxima execução
Uma investigação útil não termina em “o agente errou”. Ela precisa identificar em qual camada o controle falhou.
Se a causa foi uma interpretação equivocada, pode ser necessário rever validação da intenção. Se a chamada de ferramenta recebeu parâmetros inadequados, a correção pode estar no contrato da ferramenta. Se a política autorizou mais do que deveria, entra a revisão de autorização. Se ninguém consegue dizer o que aconteceu porque os identificadores não atravessam as camadas, o problema também é de observabilidade.
É aqui que a pauta forense encontra a pauta preventiva. Depois de saber quais permissões contribuíram para o incidente, o próximo passo é revisar como limitar permissões antes do incidente, conectando este artigo a Agente com Drive, e-mail e GitHub: como aplicar menor privilégio sem inutilizar a automação.
No sentido inverso, o artigo preventivo pode apontar para este conteúdo com a âncora como investigar uma ação errada do agente. A URL do artigo existente não foi fornecida na pauta, por isso o link deve ser inserido no CMS sem inventar endereço.
O incidente pode ser considerado tecnicamente reconstruído quando a equipe consegue responder, com evidência e grau de confiança explícito: quem iniciou a execução, o que o agente chamou, o que foi autorizado, o que o provedor realmente executou e qual estado resultou da operação.