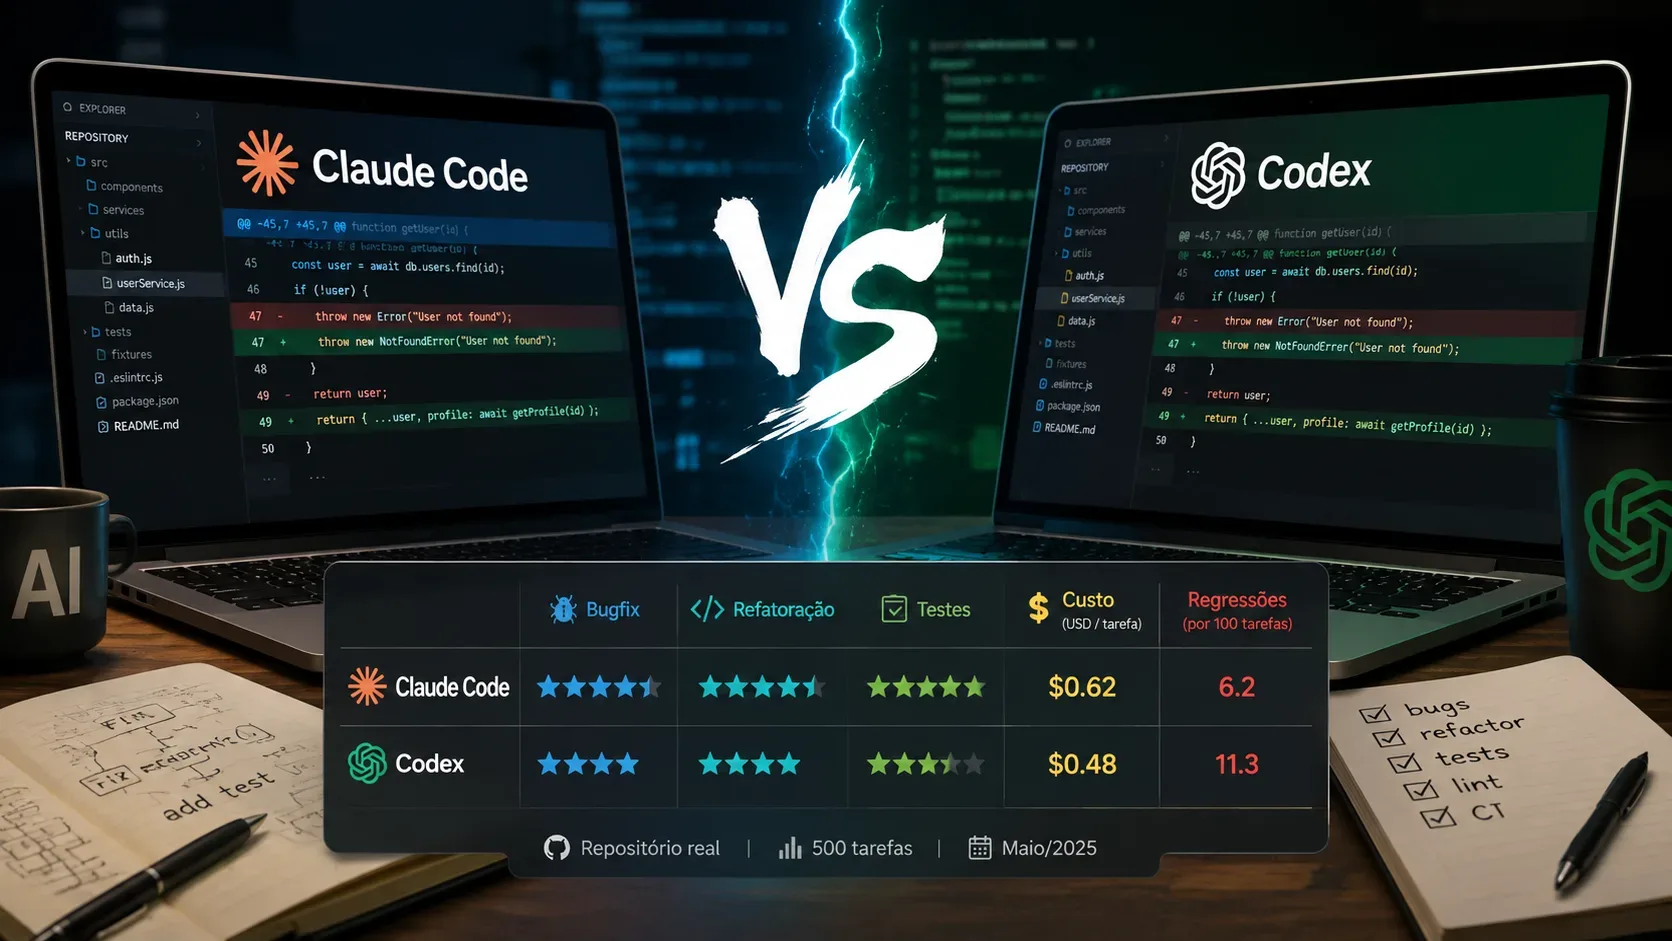
Resposta curta: em 1º de setembro de 2026, não existe evidência pública suficientemente ampla para afirmar que Claude Code ou Codex produz, de forma universal, menos regressões em repositórios reais. O melhor comparativo independente e atual entre os dois agentes mostra Claude Code com Opus 5 (xhigh) à frente no índice agregado de agentes de programação, com 68 pontos contra 65 do Codex com GPT-5.6 Sol (max). Ao mesmo tempo, o Codex vence a componente DeepSWE, custa menos por tarefa e termina as tarefas em menos da metade do tempo no mesmo levantamento. Isso é uma vantagem de eficiência, não uma prova de menor taxa de regressão.
Para escolher um agente para trabalho real, a pergunta mais útil não é “qual é melhor?”, mas “qual preserva melhor o comportamento do meu sistema, com o menor custo total de revisão?”. A resposta depende do tipo de mudança, da qualidade dos testes do repositório e da configuração usada pelo agente.
O que os benchmarks atuais realmente dizem
O comparativo mais útil hoje é o Artificial Analysis Coding Agent Index v1.4, porque mede o conjunto modelo + harness do agente, em vez de comparar apenas modelos isolados. Na configuração destacada pela página, Claude Code usa Opus 5 em esforço xhigh e Codex usa GPT-5.6 Sol em max.
| Métrica | Claude Code + Opus 5 xhigh | Codex + GPT-5.6 Sol max | Leitura correta |
|---|---|---|---|
| Coding Agent Index | 68 | 65 | Vantagem agregada de Claude Code na configuração testada |
| DeepSWE | 60% | 69% | Vantagem do Codex nessa avaliação de engenharia de software |
| Terminal-Bench v2.1 | 89% | 83% | Vantagem de Claude Code em tarefas agentivas de terminal |
| SWE-Atlas-QnA | 55% | 43% | Vantagem de Claude Code na avaliação de navegação e conhecimento de repositório |
| Custo médio por tarefa | US$ 8,17 | US$ 5,00 | Codex é mais barato nessa bateria |
| Tempo médio por tarefa | 23,7 min | 10,2 min | Codex termina em menos da metade do tempo |
O ponto importante é que nenhuma dessas métricas equivale diretamente a “regressões por alteração”. O índice agrega tarefas diferentes, e uma pontuação superior pode vir de melhor uso do terminal, melhor recuperação de falhas ou melhor entendimento do repositório sem necessariamente significar que o agente quebra menos comportamentos existentes.
O único sinal diretamente voltado a regressões é pequeno demais para decidir sozinho
Um benchmark independente chamado Gauntlet Bugfix testou seis issues com testes ocultos de resolução e também testes PASS_TO_PASS, que verificam se funcionalidades antes corretas continuam funcionando. Nessa rodada, Claude Code com Opus 4.8 e Codex CLI com GPT-5.5 resolveram 6 de 6 casos em modo estrito e ambos obtiveram 100% no componente de regressão. Claude Code ficou em 99 no composto e Codex em 98, diferença explicada principalmente por minimalidade do patch.
É uma evidência interessante porque mede algo próximo da pergunta central, mas seis issues são insuficientes para transformar o resultado em regra geral. Além disso, os modelos usados nessa rodada já não representam as configurações de ponta de setembro de 2026.
Outro benchmark pequeno aponta para o lado oposto
O projeto aberto Coding Agent Benchmark executa 11 tarefas sintéticas com testes ocultos, incluindo bugfix, refatoração e casos multifile. Na execução publicada com Claude Code usando Opus 4.6 e Codex usando GPT-5.4, o Codex passou completamente 11 de 11 tarefas e Claude Code 10 de 11, com correção média de 1,00 contra 0,99 e tempos praticamente empatados.
Esse resultado não contradiz necessariamente o Gauntlet: são tarefas, modelos e critérios diferentes. Na prática, os dois estudos pequenos mostram justamente por que “qual agente dá menos regressão?” não pode ser respondido com uma única porcentagem retirada da internet.
Bugfix: Codex tem um argumento forte, mas não uma vitória definitiva
Para correções de bugs com critérios claros e testes reproduzíveis, o Codex tem hoje um sinal favorável: no comparativo atual da Artificial Analysis, GPT-5.6 Sol no Codex marca 69% no DeepSWE contra 60% do Opus 5 no Claude Code. O Codex também executa a bateria com menor custo e tempo médio.
Isso sugere um bom encaixe para filas de issues independentes, manutenção de alto volume e tarefas em que você consegue validar objetivamente o resultado. Ainda assim, “passar o teste que falhava” não basta: o benchmark interno deve incluir testes que já passavam antes da mudança, porque são eles que detectam regressões colaterais.
Refatoração: a disciplina do diff importa mais que a taxa de acerto bruta
Em refatorações, o risco principal é alterar comportamento sem perceber. Um agente pode concluir a tarefa e até manter a suíte verde, mas ampliar o diff, renomear coisas fora do escopo ou mexer em contratos não cobertos por testes.
Por isso, uma comparação de refatoração deve pontuar também quantidade de arquivos tocados, linhas modificadas fora do escopo, mudanças de API pública, necessidade de retrabalho humano e cobertura do código alterado. O ganho agregado de Claude Code no índice atual e seu resultado superior em Terminal-Bench e SWE-Atlas-QnA são sinais úteis para tarefas que exigem exploração e contexto, mas não provam por si só que ele preserva melhor comportamento em uma refatoração específica.
Testes: medir “quantos testes foram escritos” é uma armadilha
Um agente pode aumentar a contagem de testes sem aumentar a capacidade de detectar defeitos. Para comparar Claude Code e Codex na criação de testes, prefira medir taxa de mutações detectadas, cobertura das linhas modificadas, testes de borda adicionados e quantos defeitos deliberadamente injetados a nova suíte captura.
Também vale impedir que o agente veja a suíte oculta usada para julgamento. Caso contrário, você mede adaptação ao avaliador, não robustez.
Custo: compare custo por patch aceito, não preço do plano
Custos de assinatura são difíceis de comparar de forma direta. Claude Code pode ser usado por assinaturas Claude e por cobrança de API; a própria documentação da Anthropic destaca que o consumo varia bastante conforme modelo, tamanho do repositório e padrão de uso. O guia de custos do Claude Code recomenda medir o uso real por piloto.
No Codex, o uso em contas ChatGPT é contabilizado em uma cota agentiva compartilhada e varia conforme modelo, duração, contexto, ferramentas e local de execução; a documentação de uso do Codex orienta consultar o painel de uso e os créditos disponíveis. Em 1º de setembro de 2026, as opções atuais de GPT-5.6 no Codex incluem Sol, Terra e Luna em planos elegíveis, após a retirada de GPT-5.4 e GPT-5.4 mini do Codex autenticado pelo ChatGPT em 31 de agosto.
Para um benchmark sério, a métrica econômica melhor é custo total por patch aceito: some a execução inicial, repetições, tentativas que falharam e tempo de revisão. O agente que custa menos por rodada pode sair mais caro se exigir duas correções manuais.
As diferenças de workflow também afetam regressões
Claude Code tem ferramentas integradas para leitura e edição de arquivos, busca, execução de comandos e testes, além de CLAUDE.md, hooks, subagentes e regras de permissão. A documentação de como o Claude Code funciona descreve o ciclo de executar testes, ler falhas, localizar código, editar e testar novamente. As permissões do Claude Code podem ser versionadas e combinadas com sandboxing em nível de sistema operacional.
O Codex também trabalha diretamente sobre repositórios, executa comandos e testes e pode ser orientado por arquivos AGENTS.md. A OpenAI documenta o uso de sandbox e políticas de aprovação no fluxo seguro do Codex; no CLI, os modos de sandbox incluem leitura apenas e escrita restrita ao workspace.
Esses controles importam porque uma parte das “regressões” em uso real não nasce de incapacidade de programar, mas de escopo mal definido: agente escrevendo fora do diretório esperado, instalando dependências desnecessárias ou alterando arquivos que não deveriam participar da tarefa.
Como fazer um benchmark que realmente responda à pergunta
Se a decisão for importante, teste os dois agentes no seu próprio repositório. Um protocolo mínimo pode usar 12 a 20 tarefas reais, distribuídas entre bugfix, refatoração e manutenção de testes, com três repetições por tarefa.
- Congele um commit inicial e restaure exatamente o mesmo estado antes de cada rodada.
- Use o mesmo prompt, timeout, permissões, acesso à rede e comandos de validação.
- Fixe os modelos e níveis de esforço; não compare um Claude antigo com um Codex novo e chame isso de comparação de ferramentas.
- Mantenha uma suíte oculta que o agente não pode editar nem inspecionar.
- Separe testes FAIL_TO_PASS, que provam que o bug foi corrigido, de testes PASS_TO_PASS, que verificam regressões.
- Registre diff final, arquivos tocados, comandos, duração, custo, tentativas, intervenções humanas e resultado dos testes.
- Faça a revisão do patch sem saber qual agente o produziu, quando possível.
Uma definição simples de taxa de regressão é: número de execuções que fazem pelo menos um teste previamente verde falhar dividido pelo total de execuções concluídas. Para refatorações, acrescente uma penalidade por alterações fora do escopo. Para testes, acrescente mutation score ou outra medida de poder de detecção.
Qual escolher hoje?
| Cenário | Escolha inicial | Por quê |
|---|---|---|
| Você quer a melhor pontuação agregada entre as configurações atuais comparadas | Claude Code + Opus 5 xhigh | Lidera o Coding Agent Index atual por 68 a 65 |
| Você quer throughput, menor custo e menor tempo por tarefa | Codex + GPT-5.6 Sol | US$ 5,00 e 10,2 min por tarefa na comparação, contra US$ 8,17 e 23,7 min |
| Bugfix com testes claros e fila grande de issues | Comece testando Codex | Vence DeepSWE no comparativo atual e tem melhor eficiência |
| Exploração pesada de repositório e workflow de terminal | Comece testando Claude Code | Leva vantagem em Terminal-Bench e SWE-Atlas-QnA |
| Refatoração de alto risco | Benchmark interno obrigatório | Os dados públicos não medem preservação de comportamento com precisão suficiente |
Conclusão: se você precisa escolher sem rodar teste próprio, Claude Code tem hoje uma pequena vantagem em qualidade agregada, enquanto Codex oferece uma vantagem clara de velocidade e custo e mostra força em engenharia de software no DeepSWE. Para a pergunta específica “qual altera um repositório com menos regressões?”, porém, a evidência direta é insuficiente e até os pequenos testes focados em regressão mostram empate. A escolha mais defensável é transformar regressão em métrica do seu CI e comparar os dois agentes sobre o mesmo conjunto de tarefas reais.