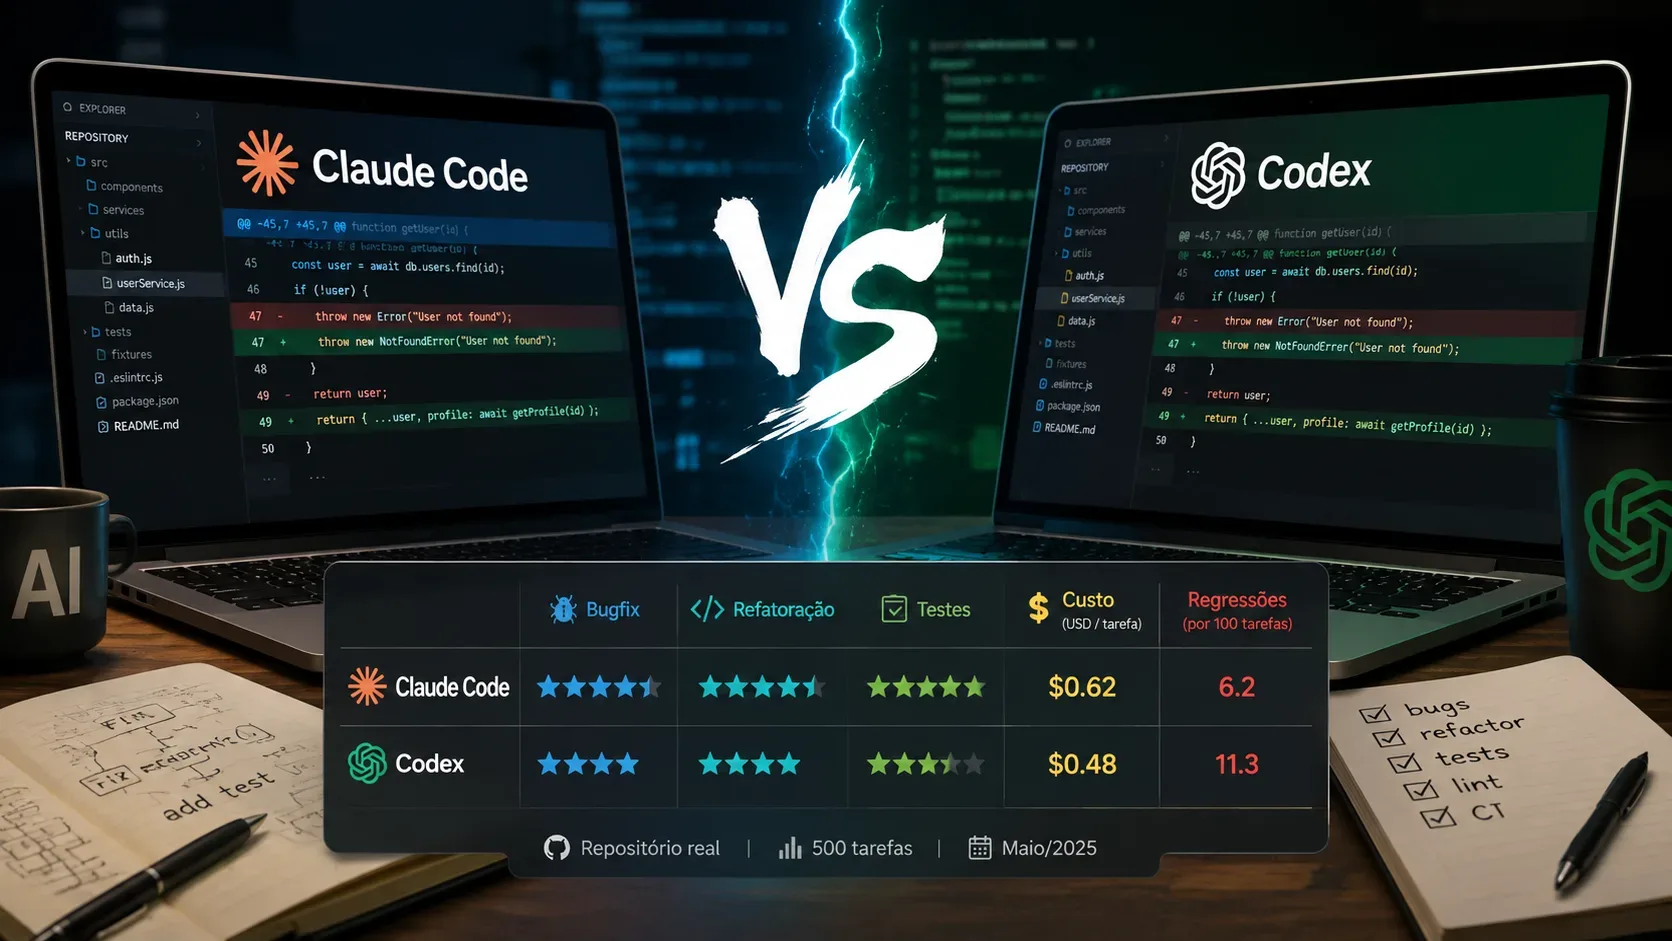
Respuesta corta: al 1 de septiembre de 2026, no existe evidencia pública lo bastante amplia como para afirmar que Claude Code o Codex produce, de forma universal, menos regresiones en repositorios reales. La comparación independiente y actual más sólida entre ambos agentes coloca a Claude Code con Opus 5 (xhigh) por delante en el índice agregado de agentes de programación, con 68 puntos frente a 65 de Codex con GPT-5.6 Sol (max). Al mismo tiempo, Codex lidera el componente DeepSWE, cuesta menos por tarea y termina las tareas en menos de la mitad del tiempo en la misma evaluación. Eso es una ventaja de eficiencia, no una prueba de una menor tasa de regresión.
Para trabajo de ingeniería real, la pregunta más útil no es “¿cuál es mejor?”, sino “¿cuál conserva mejor el comportamiento de mi sistema con el menor coste total de revisión?”. La respuesta depende del tipo de cambio, de la calidad de las pruebas del repositorio y de la configuración del agente.
Qué dicen realmente los benchmarks actuales
La comparación más útil hoy es el Artificial Analysis Coding Agent Index v1.4, porque evalúa la combinación modelo + harness del agente en lugar de comparar modelos aislados. En las configuraciones destacadas por la página, Claude Code usa Opus 5 con esfuerzo xhigh y Codex usa GPT-5.6 Sol en max.
| Métrica | Claude Code + Opus 5 xhigh | Codex + GPT-5.6 Sol max | Lectura correcta |
|---|---|---|---|
| Coding Agent Index | 68 | 65 | Ventaja agregada de Claude Code en la configuración probada |
| DeepSWE | 60% | 69% | Codex lidera esta evaluación de ingeniería de software |
| Terminal-Bench v2.1 | 89% | 83% | Claude Code lidera en tareas agentivas de terminal |
| SWE-Atlas-QnA | 55% | 43% | Claude Code lidera en navegación y conocimiento del repositorio |
| Coste medio por tarea | US$ 8,17 | US$ 5,00 | Codex es más barato en esta batería |
| Tiempo medio por tarea | 23,7 min | 10,2 min | Codex termina en menos de la mitad del tiempo |
El punto importante es que ninguna de estas métricas equivale directamente a “regresiones por cambio”. El índice combina tareas distintas, y una puntuación superior puede deberse a un mejor uso del terminal, recuperación ante fallos o comprensión del repositorio sin que eso signifique necesariamente que el agente rompa menos comportamientos existentes.
La señal más específica sobre regresiones es demasiado pequeña para decidir por sí sola
Un benchmark independiente llamado Gauntlet Bugfix probó seis issues con tests ocultos de resolución y también tests PASS_TO_PASS, que verifican que el comportamiento previamente correcto siga funcionando. En esa ejecución, Claude Code con Opus 4.8 y Codex CLI con GPT-5.5 resolvieron estrictamente 6 de 6 casos y ambos obtuvieron 100% en el componente de regresión. Claude Code obtuvo 99 en el compuesto y Codex 98, con la diferencia explicada principalmente por la minimalidad del parche.
Es una evidencia útil porque mide algo cercano a la pregunta central, pero seis issues no bastan para convertir el resultado en una regla general. Además, los modelos usados en esa ejecución ya no representan las configuraciones de frontera disponibles en septiembre de 2026.
Otro benchmark pequeño apunta en la dirección contraria
El proyecto abierto Coding Agent Benchmark ejecuta 11 tareas sintéticas con tests ocultos, incluyendo correcciones de bugs, refactorizaciones y casos multifile. En la ejecución publicada con Claude Code usando Opus 4.6 y Codex usando GPT-5.4, Codex pasó completamente 11 de 11 tareas y Claude Code 10 de 11, con una corrección media de 1,00 frente a 0,99 y tiempos casi idénticos.
Eso no contradice necesariamente a Gauntlet: las tareas, los modelos y las reglas de puntuación son diferentes. En la práctica, ambos estudios pequeños muestran precisamente por qué “¿qué agente causa menos regresiones?” no puede responderse con un único porcentaje tomado de internet.
Bugfix: Codex tiene un argumento fuerte, pero no una victoria definitiva
Para correcciones de bugs con criterios claros y pruebas reproducibles, Codex tiene hoy una señal favorable: en la comparación de Artificial Analysis, GPT-5.6 Sol en Codex alcanza 69% en DeepSWE frente a 60% de Opus 5 en Claude Code. Codex también ejecuta la batería con menor coste y tiempo medio.
Eso sugiere un buen encaje para colas de issues independientes, mantenimiento de alto volumen y trabajos que pueden validarse objetivamente. Sin embargo, “el test que fallaba ahora pasa” no es suficiente: el benchmark interno también debe incluir tests que ya estaban en verde antes del cambio, porque son los que detectan regresiones colaterales.
Refactorización: la disciplina del diff importa más que la tasa bruta de acierto
En refactorizaciones, el riesgo principal es cambiar el comportamiento sin darse cuenta. Un agente puede terminar la tarea solicitada y mantener en verde la suite visible, pero aun así ampliar el diff, renombrar código fuera de alcance o modificar contratos no cubiertos por tests.
Por eso, una comparación de refactorización debe puntuar también el número de archivos tocados, líneas modificadas fuera del alcance, cambios de API pública, retrabajo humano y cobertura del código alterado. La ventaja agregada de Claude Code en el índice actual y sus mejores resultados en Terminal-Bench y SWE-Atlas-QnA son señales útiles para tareas que requieren exploración y contexto, pero no demuestran por sí solas que conserve mejor el comportamiento en una refactorización concreta.
Tests: contar cuántas pruebas se escribieron es una trampa
Un agente puede aumentar el número de tests sin aumentar la capacidad de detectar defectos. Para comparar Claude Code y Codex en generación de pruebas, conviene medir mutation score, cobertura de las líneas modificadas, casos límite añadidos y cuántos defectos introducidos deliberadamente detecta la nueva suite.
También conviene impedir que el agente vea la suite oculta usada para evaluarlo. De lo contrario, se mide adaptación al evaluador, no robustez.
Coste: compara coste por parche aceptado, no precio del plan
Los precios de suscripción son difíciles de comparar de forma directa. Claude Code puede usarse mediante suscripciones de Claude y facturación por API, y la propia guía de costes de Claude Code destaca que el consumo varía mucho según el modelo, el tamaño del repositorio y el patrón de uso, por lo que recomienda un piloto para establecer una referencia real.
En Codex, el uso con una cuenta de ChatGPT consume una cuota agentiva compartida y varía según modelo, duración, contexto, herramientas y superficie de ejecución; la documentación de uso de Codex recomienda consultar el panel de uso y los créditos disponibles. Al 1 de septiembre de 2026, las opciones actuales de GPT-5.6 en Codex incluyen Sol, Terra y Luna en planes elegibles, después de que GPT-5.4 y GPT-5.4 mini se retiraran de Codex autenticado con ChatGPT el 31 de agosto.
Para un benchmark serio, la mejor métrica económica es el coste total por parche aceptado: suma la primera ejecución, repeticiones, intentos fallidos y tiempo de revisión. El agente más barato por ejecución puede terminar costando más si requiere dos rondas de corrección manual.
Las diferencias de workflow también pueden afectar las regresiones
Claude Code incluye herramientas para leer y editar archivos, buscar, ejecutar comandos y tests, además de CLAUDE.md, hooks, subagentes y reglas de permisos. La documentación sobre cómo funciona Claude Code describe un ciclo de ejecutar pruebas, leer fallos, localizar código, editar y volver a probar. Los permisos de Claude Code pueden versionarse y combinarse con sandboxing a nivel del sistema operativo.
Codex también trabaja directamente sobre repositorios, ejecuta comandos y tests y puede recibir instrucciones mediante archivos AGENTS.md. OpenAI documenta el sandbox y las políticas de aprobación en su guía sobre cómo ejecutar Codex de forma segura; en la CLI, los modos de sandbox incluyen solo lectura y escritura restringida al workspace.
Estos controles importan porque una parte de las “regresiones” reales no nace de una mala capacidad de programación, sino de un alcance mal delimitado: un agente que escribe fuera del directorio previsto, instala dependencias innecesarias o modifica archivos que no deberían formar parte de la tarea.
Cómo hacer un benchmark que realmente responda a la pregunta
Si la decisión es importante, prueba ambos agentes en tu propio repositorio. Un protocolo mínimo puede usar entre 12 y 20 tareas reales repartidas entre bugfix, refactorización y mantenimiento de tests, con tres repeticiones por tarea.
- Congela un commit base y restaura exactamente el mismo estado antes de cada ejecución.
- Usa el mismo prompt, timeout, permisos, acceso a red y comandos de validación.
- Fija los modelos y niveles de esfuerzo; no compares un Claude antiguo con un Codex nuevo y lo llames comparación de herramientas.
- Mantén una suite oculta que el agente no pueda editar ni inspeccionar.
- Separa los tests FAIL_TO_PASS, que demuestran que el bug fue corregido, de los PASS_TO_PASS, que detectan regresiones.
- Registra el diff final, archivos tocados, comandos, duración, coste, reintentos, intervenciones humanas y resultados de tests.
- Revisa el parche sin saber qué agente lo produjo siempre que sea posible.
Una definición simple de tasa de regresión es: número de ejecuciones completadas que hacen fallar al menos un test oculto previamente verde dividido por el total de ejecuciones completadas. Para refactorizaciones, añade una penalización por cambios fuera de alcance. Para generación de tests, añade mutation score u otra medida de capacidad para detectar defectos.
¿Cuál elegir hoy?
| Escenario | Elección inicial | Por qué |
|---|---|---|
| Quieres la mejor puntuación agregada entre las configuraciones actuales comparadas | Claude Code + Opus 5 xhigh | Lidera el Coding Agent Index actual por 68 a 65 |
| Quieres throughput, menor coste y menor tiempo por tarea | Codex + GPT-5.6 Sol | US$ 5,00 y 10,2 minutos por tarea en la comparación frente a US$ 8,17 y 23,7 minutos |
| Bugfix con tests claros y una gran cola de issues | Empieza probando Codex | Lidera DeepSWE en la comparación actual y es más eficiente |
| Exploración intensa del repositorio y workflow de terminal | Empieza probando Claude Code | Lidera Terminal-Bench y SWE-Atlas-QnA |
| Refactorización de alto riesgo | Benchmark interno obligatorio | Los datos públicos no miden la preservación del comportamiento con precisión suficiente |
Conclusión: si debes elegir sin ejecutar tu propia prueba, Claude Code tiene hoy una pequeña ventaja en calidad agregada, mientras que Codex ofrece una ventaja clara de velocidad y coste y muestra fortaleza en las tareas de ingeniería de software de DeepSWE. Sin embargo, para la pregunta específica “¿cuál modifica un repositorio con menos regresiones?”, la evidencia directa es insuficiente y hasta los pequeños tests centrados en regresiones muestran un empate. El enfoque más defendible es convertir la regresión en una métrica del CI y comparar ambos agentes sobre el mismo conjunto de tareas reales.