A resposta curta é: alguns detectores de IA aceitam português e afirmam ter sido treinados para esse idioma, mas isso não significa que um percentual exibido na tela prove quem escreveu o texto. Em agosto de 2026, GPTZero, Copyleaks e Winston AI declaram suporte a português. O detector da Grammarly é descrito pela própria empresa como desenvolvido para escrita em inglês. Já o relatório de escrita por IA do Turnitin só aceita inglês, espanhol e japonês, portanto português não deve ser tratado como um teste válido dessa ferramenta.
Essa diferença importa porque o problema não é apenas saber se o campo de texto aceita acentos. Um teste sério precisa medir falso positivo, falso negativo, efeito do tamanho do texto, estabilidade entre execuções e, principalmente, o que acontece quando um texto humano é apenas revisado por IA. Sem essa separação, um comparativo pode produzir números bonitos e ainda responder à pergunta errada.
Aceitar português não é o mesmo que demonstrar precisão em PT-BR
O GPTZero adicionou suporte a português em 2025 e publicou um benchmark interno no qual informou 99,2% de acurácia, 99,0% de recall e 0,64% de falso positivo para português. Esse dado é útil para entender a alegação do fabricante, mas continua sendo um teste interno: corpus, versão do modelo, critérios de corte e distribuição dos textos são definidos pelo próprio fornecedor. Ele não substitui uma replicação independente em português brasileiro.
O Copyleaks lista português, código pt, entre os 30 idiomas aceitos pelo seu detector de conteúdo por IA. O Winston AI também inclui português entre os idiomas suportados e informa que seus modelos são atualizados com frequência. Nos dois casos, a existência de suporte oficial é um ponto a favor da validade operacional do teste, mas não resolve sozinha a questão da confiabilidade em textos brasileiros reais.
A situação da Grammarly é diferente. A empresa ampliou recursos de escrita, correção e reescrita para português, mas sua própria comparação de detectores publicada em 2026
descreve o AI Detector como desenvolvido para escrita em inglês. Isso significa que uma pontuação obtida com PT-BR, mesmo que a interface permita colar o texto, precisa ser marcada como exploração fora do escopo explicitamente descrito para o detector, e não como evidência de desempenho validado em português.
No Turnitin, o limite é ainda mais claro. A documentação atual exige pelo menos 300 palavras de prosa e restringe o AI Writing Report a inglês, espanhol e japonês. Em português, o resultado correto do protocolo não é forçar uma pontuação: é registrar “idioma não suportado” e excluir a ferramenta da comparação quantitativa em PT-BR. Esse controle documental evita transformar ausência de suporte em falso fracasso ou, pior, em um número sem validade declarada pelo próprio produto.
Os percentuais não medem exatamente a mesma coisa
Outro erro comum é colocar quatro porcentagens lado a lado e tratá-las como se fossem probabilidades comparáveis. Não são necessariamente. Há ferramentas que estimam a fração do texto considerada gerada por IA, outras exibem um “human score”, outras classificam trechos ou combinam rótulos como humano, IA e misto. Os limiares também podem mudar entre versões e planos.
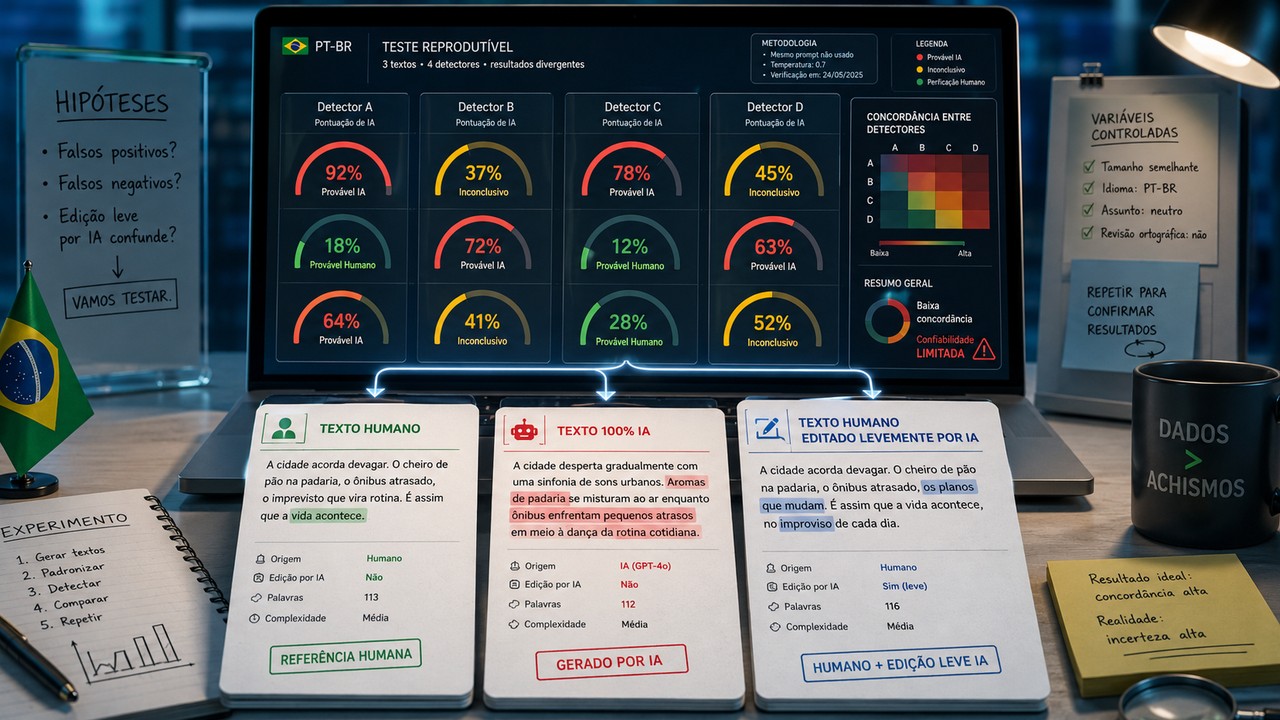
Por isso, um teste reproduzível deve guardar duas camadas de resultado. A primeira é o valor bruto exibido pelo detector, exatamente como aparece. A segunda é a classificação operacional do próprio produto, como “provável IA”, “humano”, “misto” ou equivalente. Só depois disso faz sentido calcular métricas. Converter todos os scores para uma escala inventada de 0 a 100 e tirar uma média apaga diferenças metodológicas e cria uma precisão que o dado original não possui.
Falso positivo e falso negativo são fáceis; texto humano revisado por IA não é
Falso positivo é o caso em que um texto de origem humana é classificado como IA. Falso negativo é o inverso: um texto integralmente gerado por IA passa como humano. Essas duas métricas funcionam quando a origem é binária e conhecida.
O problema aparece no terceiro grupo, cada vez mais comum: o autor escreveu o conteúdo, mas usou IA para corrigir gramática, clareza, fluidez ou estilo. Nesse cenário, chamar qualquer detecção de “falso positivo” pode ser metodologicamente errado, porque houve intervenção de IA; ao mesmo tempo, chamar o texto de “gerado por IA” apaga a autoria humana do conteúdo. O teste precisa tratar esse material como uma categoria própria e medir quanto a revisão altera o score em relação à versão humana original.
Pesquisas recentes mostram por que essa distinção não é teórica. Um estudo de agosto de 2026 com resumos acadêmicos em inglês encontrou que edições leves, feitas com uma instrução de refinamento, foram sinalizadas em 64% a 80% dos casos por Pangram e GPTZero. Os originais sem edição foram sinalizados em 9% a 15%. O mesmo trabalho mostrou que uma etapa posterior de “humanização” conseguia reduzir drasticamente a detecção de textos classificados como IA. O estudo não é em português e, portanto, não autoriza transportar esses percentuais para PT-BR, mas mostra como a fronteira entre autoria e superfície textual pode confundir o detector.
Outro trabalho de 2026, o ARB, separou explicitamente texto humano, geração direta por LLM, texto humano reescrito por LLM e texto de LLM reescrito pelo mesmo tipo de modelo. Em
detectores abertos testados com um ponto de operação de 1% de falso positivo, os melhores alcançaram recall acima de 91% para geração direta, mas caíram para aproximadamente 15% a 31% quando o texto original era humano e apenas havia sido reescrito por IA. O resultado reforça a necessidade de não misturar “quem criou o conteúdo” com “quem produziu a redação final”.
Estudos independentes também mostram que versão, modelo e domínio mudam o resultado
Um estudo publicado em 2026 no International Journal for Educational Integrity comparou GPTZero, Copyleaks, Turnitin e Pangram em 160 textos acadêmicos em inglês com origem conhecida. Naquele conjunto específico, todos os detectores classificaram corretamente os 40 textos totalmente humanos. Porém, para textos integralmente gerados com uma versão recente do Deep Research, GPTZero e Copyleaks subestimaram fortemente o conteúdo de IA, e Turnitin marcou os 40 textos como falsos negativos segundo o critério adotado pelos autores. Pangram teve desempenho muito melhor naquele experimento.
Esse resultado não é um ranking universal. Os textos eram longos, acadêmicos, em inglês, e foram gerados e testados em um período específico. As ferramentas são atualizadas. O valor do estudo é outro: ele demonstra que uma ferramenta pode parecer excelente em um benchmark e falhar quando muda o modelo gerador, o domínio ou a forma de construção do texto.
O benchmark RAID já havia chegado a uma conclusão semelhante em escala maior. Ao variar modelos, domínios, estratégias de geração e ataques, os autores encontraram perda de robustez em detectores que funcionavam bem em condições mais próximas do treinamento. Em outras palavras, “acurácia alta” só é informativa quando se sabe em quais textos, versões e condições ela foi medida.
Como montar um corpus PT-BR que permita um teste honesto
O primeiro passo é congelar o corpus antes de abrir qualquer detector. Se os textos forem escolhidos depois de ver os primeiros resultados, o teste fica vulnerável a seleção conveniente. Cada item deve receber um identificador permanente, contagem de palavras, data de criação e um registro de origem.
Textos humanos precisam de procedência verificável
Para o grupo humano, o ideal é usar textos de autores conhecidos ou participantes do teste com histórico de rascunho, data e consentimento para publicação. Textos anteriores à popularização dos grandes geradores também podem servir como controle, desde que o domínio e o estilo sejam comparáveis aos demais grupos. O que deve ser evitado é classificar como “humano” um texto anônimo encontrado na internet apenas porque parece humano.
Textos gerados por IA precisam ser pareados com as mesmas tarefas
O grupo integralmente gerado por IA deve responder às mesmas propostas usadas no grupo humano. Se os humanos escrevem sobre temas cotidianos e a IA produz ensaios acadêmicos, o detector pode aprender o domínio em vez da origem. O registro precisa guardar o modelo exato, a data, o prompt, a temperatura quando disponível e o texto bruto sem edição manual.
Também é importante usar mais de um modelo gerador. Um detector treinado para reconhecer padrões de uma família pode ter desempenho diferente em outra. Misturar resultados sem registrar o gerador impede descobrir se o erro veio do detector ou de uma mudança na distribuição dos textos.
Texto humano revisado por IA deve nascer de um par antes/depois
O terceiro grupo deve partir de um texto humano já congelado. A IA recebe uma instrução limitada, por exemplo corrigir gramática e clareza sem acrescentar fatos nem mudar a estrutura argumentativa. A versão original e a versão revisada permanecem ligadas pelo mesmo identificador. Assim é possível medir a variação do score causada pela edição, e não comparar textos diferentes como se fossem equivalentes.
O registro deve incluir quanto o texto mudou. Uma medida simples é a proporção de palavras alteradas, complementada por uma inspeção do diff. Isso permite separar correção leve de reescrita pesada, duas operações que podem produzir efeitos muito diferentes nos detectores.
Tamanho do texto deve ser uma variável controlada
Trechos curtos e textos longos não devem entrar na mesma média. Uma divisão prática é testar uma faixa curta, uma intermediária e uma longa com limites definidos antes da coleta. Por exemplo, 120 a 180 palavras, 350 a 500 palavras e 900 a 1.200 palavras. O número exato pode mudar, mas as faixas precisam ser iguais entre classes e permanecer congeladas.
Esse cuidado é especialmente importante porque algumas ferramentas impõem mínimos próprios. O Turnitin, por exemplo, exige 300 palavras de prosa para seu relatório de IA. Como português não é idioma suportado pelo produto, isso não entra no benchmark quantitativo de PT-BR, mas serve como lembrete de que “texto curto” pode estar fora do escopo de certos detectores.
Como executar o teste sem deixar a versão do produto escapar
Todos os detectores devem ser rodados no menor intervalo de tempo possível. Para cada execução, registre data, horário, plano usado, idioma selecionado, nome ou versão exibida pelo serviço, URL da ferramenta e uma captura do resultado. Se o produto não informa a versão do modelo, registre a data de acesso e qualquer nota de atualização pública disponível.
O mesmo texto deve ser enviado sem alterações de formatação que possam introduzir outra variável. Aspas, títulos, listas, quebras de linha e referências devem seguir uma regra única. Se o objetivo for testar apenas prosa, remova elementos não prosa antes de congelar o corpus e aplique a mesma regra a todos os itens.
Quando a ferramenta permite repetir a análise, vale executar o mesmo item mais de uma vez e registrar qualquer variação. Se os resultados forem idênticos, isso é informação. Se mudarem, a instabilidade também é resultado e não deve ser escondida por uma média automática.
Uma segunda rodada semanas depois pode medir deriva de versão, mas deve ser publicada como outro momento do experimento. Misturar o score antigo com o novo transforma atualização do produto em ruído estatístico.
As métricas que realmente respondem à pergunta
Para os textos humanos, a métrica central é a taxa de falso positivo: quantos foram classificados como IA entre todos os humanos. Para os textos integralmente gerados, a métrica central é a taxa de falso negativo: quantos escaparam como humanos entre todos os textos de IA. Também é útil publicar sensibilidade, especificidade e intervalos de confiança, em vez de apenas uma acurácia agregada.
A acurácia sozinha pode enganar. Se o corpus tiver muito mais textos humanos do que textos de IA, um detector conservador pode acertar a maioria simplesmente marcando quase tudo como humano. O relatório precisa mostrar a matriz de confusão por classe e por faixa de tamanho.
No grupo humano revisado por IA, as métricas devem ser pareadas. O dado mais informativo é quanto o score mudou do original para a versão revisada, quantos textos atravessaram o limiar de “IA” depois da edição e se diferentes detectores concordaram sobre os mesmos pares. Isso mede sensibilidade à intervenção de IA sem fingir que a autoria virou puramente binária.
Também convém publicar discordância entre ferramentas. Se um mesmo texto recebe 90% de IA em um serviço e “humano” em outro, essa divergência é um achado, não um problema a ser apagado. O leitor precisa ver que consenso entre detectores não é garantido e que um percentual isolado não tem significado universal.
O que já dá para concluir em português sem inventar um benchmark próprio
Primeiro, existe suporte declarado a português em GPTZero, Copyleaks e Winston AI. Isso permite incluí-los em um teste PT-BR, desde que o relatório deixe claro que “português” nem sempre significa uma calibração documentada separadamente para português brasileiro.
Segundo, a Grammarly hoje oferece vários recursos de escrita em português, mas descreve seu detector como desenvolvido para inglês. Uma eventual análise de PT-BR deve ser marcada como exploratória e não colocada no mesmo nível das ferramentas que declaram suporte de detecção ao idioma.
Terceiro, o Turnitin não oferece AI Writing Report para português. Em um comparativo brasileiro, a informação relevante é justamente essa limitação. Forçar o produto para produzir um número fora do idioma suportado seria menos rigoroso do que registrar “não aplicável”.
Quarto, estudos independentes de 2026 reforçam que detector nenhum deve ser resumido a uma taxa de acerto genérica. Desempenho muda com modelo gerador, domínio, edição e reescrita. Resultados em inglês são importantes para formular hipóteses e desenho experimental, mas não substituem um corpus brasileiro com procedência conhecida.
Detector de IA serve melhor como sinal de triagem do que como prova de autoria
A documentação dos próprios fornecedores converge em um ponto importante: o score precisa de contexto. A Grammarly afirma que nenhum detector consegue determinar de forma conclusiva se IA foi usada. O Turnitin reconhece a possibilidade de falsos positivos, oculta percentuais baixos por serem menos confiáveis e orienta que o indicador não seja usado sozinho para tomar medidas contra um estudante.
Para escola, universidade, editora ou empresa, isso muda a função do detector. Ele pode indicar quais textos merecem revisão adicional, mas a investigação deve considerar histórico de versões, fontes, rascunhos, processo de escrita, política de uso de IA e conversa com o autor. A ferramenta observa padrões estatísticos no texto final; ela não presencia a autoria.
Em português brasileiro, a pergunta útil não é “qual detector dá a porcentagem mais alta?”, e sim “qual detector mantém baixa taxa de falso positivo, baixa taxa de falso negativo e comportamento estável quando mudam tamanho, domínio, modelo gerador e nível de
edição?”. Só um teste congelado, pareado e versionado consegue responder isso sem transformar um score comercial em veredito.