La respuesta corta es: algunos detectores de IA aceptan el portugués y afirman haber sido entrenados para ese idioma, pero esto no significa que un porcentaje mostrado en la pantalla demuestre quién escribió el texto. En agosto de 2026, GPTZero, Copyleaks y Winston AI declaran su soporte al portugués. La propia empresa describe el detector de Grammarly como desarrollado para escribir en inglés. El informe de redacción de IA de Turnitin solo acepta inglés, español y japonés, por lo que el portugués no debe considerarse una prueba válida de esta herramienta.
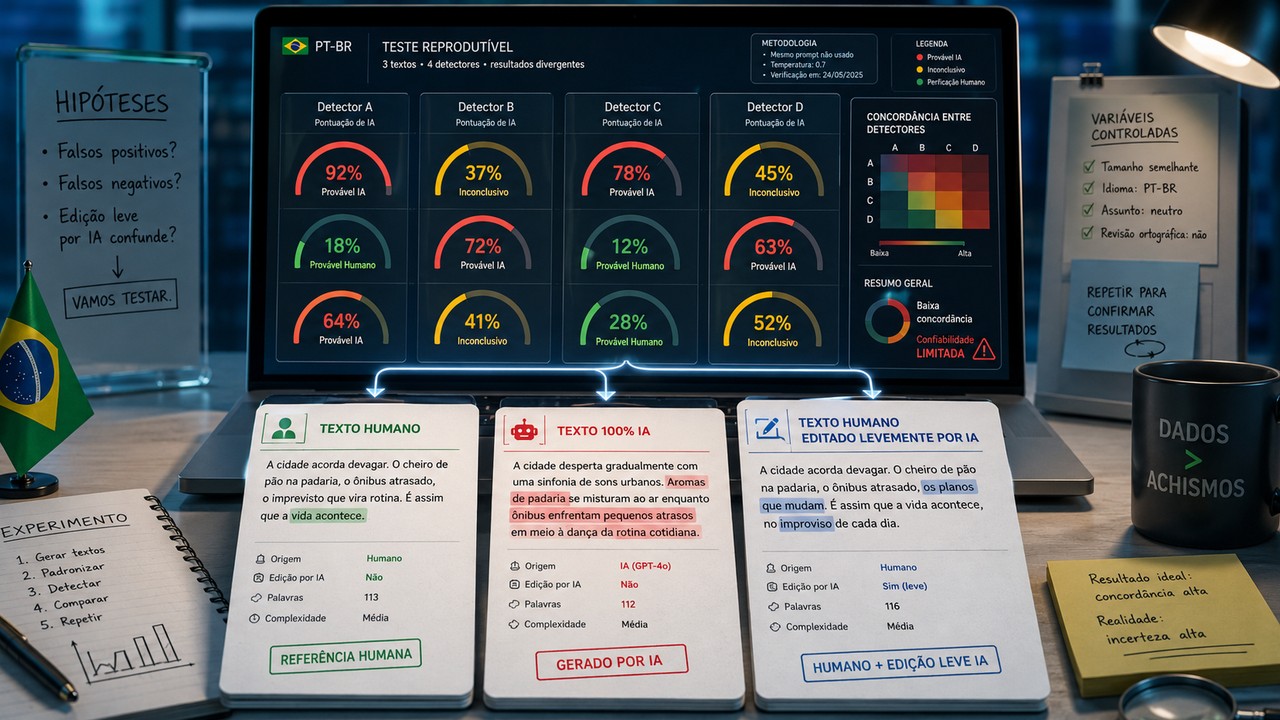
Esta diferencia es importante porque el problema no es solo si el campo de texto acepta acentos. Una prueba seria debe medir los falsos positivos, los falsos negativos, el efecto del tamaño del texto, la estabilidad entre ejecuciones y, lo más importante, qué sucede cuando la IA acaba de revisar un texto humano. Sin esta separación, una comparación puede producir números hermosos y aun así responder a la pregunta equivocada.
Aceptar el portugués no es lo mismo que demostrar precisión en PT-BR
GPTZero agregó compatibilidad con el portugués en 2025 y publicó un punto de referencia interno en el que informó un 99,2 % de precisión, un 99,0 % de recuperación y un 0,64 % de falsos positivos para el portugués. Estos datos son útiles para comprender la afirmación del fabricante, pero siguen siendo una prueba interna: el corpus, la versión del modelo, los criterios de corte y la distribución del texto los define el propio proveedor. No reemplaza una réplica independiente en portugués brasileño.
Copyleaks enumera el portugués, código pt, entre los 30 idiomas aceptados por su detector de contenido de IA. Winston AI también incluye el portugués entre los idiomas admitidos e informa que sus modelos se actualizan con frecuencia. En ambos casos, la existencia de respaldo oficial es un punto a favor de la validez operativa de la prueba, pero no resuelve por sí sola la cuestión de la confiabilidad en textos brasileños reales.
La situación de Grammarly es diferente. La empresa ha ampliado las capacidades de escritura, corrección y reescritura en portugués, pero publicará su propia comparación de detectores en 2026
describe AI Detector como diseñado para escribir en inglés. Esto significa que una puntuación obtenida con PT-BR, incluso si la interfaz permite pegar texto, debe marcarse como exploración fuera del alcance explícitamente descrito para el detector, y no como evidencia de desempeño validado en portugués.
En Turnitin, el límite es aún más claro. La documentación actual requiere al menos 300 palabras en prosa y restringe el Informe de redacción de IA a inglés, español y japonés. En portugués, el resultado correcto del protocolo no es forzar una puntuación: es registrar "lenguaje no soportado" y excluir la herramienta de la comparación cuantitativa en PT-BR. Este control documental evita convertir la falta de soporte en un falso fallo o, peor aún, en un número sin validez declarado por el propio producto.
Los porcentajes no miden exactamente lo mismo
Otro error común es poner cuatro porcentajes uno al lado del otro y tratarlos como si fueran probabilidades comparables. No lo son necesariamente. Hay herramientas que estiman la fracción de texto que se considera generada por IA, otras muestran una “puntuación humana”, otras clasifican extractos o combinan etiquetas como humano, IA y mixto. Los umbrales también pueden cambiar entre versiones y planes.
Por lo tanto, una prueba reproducible debe almacenar dos capas de resultados.. El primero es el valor bruto que muestra el detector, exactamente como aparece. La segunda es la clasificación operativa del propio producto, como “IA probable”, “humana”, “mixta” o equivalente. Sólo después de eso tiene sentido calcular métricas. Convertir todas las puntuaciones a una escala inventada de 0 a 100 y tomar un promedio borra las diferencias metodológicas y crea una precisión que los datos originales no poseen.
Los falsos positivos y los falsos negativos son fáciles; El texto humano revisado por IA no
Falso positivo es el caso en el que un texto de origen humano se clasifica como IA. El falso negativo es todo lo contrario: un texto íntegramente generado por IA pasa por humano. Estas dos métricas funcionan cuando la fuente es binaria y conocida.
El problema aparece en el tercer grupo, cada vez más común: el autor escribió el contenido, pero utilizó IA para corregir la gramática, la claridad, la fluidez o el estilo. En este escenario, calificar cualquier detección como “falso positivo” podría ser metodológicamente incorrecto, porque hubo intervención de IA; al mismo tiempo, llamar al texto “generado por IA” borra la autoría humana del contenido. La prueba debe tratar este material como su propia categoría y medir cuánto cambia la revisión la puntuación en relación con la versión humana original.
Investigaciones recientes muestran por qué esta distinción no es teórica. Un estudio de agosto de 2026 sobre resúmenes académicos en inglés encontró que Pangram y GPTZero señalaron ediciones ligeras, realizadas con una declaración de refinamiento, en entre el 64% y el 80% de los casos. Los originales sin editar se marcaron entre el 9% y el 15%. El mismo trabajo demostró que una etapa posterior de “humanización” pudo reducir drásticamente la detección de textos clasificados como IA. El estudio no está en portugués y, por lo tanto, no autoriza transportar estos porcentajes al PT-BR, pero muestra cómo la frontera entre autoría y superficie textual puede confundir al detector.
Otro trabajo de 2026, ARB, texto humano explícitamente separado, generación directa por LLM, texto humano reescrito por LLM y texto LLM reescrito por el mismo tipo de modelo. En
Los detectores abiertos se probaron con un punto de funcionamiento del 1 % de falsos positivos, la mejor recuperación lograda por encima del 91 % para la generación directa, pero se redujo a aproximadamente entre el 15 % y el 31 % cuando el texto original era humano y acababa de ser reescrito por IA. El resultado refuerza la necesidad de no mezclar “quién creó el contenido” con “quién produjo el escrito final”.
Estudios independientes también muestran que la versión, el modelo y el dominio cambian el resultado
Un estudio publicado en 2026 en el International Journal for Educational Integrity comparó GPTZero, Copyleaks, Turnitin y Pangram en 160 textos académicos en inglés con orígenes conocidos. En ese conjunto en particular, todos los detectores clasificaron correctamente los 40 textos totalmente humanos. Sin embargo, para los textos generados íntegramente con una versión reciente de Deep Research, GPTZero y Copyleaks subestimaron fuertemente el contenido de IA, y Turnitin marcó los 40 textos como falsos negativos según los criterios adoptados por los autores. Pangram tuvo un desempeño mucho mejor en ese experimento.
Este resultado no es una clasificación universal. Los textos fueron extensos, académicos, en inglés y fueron generados y probados en un período específico. Las herramientas están actualizadas.. El valor del estudio es diferente: demuestra que una herramienta puede parecer excelente en un benchmark y fallar cuando cambia el modelo generador, el dominio o la forma de construir el texto.
El benchmark RAID ya había llegado a una conclusión similar a mayor escala. Al variar modelos, dominios, estrategias de generación y ataques, los autores encontraron una pérdida de robustez en detectores que funcionaban bien en condiciones más cercanas al entrenamiento. En otras palabras, la “alta precisión” sólo es informativa cuando se sabe en qué textos, versiones y condiciones se midió.
Cómo montar un corpus PT-BR que permita realizar pruebas honestas
El primer paso es congelar el corpus antes de abrir cualquier detector. Si los textos se eligen después de ver los primeros resultados, la prueba es vulnerable a una selección conveniente. Cada elemento debe recibir un identificador permanente, un recuento de palabras, una fecha de creación y un registro de origen.
Los textos humanos necesitan procedencia verificable
Para el grupo humano, lo ideal es utilizar textos de autores conocidos o participantes de la prueba con borrador de historia, fecha y consentimiento para su publicación. Los textos anteriores a la popularización de los grandes generadores también pueden servir como control, siempre que el dominio y el estilo sean comparables a otros grupos. Lo que se debe evitar es clasificar como “humano” un texto anónimo encontrado en Internet sólo porque parece humano.
Los textos generados por IA deben combinarse con las mismas tareas
El grupo íntegramente generado por IA debe responder a las mismas propuestas utilizadas en el grupo humano. Si los humanos escriben sobre temas cotidianos y la IA produce ensayos académicos, el detector puede aprender el dominio en lugar de la fuente. El registro debe almacenar el modelo exacto, la fecha, el mensaje, la temperatura cuando esté disponible y el texto sin formato sin edición manual.
También es importante utilizar más de un modelo generador. Un detector entrenado para reconocer patrones de una familia puede funcionar de manera diferente en otra. Mezclar resultados sin registrar el generador impide saber si el error provino del detector o de un cambio en la distribución de los textos.
El texto humano revisado por IA debe nacer de un par antes/después
El tercer grupo debe partir de un texto humano ya congelado. La IA recibe instrucción limitada, por ejemplo corrigiendo la gramática y la claridad sin agregar hechos ni cambiar la estructura argumentativa. La versión original y la versión revisada permanecen vinculadas por el mismo identificador. De esta manera es posible medir la variación en la puntuación provocada por la edición, y no comparar diferentes textos como si fueran equivalentes.
El registro debe incluir cuánto ha cambiado el texto. Una medida simple es la proporción de palabras cambiadas, complementada con una inspección de la diferencia. Esto le permite separar la corrección ligera de la reescritura intensa, dos operaciones que pueden producir efectos muy diferentes en los detectores.
El tamaño del texto debe ser una variable controlada
No deben incluirse en el mismo promedio extractos breves y textos extensos. Una división práctica es probar un rango corto, intermedio y largo con límites definidos antes de la recopilación. Por ejemplo, de 120 a 180 palabras, de 350 a 500 palabras y de 900 a 1200 palabras. El número exacto puede cambiar, pero los rangos deben ser los mismos en todas las clases y permanecer congelados.
Este cuidado es especialmente importante porque algunas herramientas imponen sus propios mínimos. Turnitin, por ejemplo, exige 300 palabras en prosa para su informe sobre IA. Como el portugués no es un idioma admitido por el producto, esto no está incluido en el punto de referencia cuantitativo PT-BR, pero sirve como recordatorio de que el "texto breve" puede estar fuera del alcance de ciertos detectores.
Cómo ejecutar la prueba sin perder la versión del producto
Todos los detectores deben ejecutarse en el menor tiempo posible. Para cada ejecución, registre la fecha, hora, plan utilizado, idioma seleccionado, nombre o versión mostrada por el servicio, URL de la herramienta y una captura del resultado. Si el producto no indica la versión del modelo, registre la fecha de acceso y las notas de actualización públicas disponibles.
Se debe enviar el mismo texto sin cambios de formato que puedan introducir otra variable. Las comillas, títulos, listas, saltos de línea y referencias deben seguir una única regla. Si el objetivo es probar solo prosa, elimine los elementos que no sean prosa antes de congelar el corpus y aplique la misma regla a todos los elementos.
Cuando la herramienta le permite repetir el análisis, vale la pena ejecutar el mismo elemento más de una vez y registrar cualquier variación. Si los resultados son idénticos, eso es información. Si cambian, la inestabilidad también es el resultado y no debe ocultarse mediante un promedio automático.
Una segunda ronda semanas después puede medir la variación de la versión, pero debería publicarse como otro punto del experimento. Mezclar la puntuación anterior con la nueva convierte las actualizaciones de productos en ruido estadístico.
Las métricas que realmente responden a la pregunta
Para los textos humanos, la métrica central es la tasa de falsos positivos: cuántos fueron clasificados como IA entre todos los humanos. Para los textos completamente generados, la métrica central es la tasa de falsos negativos: cuántos escaparon como humanos entre todos los textos de IA. También resulta útil publicar intervalos de sensibilidad, especificidad e intervalos de confianza, en lugar de simplemente precisión agregada.
La precisión por sí sola puede engañar. Si el corpus tiene muchos más textos humanos que textos de IA, un detector conservador puede acertar en la mayoría de ellos simplemente marcando casi todo como humano. El informe debe mostrar la matriz de confusión por clase y por rango de talla.
En el grupo humano revisado por IA, las métricas deben estar emparejadas. Los datos más informativos son cuánto cambió la puntuación de la versión original a la revisada, cuántos textos cruzaron el umbral de "IA" después de la edición y si diferentes detectores coincidieron en los mismos pares. Esto mide la sensibilidad a la intervención de la IA sin pretender que la autoría se haya vuelto puramente binaria.
Es posible que también desee publicar desacuerdos entre herramientas. Si el mismo texto recibe un 90% de IA en un servicio y “humano” en otro, esta divergencia es un hallazgo, no un problema que deba eliminarse. El lector debe comprender que el consenso entre detectores no está garantizado y que un porcentaje aislado no tiene significado universal.
¿Qué puedes concluir en portugués sin inventar tu propio punto de referencia?
En primer lugar, se declara soporte para el portugués en GPTZero, Copyleaks y Winston AI. Esto les permite incluirse en una prueba PT-BR, siempre y cuando el informe deje claro que "portugués" no siempre significa una calibración documentada por separado para el portugués brasileño.
En segundo lugar, Grammarly ahora ofrece varias funciones de escritura en portugués, pero describe su detector como diseñado para inglés.. Cualquier análisis de PT-BR debe marcarse como exploratorio y no colocarse al mismo nivel que las herramientas que declaran soporte de detección para el lenguaje.
En tercer lugar, Turnitin no ofrece informes de redacción de IA en portugués. En una comparación brasileña, la información relevante es precisamente esta limitación. Obligar al producto a producir un número fuera del idioma admitido sería menos estricto que registrar "no aplicable".
En cuarto lugar, estudios independientes de 2026 refuerzan que ningún detector debe reducirse a una tasa de aciertos genérica. Cambios de rendimiento con generador de modelos, dominio, edición y reescritura. Los resultados en inglés son importantes para la formulación de hipótesis y el diseño experimental, pero no reemplazan un corpus brasileño de origen conocido.
El detector de IA sirve mejor como señal de detección que como prueba de autoría
La propia documentación de los proveedores converge en un punto importante: la puntuación necesita contexto. Grammarly afirma que ningún detector puede determinar de manera concluyente si se utilizó IA. Turnitin reconoce la posibilidad de falsos positivos, oculta porcentajes bajos porque son menos confiables y advierte que el indicador no debe usarse solo para tomar medidas contra un estudiante.
Para escuelas, universidades, editoriales o empresas, esto cambia la función del detector. Puede indicar qué textos merecen una revisión adicional, pero la investigación debe considerar el historial de versiones, las fuentes, los borradores, el proceso de redacción, la política de uso de la IA y la conversación con el autor. La herramienta observa patrones estadísticos en el texto final; ella no es testigo de la autoría.
En portugués brasileño, la pregunta útil no es “¿qué detector da el porcentaje más alto?”, sino más bien “¿qué detector mantiene una tasa baja de falsos positivos, una tasa baja de falsos negativos y un comportamiento estable al cambiar de tamaño, dominio, modelo generador y nivel
¿editar?” Sólo una prueba congelada, emparejada y versionada puede responder a esto sin convertir una puntuación comercial en un veredicto.