Não existe, nas fontes públicas consultadas até 28 de agosto de 2026, um benchmark de português brasileiro que coloque ChatGPT Images 2.0, Nano Banana 2 e Ideogram 4.0 sob os mesmos prompts, nas mesmas condições, e permita declarar um vencedor sem ressalvas. Os três modelos passaram a destacar texto, localização e peças de design como capacidades de produto, mas as evidências publicadas não são diretamente comparáveis.
Isso muda a resposta prática. Em vez de confiar em listas de “melhor IA”, quem precisa produzir pôster, banner, thumbnail ou card com preço correto deve medir duas coisas: quantos caracteres saem exatamente como o gabarito e quantas tentativas são necessárias até chegar a uma arte utilizável. A segunda métrica costuma ser tão importante quanto a primeira, porque um modelo que acerta depois de quatro regenerações ainda cria custo de revisão.
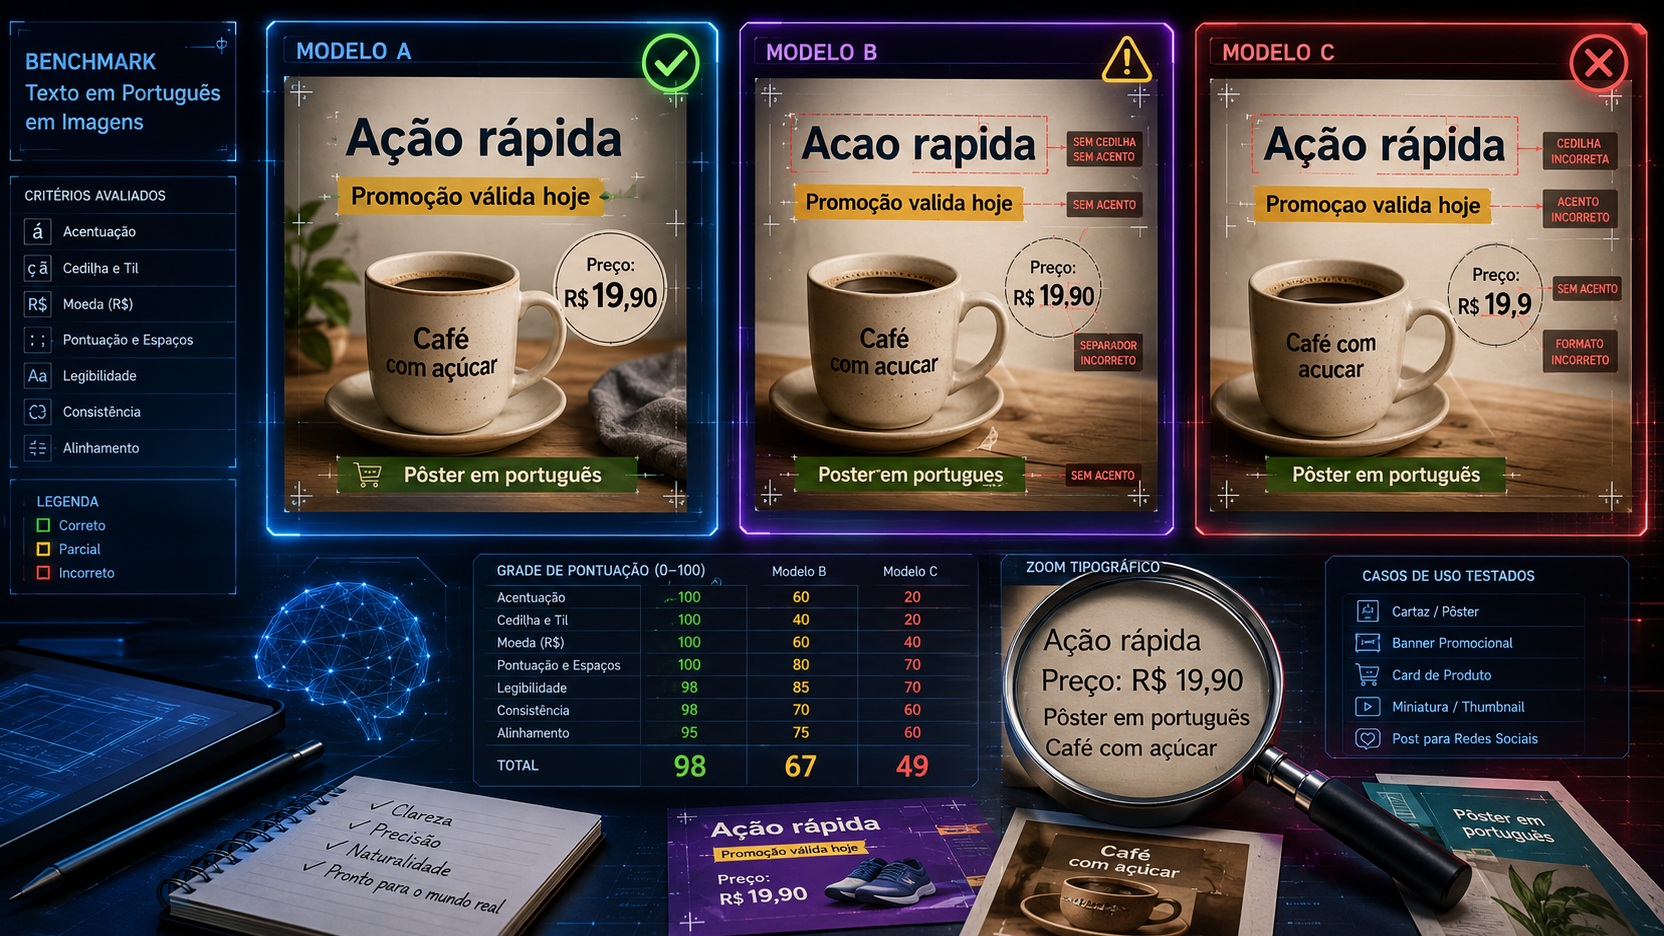
A capa deste artigo é uma ilustração conceitual. Os rótulos “Modelo A”, “Modelo B” e “Modelo C” e as pontuações visuais nela exibidas não são resultados medidos dos três produtos comparados.
O que mudou nos três modelos em 2026
ChatGPT Images 2.0 e o modelo gpt-image-2
A OpenAI apresentou o ChatGPT Images 2.0 em 21 de abril de 2026. Na API, o modelo correspondente aparece como gpt-image-2. A documentação de lançamento destaca melhor renderização de texto, layouts mais fortes e texto multilíngue mais confiável, além de posicionar o modelo para peças estruturadas como diagramas, infográficos, pôsteres e anúncios.
O guia de prompting da OpenAI é especialmente útil para quem trabalha com copy dentro da imagem. Ele recomenda colocar o texto literal entre aspas ou em caixa alta, pedir renderização verbatim, descrever fonte, tamanho, cor e posição e usar qualidade média ou alta quando houver texto pequeno ou denso. O próprio guia também sugere iterar quando a fidelidade tipográfica não vier perfeita na primeira saída.
Esse detalhe é importante: a documentação não promete erro zero. Ela descreve um fluxo de produção em que o texto pode ficar muito melhor, mas ainda precisa de verificação. Para PT-BR, isso significa olhar não só se a palavra parece legível, mas se “ação” não virou “acao”, se “preço” manteve a cedilha e se “R$ 19,90” não foi convertido para ponto decimal ou perdeu um dígito.
Nano Banana 2, o Gemini 3.1 Flash Image
O Google lançou o Nano Banana 2 em 26 de fevereiro de 2026. O nome técnico usado na API é Gemini 3.1 Flash Image, identificado como gemini-3.1-flash-image. A documentação atual do Gemini o trata como o modelo generalista da família para equilibrar velocidade, qualidade, geração em alta resolução e renderização de texto confiável.
No anúncio oficial, o Google fala em renderização e tradução de texto de precisão, com geração de texto legível para protótipos de marketing e possibilidade de localizar o conteúdo de uma imagem para outro idioma. Isso coloca o modelo diretamente no cenário deste comparativo: banners, cards promocionais, infográficos e outras peças em que a copy precisa fazer parte da própria composição visual.
A vantagem operacional prometida é velocidade de modelo Flash sem abrir mão dos recursos de geração mais sofisticados da linha. Para uma equipe que precisa produzir muitas variações, essa combinação pode reduzir o tempo de iteração. Ainda assim, “texto confiável” na documentação não equivale a uma taxa conhecida de acerto em português brasileiro.
Ideogram 4.0 e o controle explícito de tipografia
O Ideogram 4.0 foi lançado em 3 de junho de 2026 como um modelo open-weight de 9,3 bilhões de parâmetros. A empresa o apresenta como voltado a design, com texto multilíngue, controle preciso de layout e saída de até 2K. O ponto mais diferente, para peças com copy, está no mecanismo de prompt estruturado: o modelo aceita elementos de texto com a string literal separada da descrição visual e pode
posicioná-los por caixas delimitadoras.
Na prática, esse desenho dá ao usuário uma forma mais explícita de dizer “este texto deve aparecer aqui” do que um prompt puramente narrativo. O material técnico do Ideogram também divulga 0,97 de acurácia de OCR em inglês no benchmark X-Omni para renderização de texto. É um dado relevante, mas tem duas limitações para esta pauta: é uma avaliação publicada pelo próprio fornecedor e mede inglês, não PT-BR.
Por isso, o Ideogram 4.0 pode ser o candidato mais interessante quando o requisito central é controle tipográfico e posicionamento, mas esse atributo não prova sozinho que ele cometerá menos erros de acentuação, cedilha, moeda e pontuação em português do Brasil.
Por que um benchmark em inglês não resolve o português brasileiro
Português brasileiro adiciona armadilhas que um placar genérico de OCR pode não capturar. “Ação”, “promoção”, “coração”, “não” e “informação” exigem que o modelo preserve acentos, cedilha e til. Uma peça de varejo ainda pode combinar isso com “R$”, vírgula decimal, porcentagem, data e abreviações como “2ª unidade”.
Há também diferença entre legibilidade e fidelidade. Uma palavra pode estar visualmente bonita e perfeitamente reconhecível, mas conter um caractere errado. Para publicidade, comércio eletrônico ou material institucional, esse tipo de erro é mais grave que uma escolha de kerning menos elegante. Um “R$ 199,90” transformado em “R$ 19,90” é legível e, ao mesmo tempo, incorreto.
Outro problema é a variabilidade. Modelos de geração de imagem não produzem sempre a mesma saída. Um exemplo perfeito em uma página de lançamento não revela quantas tentativas falharam antes dele, nem como o mesmo modelo se comportará com um bloco maior de texto, outra proporção ou uma combinação de palavras menos frequentes.
Como deveria ser um benchmark PT-BR realmente verificável
Teste de acentuação e cedilha
Um primeiro prompt pode pedir um cartaz simples com as frases “Ação rápida”, “Café com açúcar” e “Coração e emoção”. O objetivo não é julgar beleza, e sim conferir caractere por caractere se os diacríticos sobreviveram e se o modelo não trocou letras, duplicou palavras ou introduziu sinais extras.
Teste de preço, porcentagem e ordinal
Um segundo prompt deve simular uma peça promocional com “Promoção válida hoje”, “Preço: R$ 19,90” e “2ª unidade com 50%”. Esse conjunto força o modelo a lidar com cedilha, acento, símbolo de moeda, vírgula decimal, símbolo ordinal e porcentagem na mesma arte.
Teste de texto pequeno e várias linhas
Um terceiro cenário deve usar copy mais densa, como “Entrega grátis para compras acima de R$ 149,90. Válido até 31/08. Não cumulativo.” Aqui aparece a dificuldade que costuma derrubar bons resultados de headline: texto menor, pontuação variada e mais oportunidades de omissão ou repetição.
Teste de hierarquia visual
Outro prompt pode pedir uma headline grande, um subtítulo médio e uma observação pequena, mantendo exatamente o conteúdo fornecido. Isso separa duas competências: escrever corretamente e obedecer à hierarquia do layout. Um modelo pode acertar todas as palavras e ainda colocar a informação crítica pequena demais ou em posição inadequada.
Teste de repetibilidade
Cada prompt precisa ser gerado mais de uma vez. Um desenho simples e já útil seria produzir três saídas por prompt e registrar o desempenho da primeira tentativa e o desempenho após regenerações. Dessa forma, o benchmark não premia apenas a melhor imagem escolhida a dedo; ele mede também
consistência.
O que pontuar sem transformar o teste em opinião
A pontuação principal deveria vir do gabarito textual. Cada saída pode ser revisada por substituições, omissões e inserções de caracteres, além de erros de espaço, pontuação e duplicação de palavras. A taxa de acerto na primeira geração merece ficar separada da taxa de acerto após novas tentativas.
OCR pode ajudar a automatizar a conferência, mas não deve ser o único juiz. O próprio OCR pode errar ao ler uma imagem correta, especialmente em tipografia decorativa. O ideal é usar OCR como triagem e fazer revisão humana do texto exibido na peça.
Também convém registrar legibilidade e fidelidade de layout em eixos separados. Assim, um modelo não recebe nota alta apenas porque produziu uma arte bonita, e outro não é penalizado excessivamente por uma escolha estética quando o texto está tecnicamente perfeito.
Qual escolher hoje para pôsteres, banners e thumbnails
Se a prioridade é ter controle explícito sobre posição e blocos de texto, o Ideogram 4.0 merece ser o primeiro candidato a testar. Seus elementos de texto tipados e caixas de layout são uma diferença concreta de interface e arquitetura para quem trabalha com design estruturado. Isso é uma vantagem de controle, não um placar PT-BR já comprovado.
Se o fluxo depende de editar uma peça existente, traduzir ou localizar texto sem reconstruir todo o layout e iterar conversacionalmente, o gpt-image-2 tem orientação oficial bastante detalhada para esse tipo de trabalho. A OpenAI recomenda o modelo para fluxos com texto em imagem e pede cópia literal, restrições tipográficas e qualidade maior nos casos densos.
Se a operação prioriza velocidade, alto volume e integração com o ecossistema Gemini, o Nano Banana 2 é o candidato natural do Google. A documentação o posiciona justamente como o equilíbrio entre velocidade e qualidade e destaca texto legível e localização como capacidades centrais.
A escolha mais segura, portanto, não é “qual marca ganhou um ranking geral”, e sim qual modelo tem a menor taxa de erro e o menor custo de correção no seu conjunto real de peças. Para uma loja, isso pode ser preço e promoção. Para um canal de vídeo, pode ser título curto em thumbnail. Para um evento, pode ser data, horário e endereço.
A métrica que mais importa: retrabalho
Para uso comercial, o melhor modelo não é necessariamente o que produz a imagem mais bonita na primeira comparação visual. É o que chega a texto correto, layout aceitável e arte aproveitável com menos regenerações e menos edição manual.
Esse “imposto de correção” pode ser medido em tempo: quantos minutos um designer gasta revisando texto, refazendo uma palavra, regenerando a peça ou exportando novamente. Quando dois modelos têm qualidade visual parecida, essa diferença operacional costuma decidir qual deles realmente escala.
Conclusão: ainda não há vencedor PT-BR demonstrado
ChatGPT Images 2.0, Nano Banana 2 e Ideogram 4.0 chegaram a 2026 com avanços explícitos em texto dentro de imagens. A OpenAI enfatiza renderização multilíngue e fluxos de produção com copy exata. O Google destaca texto preciso, legível e localizável em velocidade Flash. O Ideogram aposta em tipografia multilíngue e controles estruturados de texto e layout.
O que falta é justamente o teste que interessa ao usuário brasileiro: mesmos prompts, mesmo gabarito, várias gerações e contagem objetiva de erros em PT-BR. Sem isso, qualquer ranking definitivo mistura marketing, exemplos escolhidos e benchmarks em outros idiomas.
Até que um teste controlado produza esse placar, a recomendação prática é escolher dois ou três candidatos, aplicar seu próprio conjunto de frases críticas e medir acerto de primeira, número de regenerações e tempo de correção. Para texto dentro de imagem, a IA “melhor” é a que reduz retrabalho sem alterar uma única letra do que precisava ser publicado.
Fontes e limites deste comparativo
A base factual deste artigo foi formada por materiais oficiais publicados pela OpenAI sobre ChatGPT Images 2.0 e gpt-image-2, pelo guia de prompting dos modelos de imagem da OpenAI, pela documentação da Gemini API e pelo anúncio do Nano Banana 2 do Google, além do comunicado e do material técnico do Ideogram 4.0. As páginas foram consultadas em 28 de agosto de 2026.
Essas fontes são adequadas para confirmar nomes, datas, recursos declarados e mecanismos de controle, mas não substituem um benchmark independente em português brasileiro. O número de OCR citado pelo Ideogram mede inglês e foi divulgado pelo próprio fornecedor. Por isso, ele não foi convertido em um ranking de PT-BR nem usado para atribuir um vencedor.