No existe, entre las fuentes públicas consultadas hasta el 28 de agosto de 2026, un benchmark de portugués de Brasil que coloque ChatGPT Images 2.0, Nano Banana 2 e Ideogram 4.0 bajo los mismos prompts, en las mismas condiciones, y permita declarar un ganador sin salvedades. Los tres modelos pasaron a destacar el texto, la localización y las piezas de diseño como capacidades de producto, pero las evidencias publicadas no son directamente comparables.
Eso cambia la respuesta práctica. En vez de confiar en listas de la "mejor IA", quien necesita producir un póster, banner, thumbnail o card con el precio correcto debe medir dos cosas: cuántos caracteres salen exactamente como en el texto de referencia y cuántos intentos hacen falta para llegar a una pieza utilizable. La segunda métrica suele ser tan importante como la primera, porque un modelo que acierta después de cuatro regeneraciones sigue generando un costo de revisión.
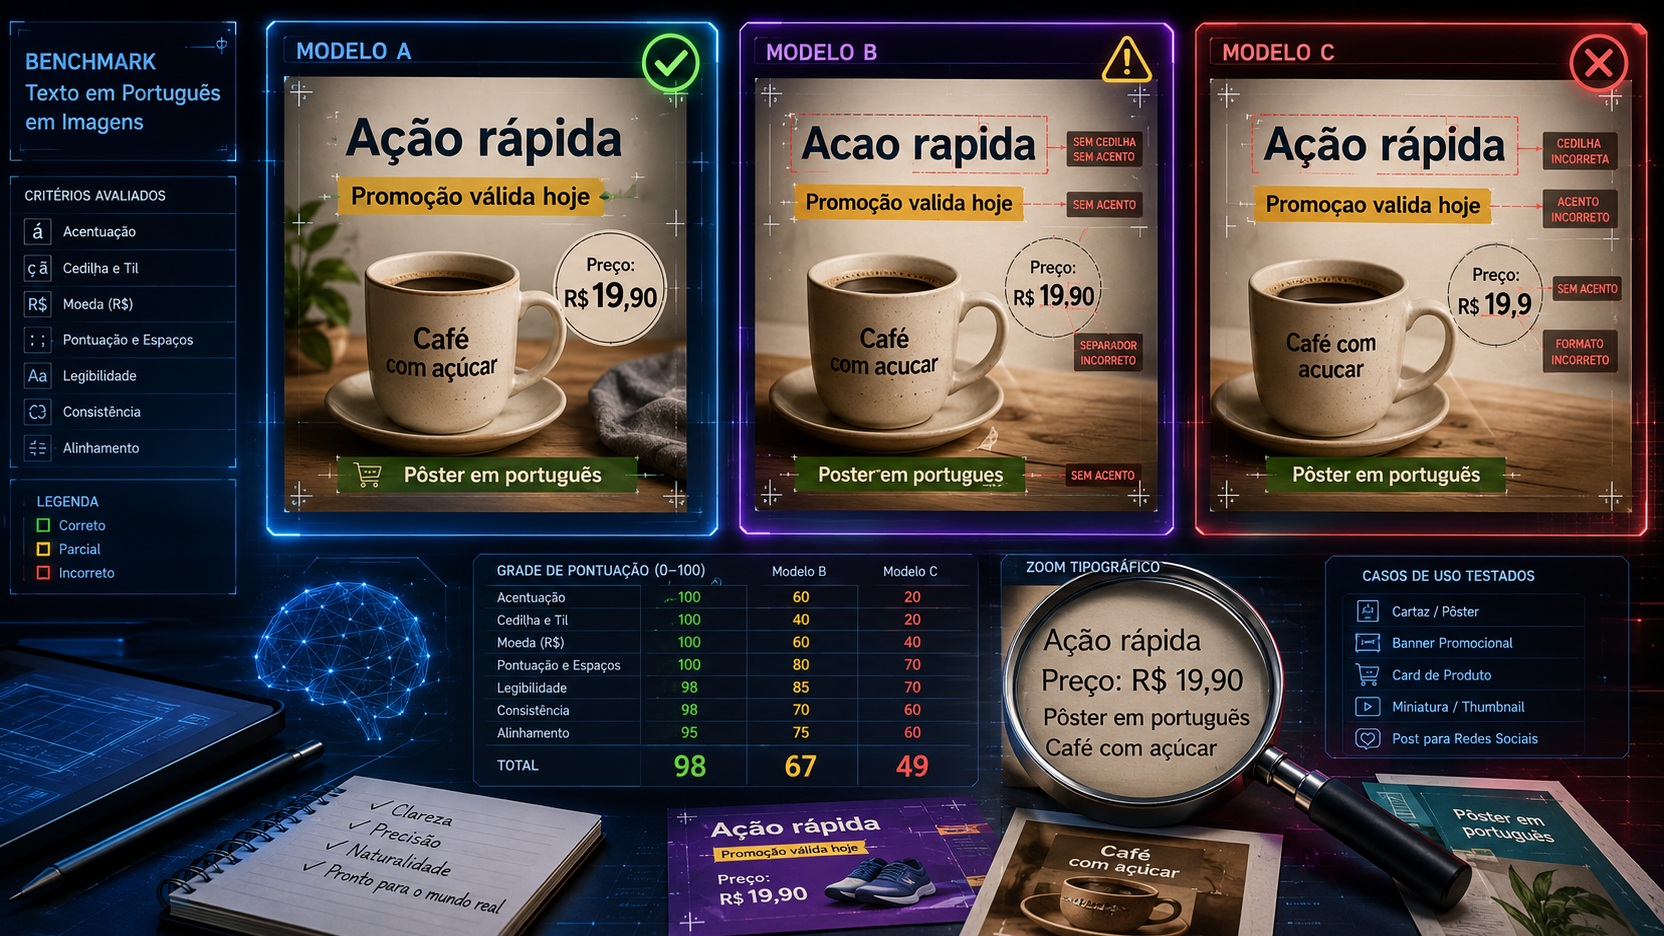
La portada de este artículo es una ilustración conceptual. Las etiquetas "Modelo A", "Modelo B" y "Modelo C", y las puntuaciones visuales que aparecen en ella, no son resultados medidos de los tres productos comparados.
Qué cambió en los tres modelos en 2026
ChatGPT Images 2.0 y el modelo gpt-image-2
OpenAI presentó ChatGPT Images 2.0 el 21 de abril de 2026. En la API, el modelo correspondiente aparece como gpt-image-2. La documentación de lanzamiento destaca una mejor renderización de texto, diseños más sólidos y texto multilingüe más fiable, además de posicionar el modelo para piezas estructuradas como diagramas, infografías, pósteres y anuncios.
La guía de prompting de OpenAI es especialmente útil para quienes trabajan con copy dentro de la imagen. Recomienda colocar el texto literal entre comillas o en mayúsculas, pedir renderización verbatim, describir fuente, tamaño, color y posición, y usar calidad media o alta cuando haya texto pequeño o denso. La propia guía también sugiere iterar cuando la fidelidad tipográfica no sea perfecta en la primera salida.
Ese detalle es importante: la documentación no promete error cero. Describe un flujo de producción en el que el texto puede mejorar mucho, pero todavía necesita verificación. Para PT-BR, eso significa comprobar no solo si la palabra parece legible, sino si "ação" no se convirtió en "acao", si "preço" conservó la cedilla y si "R$ 19,90" no se transformó en un valor con punto decimal o perdió un dígito.
Nano Banana 2, el Gemini 3.1 Flash Image
Google lanzó Nano Banana 2 el 26 de febrero de 2026. El nombre técnico usado en la API es Gemini 3.1 Flash Image, identificado como gemini-3.1-flash-image. La documentación actual de Gemini lo trata como el modelo generalista de la familia para equilibrar velocidad, calidad, generación en alta resolución y renderización fiable de texto.
En el anuncio oficial, Google habla de renderización y traducción de texto de precisión, con generación de texto legible para prototipos de marketing y la posibilidad de localizar el contenido de una imagen a otro idioma. Eso coloca el modelo directamente en el escenario de esta comparativa: banners, cards promocionales, infografías y otras piezas en las que el copy necesita formar parte de la propia composición visual.
La ventaja operativa prometida es la velocidad de un modelo Flash sin renunciar a los recursos de generación más sofisticados de la línea. Para un equipo que necesita producir muchas variaciones, esa combinación puede reducir el tiempo de iteración. Aun así, "texto fiable" en la documentación no equivale a una tasa conocida de acierto en portugués de Brasil.
Ideogram 4.0 y el control explícito de la tipografía
Ideogram 4.0 se lanzó el 3 de junio de 2026 como un modelo open-weight de 9.300 millones de parámetros. La empresa lo presenta como orientado al diseño, con texto multilingüe, control preciso del layout y salida de hasta 2K. El punto más diferente, para piezas con copy, está en el mecanismo de prompt estructurado: el modelo acepta elementos de texto con la cadena literal separada de la
descripción visual y puede posicionarlos mediante cajas delimitadoras.
En la práctica, ese diseño ofrece al usuario una forma más explícita de decir "este texto debe aparecer aquí" que un prompt puramente narrativo. El material técnico de Ideogram también divulga una precisión OCR de 0,97 en inglés en el benchmark X-Omni para renderización de texto. Es un dato relevante, pero tiene dos limitaciones para esta pauta: es una evaluación publicada por el propio proveedor y mide inglés, no PT-BR.
Por eso, Ideogram 4.0 puede ser el candidato más interesante cuando el requisito central es el control tipográfico y el posicionamiento, pero ese atributo no demuestra por sí solo que cometerá menos errores de acentuación, cedilla, moneda y puntuación en portugués de Brasil.
Por qué un benchmark en inglés no resuelve el portugués de Brasil
El portugués de Brasil añade dificultades que una puntuación genérica de OCR puede no captar. "Ação", "promoção", "coração", "não" e "informação" exigen que el modelo conserve acentos, cedilla y tilde. Una pieza de retail todavía puede combinar eso con "R$", coma decimal, porcentaje, fecha y abreviaturas como "2ª unidade".
También hay una diferencia entre legibilidad y fidelidad. Una palabra puede verse visualmente bonita y ser perfectamente reconocible, pero contener un carácter equivocado. Para publicidad, comercio electrónico o material institucional, ese tipo de error es más grave que una elección de kerning menos elegante. Un "R$ 199,90" transformado en "R$ 19,90" es legible y, al mismo tiempo, incorrecto.
Otro problema es la variabilidad. Los modelos de generación de imágenes no producen siempre la misma salida. Un ejemplo perfecto en una página de lanzamiento no revela cuántos intentos fallaron antes, ni cómo se comportará el mismo modelo con un bloque de texto más grande, otra proporción o una combinación de palabras menos frecuentes.
Cómo debería ser un benchmark PT-BR realmente verificable
Prueba de acentuación y cedilla
Un primer prompt puede pedir un cartel sencillo con las frases "Ação rápida", "Café com açúcar" y "Coração e emoção". El objetivo no es juzgar la belleza, sino comprobar carácter por carácter si los diacríticos sobrevivieron y si el modelo no cambió letras, duplicó palabras o introdujo signos extra.
Prueba de precio, porcentaje y ordinal
Un segundo prompt debe simular una pieza promocional con "Promoção válida hoje", "Preço: R$ 19,90" y "2ª unidade com 50%". Este conjunto obliga al modelo a lidiar con cedilla, acento, símbolo de moneda, coma decimal, indicador ordinal y porcentaje en la misma pieza.
Prueba de texto pequeño y varias líneas
Un tercer escenario debe usar un copy más denso, como "Entrega grátis para compras acima de R$ 149,90. Válido até 31/08. Não cumulativo." Aquí aparece la dificultad que suele arruinar buenos resultados de headline: texto más pequeño, puntuación variada y más oportunidades de omisión o repetición.
Prueba de jerarquía visual
Otro prompt puede pedir una headline grande, un subtítulo mediano y una observación pequeña, manteniendo exactamente el contenido proporcionado. Eso separa dos competencias: escribir correctamente y obedecer la jerarquía del layout. Un modelo puede acertar todas las palabras y aun así colocar la información crítica demasiado pequeña o en una posición inadecuada.
Prueba de repetibilidad
Cada prompt debe generarse más de una vez. Un diseño simple y ya útil sería producir tres salidas por prompt y registrar el rendimiento del primer intento y el rendimiento después de regeneraciones. De ese modo, el benchmark no premia solo la mejor imagen elegida a mano;
también mide consistencia.
Qué puntuar sin convertir la prueba en opinión
La puntuación principal debería venir del texto de referencia. Cada salida puede revisarse por sustituciones, omisiones e inserciones de caracteres, además de errores de espacios, puntuación y duplicación de palabras. La tasa de acierto en la primera generación merece quedar separada de la tasa de acierto tras nuevos intentos.
El OCR puede ayudar a automatizar la comprobación, pero no debe ser el único juez. El propio OCR puede equivocarse al leer una imagen correcta, especialmente con tipografías decorativas. Lo ideal es usar OCR como triage y hacer revisión humana del texto mostrado en la pieza.
También conviene registrar legibilidad y fidelidad de layout en ejes separados. Así, un modelo no recibe una nota alta solo porque produjo una pieza bonita, y otro no es penalizado en exceso por una decisión estética cuando el texto está técnicamente perfecto.
Cuál elegir hoy para pósteres, banners y thumbnails
Si la prioridad es tener control explícito sobre la posición y los bloques de texto, Ideogram 4.0 merece ser el primer candidato a probar. Sus elementos de texto tipados y cajas de layout son una diferencia concreta de interfaz y arquitectura para quien trabaja con diseño estructurado. Es una ventaja de control, no una puntuación PT-BR ya demostrada.
Si el flujo depende de editar una pieza existente, traducir o localizar texto sin reconstruir todo el layout e iterar conversacionalmente, gpt-image-2 tiene una orientación oficial bastante detallada para ese tipo de trabajo. OpenAI recomienda el modelo para flujos con texto en imagen y pide copy literal, restricciones tipográficas y mayor calidad en los casos densos.
Si la operación prioriza velocidad, alto volumen e integración con el ecosistema Gemini, Nano Banana 2 es el candidato natural de Google. La documentación lo posiciona precisamente como el equilibrio entre velocidad y calidad y destaca el texto legible y la localización como capacidades centrales.
La elección más segura, por tanto, no es "qué marca ganó un ranking general", sino qué modelo tiene la menor tasa de error y el menor costo de corrección en su conjunto real de piezas. Para una tienda, puede ser precio y promoción. Para un canal de video, puede ser un título corto en thumbnail. Para un evento, puede ser fecha, hora y dirección.
La métrica que más importa: retrabajo
Para uso comercial, el mejor modelo no es necesariamente el que produce la imagen más bonita en la primera comparación visual. Es el que llega a texto correcto, layout aceptable y pieza utilizable con menos regeneraciones y menos edición manual.
Ese "impuesto de corrección" puede medirse en tiempo: cuántos minutos dedica un diseñador a revisar texto, rehacer una palabra, regenerar la pieza o exportar de nuevo. Cuando dos modelos tienen una calidad visual parecida, esa diferencia operativa suele decidir cuál de ellos realmente escala.
Conclusión: todavía no hay un ganador PT-BR demostrado
ChatGPT Images 2.0, Nano Banana 2 e Ideogram 4.0 llegaron a 2026 con avances explícitos en texto dentro de imágenes. OpenAI enfatiza la renderización multilingüe y los flujos de producción con copy exacto. Google destaca texto preciso, legible y localizable a velocidad Flash. Ideogram apuesta por la tipografía multilingüe y los controles estructurados de texto y layout.
Lo que falta es precisamente la prueba que interesa al usuario brasileño: los mismos prompts, el mismo texto de referencia, varias generaciones y un conteo objetivo de errores en PT-BR. Sin eso, cualquier ranking definitivo mezcla marketing, ejemplos seleccionados y benchmarks en otros idiomas.
Hasta que una prueba controlada produzca esa puntuación, la recomendación práctica es elegir dos o tres candidatos, aplicar su propio conjunto de frases críticas y medir acierto al primer intento, número de regeneraciones y tiempo de corrección. Para texto dentro de una imagen, la IA "mejor" es la que reduce el retrabajo sin cambiar una sola letra de lo que tenía que publicarse.
Fuentes y límites de esta comparativa
La base factual de este artículo se formó con materiales oficiales publicados por OpenAI sobre ChatGPT Images 2.0 y gpt-image-2, la guía de prompting de los modelos de imagen de OpenAI, la documentación de la API de Gemini y el anuncio de Nano Banana 2 de Google, además del comunicado y el material técnico de Ideogram 4.0. Las páginas se consultaron el 28 de agosto de 2026.
Estas fuentes son adecuadas para confirmar nombres, fechas, recursos declarados y mecanismos de control, pero no sustituyen un benchmark independiente en portugués de Brasil. La cifra de OCR citada por Ideogram mide inglés y fue divulgada por el propio proveedor. Por eso, no se convirtió en un ranking de PT-BR ni se usó para atribuir un ganador.