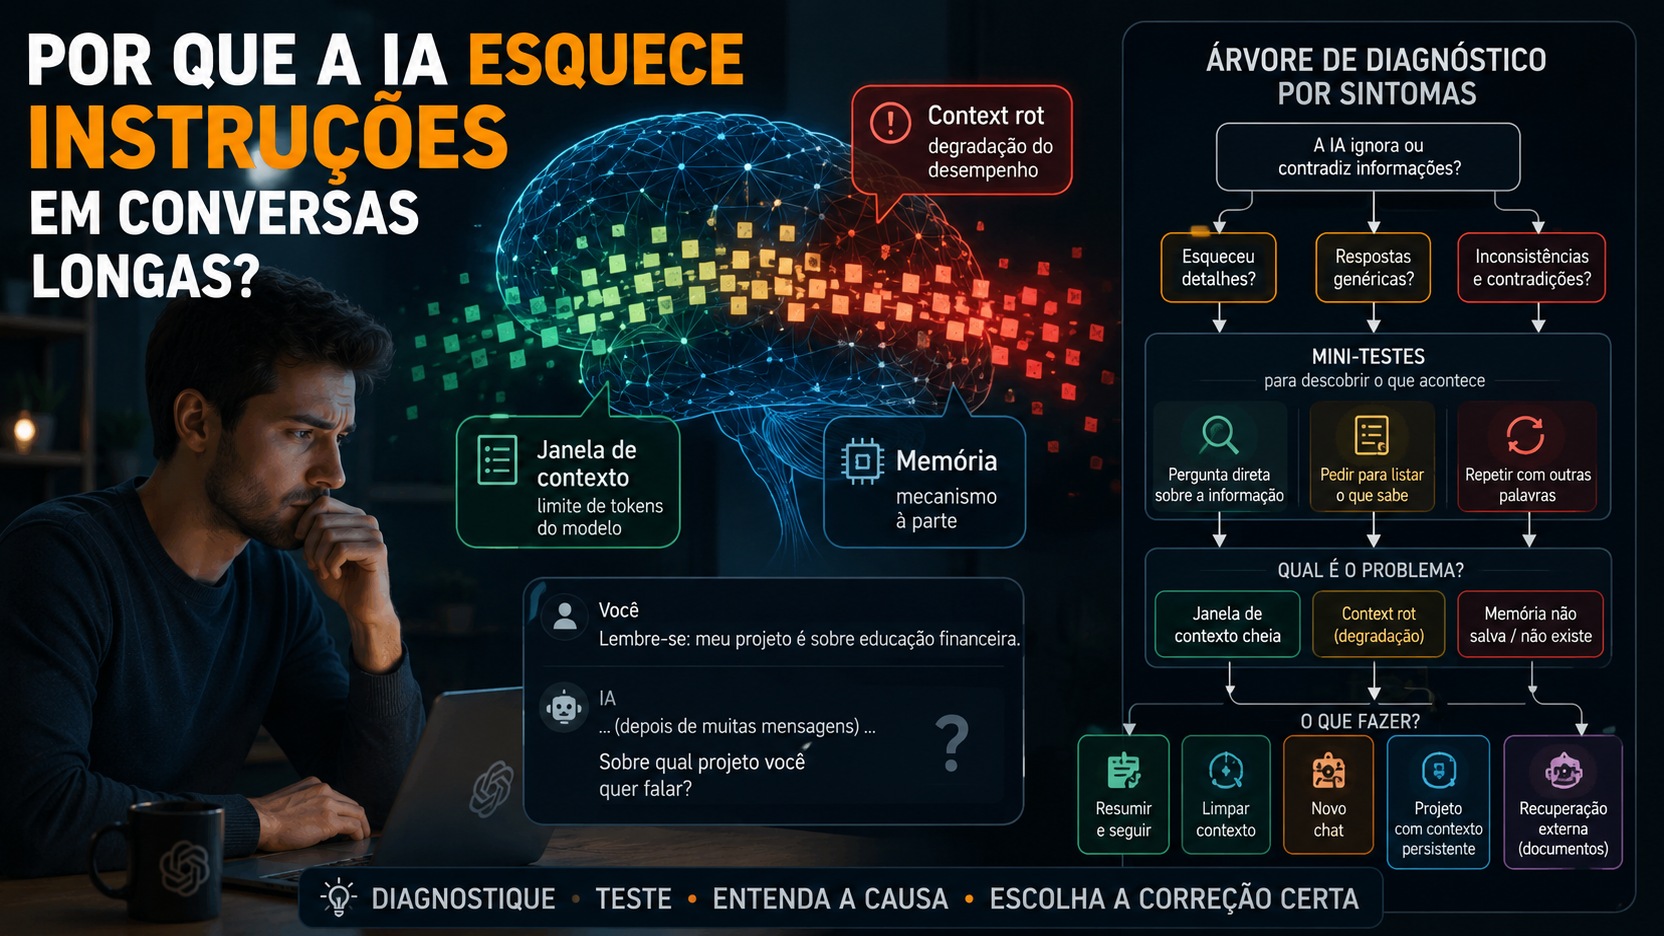
Se uma conversa ficou longa e a IA começou a ignorar uma regra que obedecia antes, “ela esqueceu” descreve o sintoma, não a causa. Quatro problemas diferentes podem produzir a mesma sensação: a informação deixou de fazer parte do contexto efetivamente usado naquela resposta; a informação continua no contexto, mas ficou mais difícil de recuperar ou aplicar; há instruções antigas e novas competindo entre si; ou você esperava que um recurso de memória persistente guardasse algo que ele não foi feito para preservar com precisão operacional.
A diferença importa porque a correção muda. Se o problema é excesso de contexto, acrescentar mais lembretes pode piorar o ruído. Se é uma instrução contraditória, abrir um novo chat sem resolver a contradição apenas transporta o erro. Se é memória, insistir em uma conversa interminável não transforma automaticamente histórico em armazenamento confiável. O diagnóstico mais útil começa separando janela de contexto, context rot e memória.
Janela de contexto não é a mesma coisa que memória
A janela de contexto é o conjunto de informação que o modelo pode usar ao gerar uma resposta naquele momento. Documentações atuais da Anthropic e do Google descrevem esse espaço como uma espécie de memória de trabalho ou memória de curto prazo. Ele inclui as instruções e mensagens que chegam ao modelo, além de outros elementos que o produto ou a API pode inserir, como arquivos, resultados de ferramentas e instruções de sistema.
Isso não é o mesmo que o conhecimento adquirido no treinamento e também não é, por si só, um arquivo permanente da conversa. Uma interface pode administrar chats longos com estratégias próprias, como manter um histórico rolante, compactar trechos ou resumir partes antigas. Por isso, o tamanho nominal da janela de um modelo não permite concluir sozinho que cada frase de um chat muito longo continuará chegando intacta e com o mesmo peso em todas as respostas.
Quando a informação realmente saiu do contexto ativo, o modelo não consegue recuperá-la apenas “se esforçando mais”. É como pedir que ele consulte uma página que já não está no material entregue para aquela rodada. Nesse caso, a solução é recolocar o estado necessário em uma forma curta e autoritativa, em vez de repetir toda a conversa.
Context rot pode acontecer antes de a janela ficar cheia
Context rot é um problema diferente. A própria documentação da Anthropic usa o termo para a queda de precisão e de recuperação à medida que a quantidade de tokens no contexto aumenta. O ponto central é este: o modelo pode ainda aceitar o contexto e, mesmo assim, usá-lo pior.
Essa diferença já aparece em pesquisa experimental. O estudo Lost in the Middle, publicado em 2024 na Transactions of the Association for Computational Linguistics, mostrou que modelos de contexto longo podem ter desempenho muito diferente conforme a posição da informação relevante, com piora frequente quando ela fica no meio de entradas extensas. Trabalhos posteriores também encontraram degradação com o aumento do comprimento do contexto mesmo quando a tarefa continua dentro do limite declarado do modelo.
Isso não significa que exista um número universal de tokens a partir do qual toda IA “apodrece”. Modelos, tarefas e interfaces se comportam de maneiras diferentes. O termo é útil para nomear um padrão de degradação, não para criar uma fronteira matemática igual para ChatGPT, Claude e Gemini.
Na prática, context rot costuma parecer mais sutil do que um corte brusco. A IA ainda reconhece o projeto, mas perde uma restrição. Ainda encontra um fato, mas mistura versões. Ainda sabe a regra, mas produz uma resposta genérica que não a aplica. É por isso que apenas perguntar “você lembra?”
não basta para diagnosticar o problema.
Memória persistente resolve outro tipo de necessidade
Memória é um mecanismo separado para levar informações úteis de uma interação para outras. No ChatGPT, por exemplo, a documentação da OpenAI trata memória, histórico de chats, arquivos e instruções como fontes distintas que podem contribuir para personalização. A própria página de memória avisa que o resumo mostrado ao usuário não necessariamente contém tudo o que pode ser lembrado, e que detalhes podem ser atualizados ou sintetizados ao longo do tempo.
Isso torna memória adequada para preferências e informações relativamente estáveis, como idioma, formato favorito ou contexto pessoal recorrente. Ela é menos apropriada como substituta de um estado de projeto que precisa permanecer literal, completo e auditável. “Sempre responda em português” é um bom candidato a persistência. “Use exatamente a versão 17 deste briefing, com estas seis exceções e estes quatro números” pede uma fonte de verdade mais explícita.
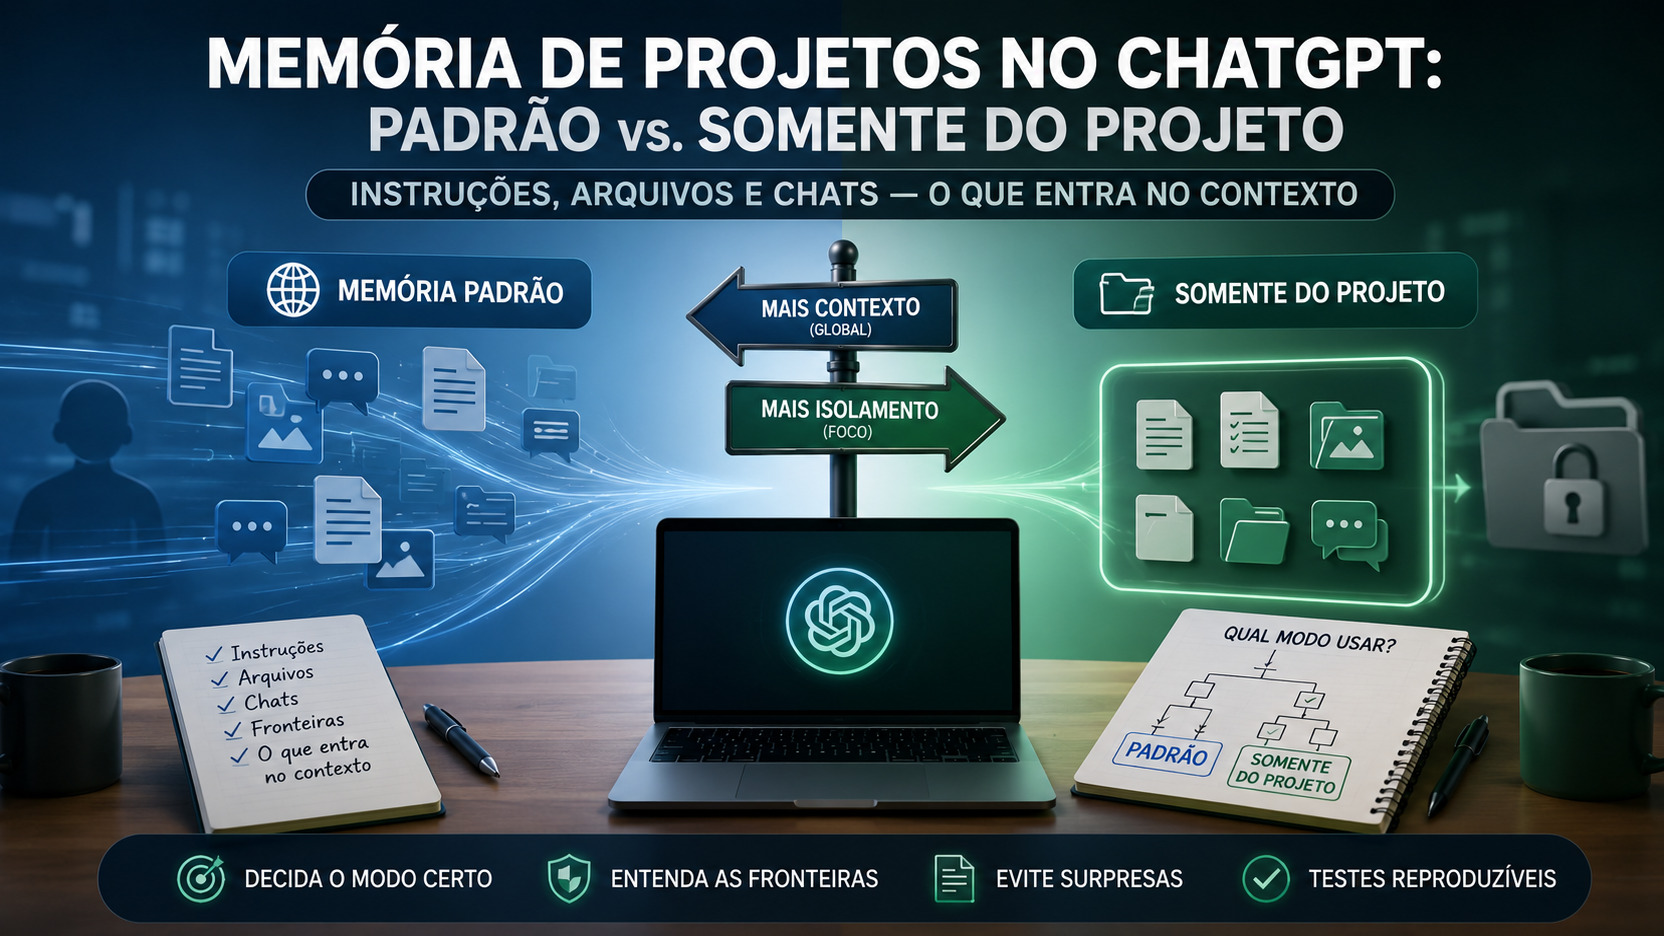
Em trabalhos longos, um projeto ou workspace pode ser mais útil porque reúne instruções, chats e arquivos relacionados. No ChatGPT, a documentação atual de Projetos diz que o recurso possui memória integrada e pode usar conversas e arquivos do próprio projeto como contexto. Ainda assim, isso não elimina a necessidade de manter decisões críticas em um documento ou resumo de estado bem definido.
Quatro sintomas que parecem “esquecimento”, mas pedem correções diferentes
A IA não consegue repetir a regra antiga
Faça um teste de recuperação simples: peça que ela diga, em uma frase, qual é a regra específica e como essa regra afeta a tarefa atual. Se a resposta vier errada, vaga ou inexistente, há boa chance de a informação não estar acessível de forma útil naquele momento. A correção mais eficiente costuma ser fornecer novamente a regra dentro de um resumo curto de estado.
Esse teste não revela a arquitetura interna do produto e não prova se houve corte, resumo ou outra forma de gerenciamento. Ele apenas verifica o que importa operacionalmente: a informação está disponível para a resposta atual ou não?
A IA repete a regra corretamente, mas não a cumpre
Aqui o diagnóstico muda. Se o modelo consegue reproduzir a instrução com precisão e ainda assim a viola, o problema não parece ser simples ausência. Pode haver context rot, baixa saliência, conflito entre instruções ou dificuldade real da tarefa.
O próximo teste é pedir que ele identifique as instruções relevantes e explique se alguma entra em conflito com outra. Se aparecerem duas versões incompatíveis, resolva a prioridade explicitamente. Não acrescente uma terceira formulação por cima das duas anteriores. Transforme a decisão em uma única regra vigente.
A resposta ficou genérica depois de dezenas de mensagens
Quando a conversa acumula desvios, exemplos descartados, tentativas que falharam e grandes blocos de saída, o contexto pode continuar tecnicamente disponível e ainda assim ficar pouco eficiente. Um bom teste é criar um resumo autoritativo com objetivo, restrições, decisões vigentes e dados necessários e executar a mesma tarefa em um chat limpo.
Se a versão compacta melhora claramente o resultado, o indício favorece um problema de contexto longo ou ruidoso. A comparação não precisa preservar todas as mensagens antigas; precisa preservar
apenas o estado necessário para a tarefa. Esse é justamente o valor do teste.
A IA mistura duas decisões tomadas em momentos diferentes
Esse é um caso clássico de contexto contraditório. Imagine que, no início, você pediu textos formais e, mais tarde, mudou para um tom conversacional. Se as duas instruções continuam presentes sem uma revogação clara, o modelo precisa inferir qual prevalece. Quanto mais longa a conversa, mais fácil é interpretar a inconsistência como “esquecimento”.
A correção é declarar o estado atual e retirar ambiguidade: a regra antiga foi substituída, a nova é a única vigente e qualquer exemplo incompatível deve ser tratado como histórico, não como instrução.
Mini-testes para descobrir se a informação ainda está sendo usada
O teste de recuperação pergunta qual é a regra e como ela se aplica agora. O teste de conflito pede que a IA compare as instruções relevantes e aponte versões incompatíveis. O teste de compressão transfere apenas o estado atual para um chat limpo e repete a tarefa. O teste de posição repete uma única regra crítica perto do pedido atual e verifica se a execução melhora.
Nenhum desses testes, isoladamente, diagnostica com certeza o que o aplicativo fez nos bastidores. Eles funcionam como testes funcionais. Se a IA não consegue recuperar a informação, você trata como contexto indisponível. Se consegue recuperar, mas não aplica, investiga conflito, saliência ou degradação. Se um contexto curto e equivalente resolve, o volume ou o ruído da conversa anterior provavelmente fazia parte do problema.
Há ainda um teste de memória: abra uma conversa separada e verifique se uma preferência estável reaparece sem você copiá-la. Se reaparecer, há algum mecanismo de persistência atuando; isso não significa que o chat anterior inteiro tenha sido carregado. Memória e contexto atual podem colaborar, mas continuam sendo coisas diferentes.
Quando resumir, limpar o contexto, abrir outro chat ou usar um projeto
Resumir faz sentido quando o trabalho continua sendo o mesmo, mas o histórico cresceu demais. O resumo deve ser um estado atual, não uma ata completa. Registre objetivo, decisões vigentes, restrições, dados essenciais e próximos passos. Se uma decisão antiga foi revogada, não a preserve como se ainda estivesse ativa.
Limpar ou podar contexto é melhor quando a conversa contém grandes blocos que já cumpriram sua função, como logs, resultados intermediários, versões descartadas ou saídas de ferramentas. Em sistemas que permitem gerenciamento explícito do contexto, remover esse material reduz competição por atenção e deixa mais espaço para o que precisa orientar a próxima resposta.
Abrir um novo chat é a opção mais segura quando a conversa acumulou muitas contradições, mudou de objetivo ou começou a produzir erros difíceis de separar do próprio histórico. O novo chat deve começar com um pacote de estado curto. Recomeçar sem esse pacote troca excesso de contexto por falta de contexto.
Usar um projeto é melhor quando você precisa de continuidade entre várias conversas sobre o mesmo trabalho, com arquivos e instruções compartilhados. A vantagem não é criar “memória infinita”, e sim manter fontes relacionadas no mesmo espaço e reduzir a dependência de um único chat interminável.
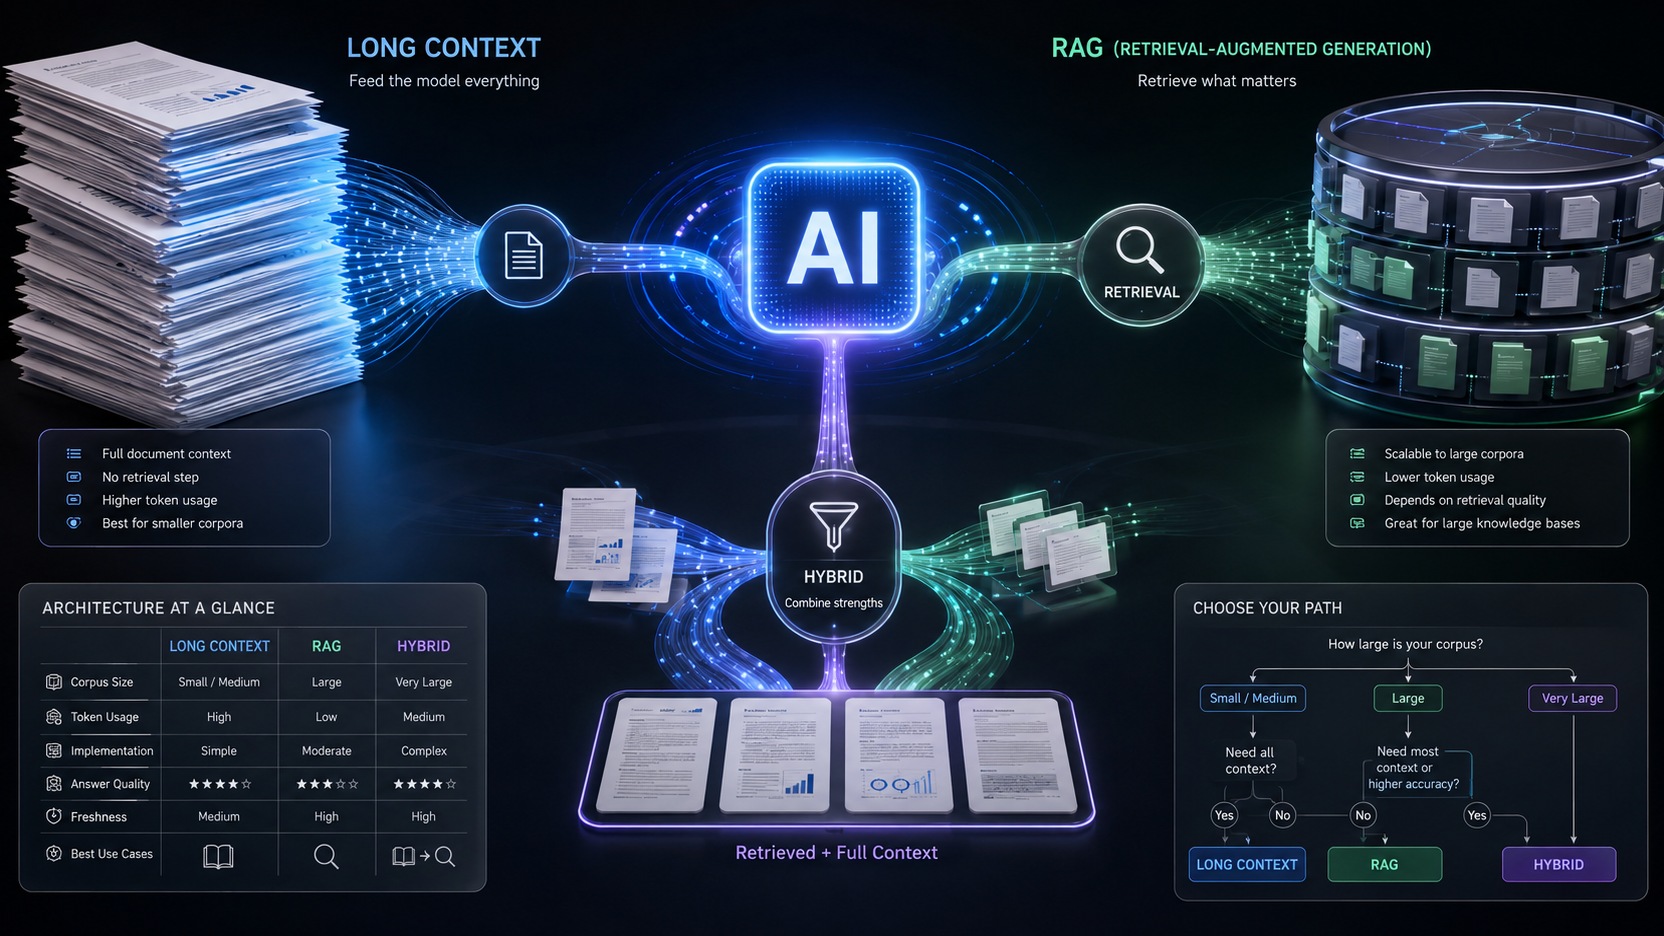
Recuperação externa, como busca em documentos, banco de conhecimento ou RAG, torna-se a escolha mais robusta quando o corpus é grande e a informação precisa ser encontrada sob demanda. Em vez de exigir que o modelo carregue todo o acervo em cada rodada, o sistema recupera trechos relevantes e os coloca no contexto da pergunta atual.
O que muda entre ChatGPT, Claude e Gemini
A distinção conceitual é a mesma, mas os produtos não expõem exatamente os mesmos controles. A Anthropic documenta de forma explícita que mais contexto não é automaticamente melhor e que chats podem adotar gerenciamento rolante. O Google destaca janelas muito grandes em vários modelos Gemini e trata a janela como memória de curto prazo, ao mesmo tempo em que reconhece estratégias como resumir e recuperar conteúdo para administrar contexto. A OpenAI, no ChatGPT, documenta memória e Projetos como mecanismos de persistência que podem trazer informações de outras conversas e fontes para respostas futuras.
Por isso, comparar apenas o número máximo de tokens não responde à pergunta “qual IA esquece menos?”. O resultado depende de como o modelo usa informação longa, como a interface monta o contexto, quais mecanismos de memória ou projeto estão ativos, quão contraditório está o histórico e qual tarefa você pede.
Uma janela maior reduz um tipo de limitação: a quantidade máxima de material que pode ser apresentada ao modelo. Ela não garante recuperação perfeita, prioridade correta nem obediência uniforme a todas as instruções. Capacidade de entrada e qualidade de uso do contexto são dimensões diferentes.
Um roteiro de diagnóstico que funciona melhor do que repetir “não esqueça”
Primeiro, escolha uma instrução que tenha sido violada e peça que a IA a reformule. Se ela não conseguir, forneça um resumo curto com a regra e o estado atual. Se conseguir, peça que identifique conflitos com outras instruções. Resolva qualquer contradição em uma formulação única.
Depois, repita a tarefa em um contexto compacto. Se o desempenho melhorar, mantenha a conversa nova ou adote ciclos de resumo em vez de continuar acrescentando mensagens ao histórico antigo. Se não melhorar, verifique se a regra é ambígua ou se a própria tarefa está além do que o modelo consegue executar de modo consistente.
Para projetos de longa duração, separe três camadas. Preferências estáveis podem ficar em memória ou instruções persistentes. O estado operacional atual deve ficar em um documento ou resumo de referência. Materiais extensos devem ficar em arquivos ou em um sistema de recuperação que entregue apenas o que for relevante para cada pergunta.
Esse desenho evita o erro mais comum: usar uma única conversa como memória, banco de dados, histórico, briefing, documentação e área de trabalho ao mesmo tempo.
Contexto longo é um recurso, não um arquivo perfeito
Modelos atuais conseguem receber volumes de contexto que seriam impraticáveis poucos anos atrás, mas receber não é o mesmo que utilizar cada parte com a mesma confiabilidade. Context rot descreve justamente a degradação que pode surgir antes de um limite rígido; memória persistente resolve continuidade entre interações, mas não substitui uma fonte de verdade; e instruções contraditórias podem simular esquecimento mesmo quando ambas continuam presentes.
Quando a IA “esquecer”, a pergunta mais útil não é “quantos tokens ainda cabem?”. Pergunte se a regra está acessível, se ela ainda é a única regra vigente, se um contexto curto melhora a execução e se aquela informação deveria estar em memória, em um projeto ou em uma fonte externa. A partir daí, resumir, limpar, recomeçar ou recuperar documentos deixa de ser tentativa e erro e vira uma escolha de arquitetura de contexto.