Si una conversación se prolongó y la IA comenzó a ignorar una regla que obedecía antes, "olvidó" describe el síntoma, no la causa. Cuatro problemas diferentes pueden producir la misma sensación: la información ya no forma parte del contexto realmente utilizado en esa respuesta; la información permanece en contexto, pero se ha vuelto más difícil de recuperar o aplicar; hay instrucciones antiguas y nuevas que compiten entre sí; o esperaba que un recurso de memoria persistente almacenara algo para lo cual no fue diseñado para preservar con precisión operativa.
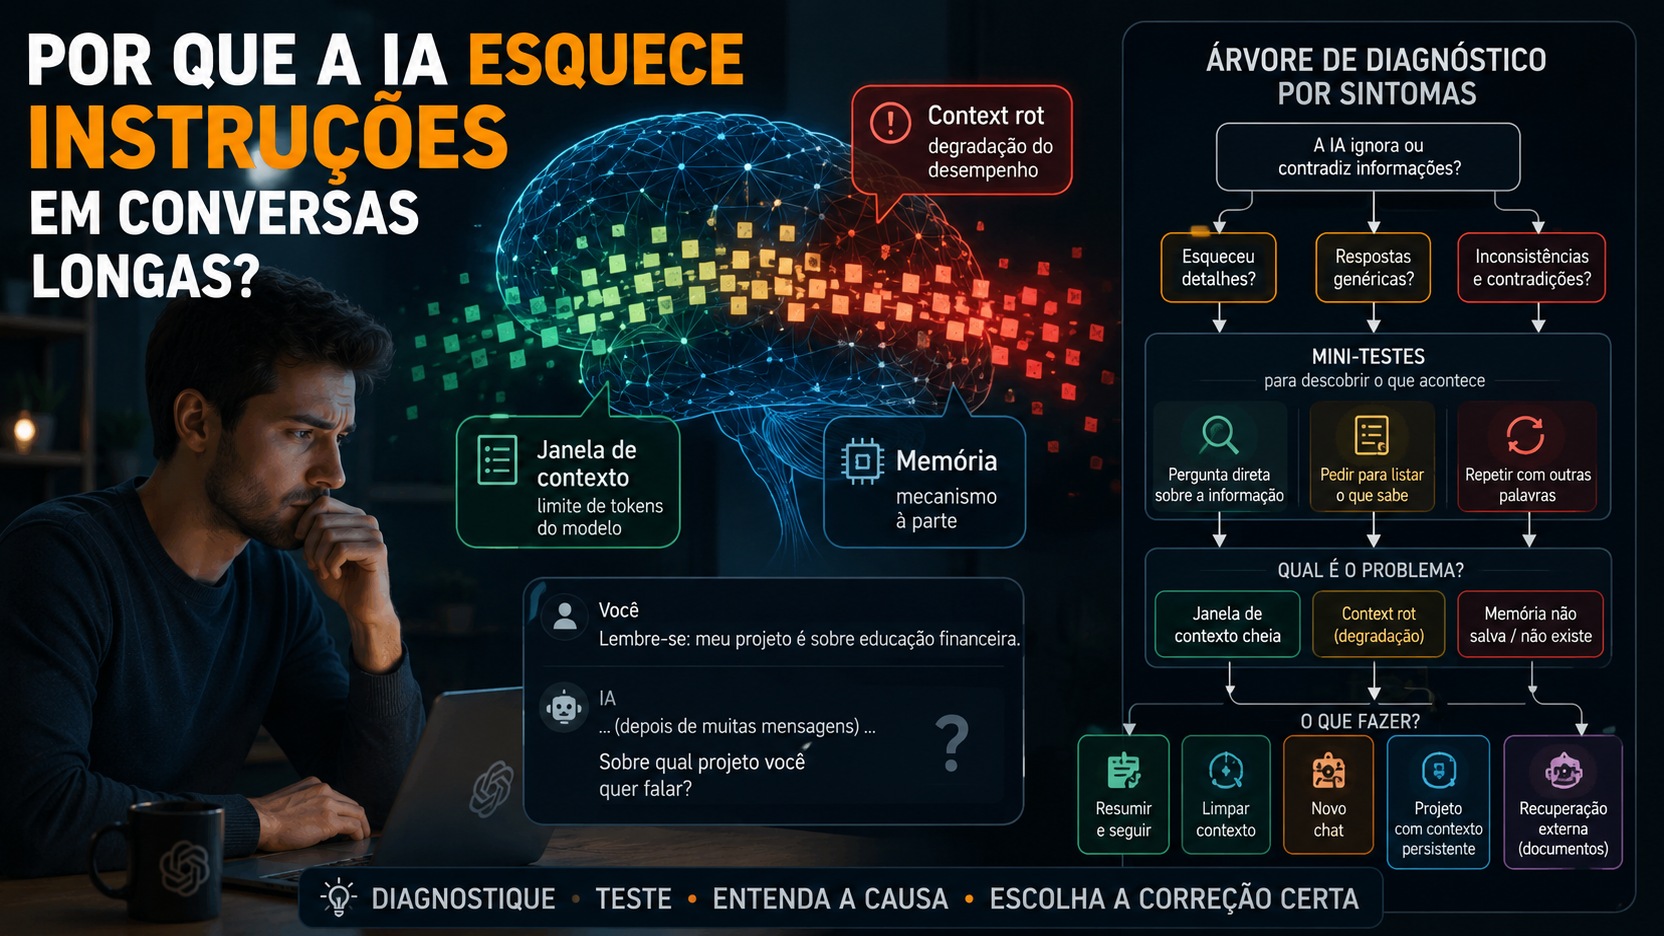
La diferencia importa porque la corrección cambia. Si el problema es demasiado contexto, agregar más recordatorios puede empeorar el ruido. Si se trata de una instrucción contradictoria, abrir un nuevo chat sin resolver la contradicción simplemente transmite el error. Si se trata de memoria, insistir en una conversación interminable no convierte automáticamente el historial en un almacenamiento confiable. El diagnóstico más útil comienza separando la ventana de contexto, la descomposición del contexto y la memoria.
La ventana de contexto no es lo mismo que la memoria
La ventana de contexto es el conjunto de información que el modelo puede utilizar al generar una respuesta en ese momento. La documentación actual de Anthropic y Google describe este espacio como una especie de memoria de trabajo o memoria a corto plazo. Incluye las instrucciones y mensajes que llegan al modelo, así como otros elementos que el producto o API puede ingresar, como archivos, resultados de herramientas e instrucciones del sistema.
Esto no es lo mismo que el conocimiento adquirido en la capacitación y tampoco es, en sí mismo, un archivo permanente de la conversación. Una interfaz puede gestionar conversaciones largas con sus propias estrategias, como mantener un historial continuo, comprimir extractos o resumir partes antiguas. Por tanto, el tamaño nominal de la ventana de un modelo no nos permite concluir por sí solos que cada frase de un chat muy largo seguirá llegando intacta y con el mismo peso en todas las respuestas.
Cuando la información realmente ha abandonado el contexto activo, el modelo no puede recuperarla simplemente “esforzándose más”. Es como pedirle que consulte una página que aún no está en el material entregado para esa ronda. En este caso, la solución es volver a poner el estado necesario en una forma breve y autorizada en lugar de repetir toda la conversación.
El deterioro del contexto puede ocurrir antes de que se llene la ventana
La descomposición del contexto es un problema diferente. La propia documentación de Anthropic utiliza el término para la caída en la precisión y la recuperación a medida que aumenta el número de tokens en el contexto. La conclusión es la siguiente: el modelo aún puede aceptar el contexto y aun así usarlo peor.
Esta diferencia ya aparece en la investigación experimental. El estudio Lost in the Middle, publicado en 2024 en Transactions of the Association for Computational Linguistics, demostró que los modelos de contexto largo pueden funcionar de manera muy diferente dependiendo de la posición de la información relevante, con un empeoramiento frecuente cuando se encuentra en medio de entradas largas. Trabajos posteriores también encontraron degradación al aumentar la longitud del contexto, incluso cuando la tarea permanece dentro del límite establecido por el modelo.
Esto no significa que exista un número universal de tokens a partir del cual toda la IA se “pudre”. Los modelos, tareas e interfaces se comportan de manera diferente. El término es útil para nombrar un patrón de degradación, no para crear un límite matemático igual para ChatGPT, Claude y Gemini.
En la práctica, la descomposición del contexto a menudo parece más sutil que un corte brusco. La IA todavía reconoce el diseño, pero pasa por alto una restricción. Aún encuentras un hecho, pero mezclas versiones. Todavía conoce la regla, pero produce una respuesta genérica que no la aplica. Por eso simplemente preguntar "¿te acuerdas?"
no es suficiente para diagnosticar el problema.
La memoria persistente soluciona otro tipo de necesidad
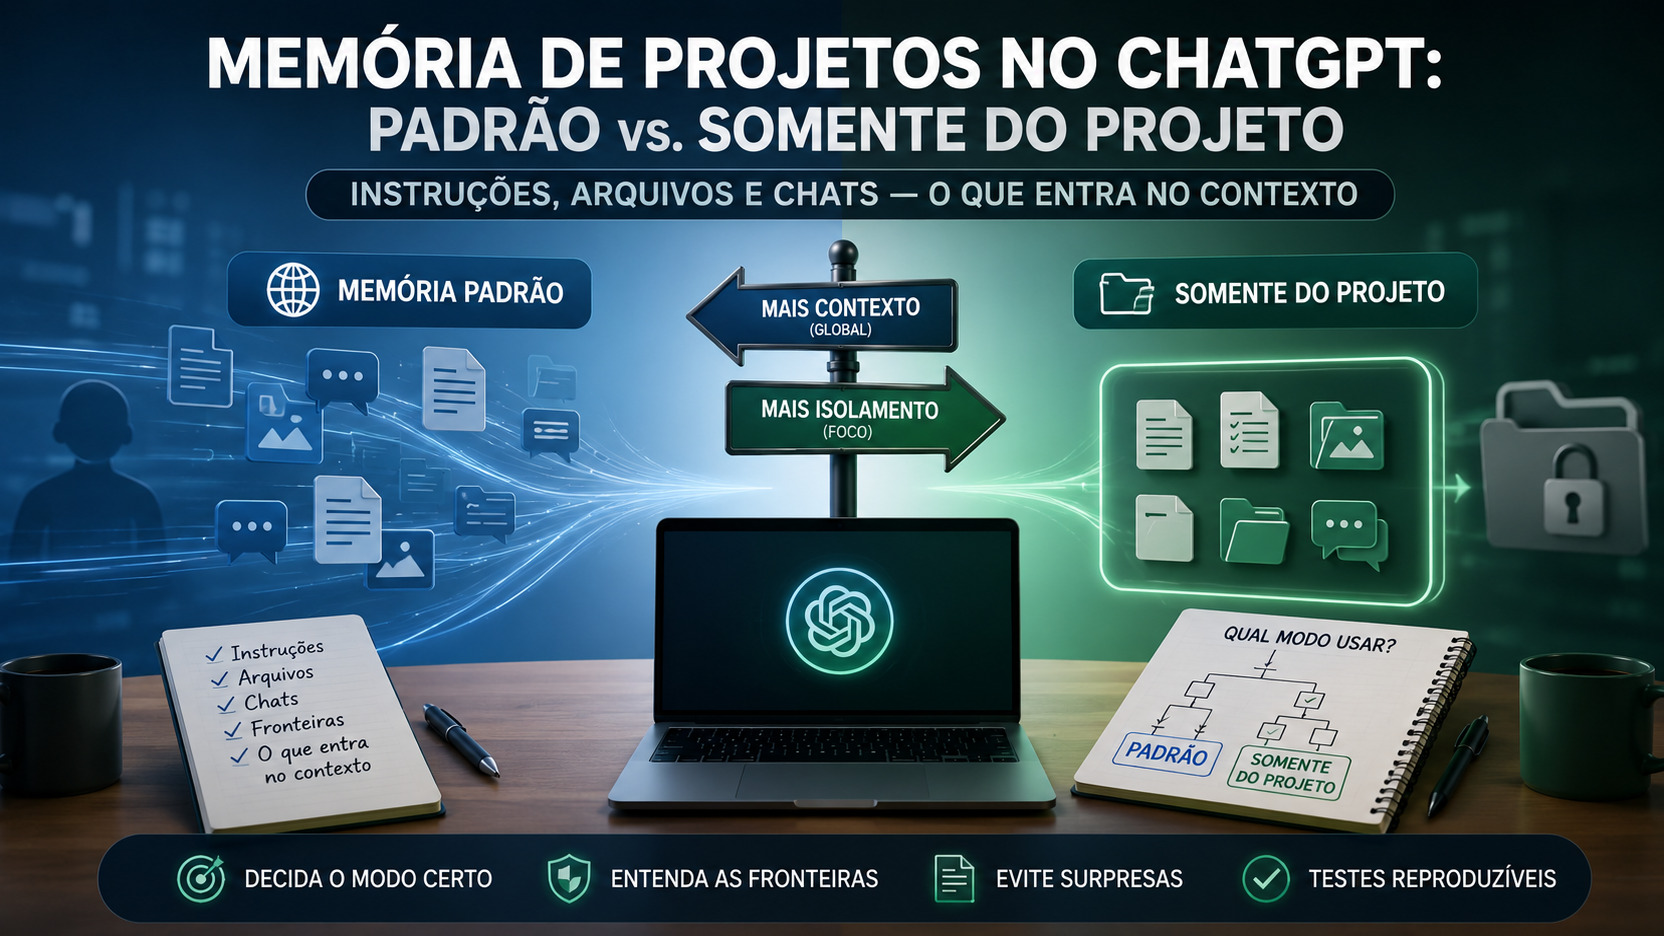
La memoria es un mecanismo independiente para transportar información útil de una interacción a otra. En ChatGPT, por ejemplo, la documentación de OpenAI trata la memoria, el historial de chat, los archivos y las instrucciones como fuentes distintas que pueden contribuir a la personalización. La propia página de memoria advierte que el resumen que se muestra al usuario no necesariamente contiene todo lo que se puede recordar, y que los detalles pueden actualizarse o sintetizarse con el tiempo.
Esto hace que la memoria sea adecuada para preferencias e información relativamente estables, como el idioma, el formato favorito o el contexto personal recurrente. Es menos apropiado como sustituto de un estado de diseño que debe seguir siendo literal, completo y auditable. “Responda siempre en portugués” es un buen candidato para la perseverancia. "Utilice exactamente la versión 17 de este informe, con estas seis excepciones y estos cuatro números" pide una fuente de verdad más explícita.
En trabajos largos, un proyecto o espacio de trabajo puede resultar más útil porque reúne instrucciones, chats y archivos relacionados. En ChatGPT, la documentación actual del proyecto dice que el recurso tiene memoria integrada y puede usar conversaciones y archivos del propio proyecto como contexto. Aún así, esto no elimina la necesidad de mantener las decisiones críticas en un documento o resumen de estado bien definido.
Cuatro síntomas que parecen “olvido” pero requieren diferentes correcciones
La IA no puede repetir la antigua regla
Haga una prueba de memoria simple: pídale que diga, en una oración, cuál es la regla específica y cómo esa regla afecta la tarea actual. Si la respuesta es incorrecta, vaga o inexistente, es muy probable que no se pueda acceder a la información de manera útil en ese momento. La solución más eficaz suele ser reabastecer la regla en un breve resumen del estado.
Esta prueba no revela la arquitectura interna del producto y no prueba si hubo recorte, resumen u otra forma de gestión. Sólo comprueba lo que importa operativamente: ¿la información está disponible para la respuesta actual o no?
La IA repite la regla correctamente, pero no la cumple
Aquí el diagnóstico cambia. Si el modelo puede reproducir la instrucción con precisión y aun así violarla, el problema no parece ser una simple ausencia. Puede haber deterioro del contexto, poca prominencia, conflicto entre instrucciones o dificultad real de la tarea.
La siguiente prueba es pedirle que identifique las instrucciones relevantes y explique si hay algún conflicto con otra. Si aparecen dos versiones incompatibles, resuelva la prioridad explícitamente. No añadir una tercera formulación encima de las dos anteriores. Transforma la decisión en una única regla efectiva.
La respuesta fue genérica después de decenas de mensajes
Cuando la conversación acumula desviaciones, ejemplos descartados, intentos fallidos y grandes bloques de resultados, el contexto puede permanecer técnicamente disponible y seguir siendo ineficiente. Una buena prueba es crear un resumen autorizado con objetivos, limitaciones, decisiones actuales y datos necesarios y realizar la misma tarea en un chat limpio.
Si la versión compacta mejora claramente el resultado, la indicación favorece un problema de contexto largo o ruidoso. No es necesario que la comparación conserve todos los mensajes antiguos; necesidad de preservar
solo el estado necesario para la tarea. Éste es precisamente el valor de la prueba.
La IA mezcla dos decisiones tomadas en momentos diferentes
Este es un caso clásico de contexto contradictorio. Imagina que al principio pediste textos formales y luego cambiaste a un tono conversacional. Si ambas instrucciones siguen presentes sin una revocación clara, el modelo debe inferir cuál prevalece. Cuanto más larga sea la conversación, más fácil será interpretar la inconsistencia como "olvido".
La corrección es declarar el estado actual y eliminar la ambigüedad: la antigua regla fue reemplazada, la nueva es la única vigente y cualquier ejemplo incompatible debe ser tratado como historia, no como instrucción.
Mini-tests para saber si la información todavía se utiliza
La prueba de recuperación pregunta cuál es la regla y cómo se aplica ahora. Las pruebas de conflicto piden a la IA que compare instrucciones relevantes y señale versiones incompatibles. Las pruebas de compresión solo transfieren el estado actual a un chat limpio y repiten la tarea. La prueba de posición repite una única regla crítica cerca de la orden actual y ve si la ejecución mejora.
Ninguna de estas pruebas por sí sola puede diagnosticar definitivamente lo que hizo la aplicación entre bastidores. Funcionan como pruebas funcionales. Si la IA no puede recuperar la información, la trata como contexto no disponible. Si puede recuperarse pero no aplicar, investigue el conflicto, la prominencia o la degradación. Si un contexto breve y equivalente funciona, el volumen o el ruido de la conversación anterior probablemente fue parte del problema.
También hay una prueba de memoria: abre una conversación separada y comprueba si reaparece una preferencia estable sin que la copies. Si reaparece, hay algún mecanismo de persistencia en funcionamiento; Esto no significa que se haya cargado todo el chat anterior. La memoria y el contexto actual pueden colaborar, pero siguen siendo cosas diferentes.
Cuándo resumir, aclarar el contexto, abrir otro chat o utilizar un proyecto
Resumir tiene sentido cuando la obra sigue siendo la misma, pero la historia ha crecido demasiado. El resumen debe ser un estado actual, no un minuto completo. Registra objetivos, decisiones actuales, restricciones, datos esenciales y próximos pasos. Si una decisión anterior ha sido revocada, no la conserve como si todavía estuviera activa.
Limpiar o podar el contexto es mejor cuando la conversación contiene bloques grandes que ya han cumplido su propósito, como registros, resultados intermedios, versiones descartadas o resultados de herramientas. En los sistemas que permiten una gestión explícita del contexto, eliminar este material reduce la competencia por la atención y deja más espacio para lo que debe guiar la siguiente respuesta.
Abrir un nuevo chat es la opción más segura cuando la conversación ha acumulado muchas contradicciones, ha cambiado de objetivo o ha empezado a producir errores difíciles de separar del historial mismo. El nuevo chat debe comenzar con un breve paquete de estado. Empezar de nuevo sin este paquete cambia el exceso de contexto por falta de contexto.
Usar un proyecto es mejor cuando necesitas continuidad entre múltiples conversaciones sobre el mismo trabajo, con archivos e instrucciones compartidos. La ventaja no es crear “memoria infinita”, sino mantener fuentes relacionadas en el mismo espacio y reducir la dependencia de un único chat interminable.
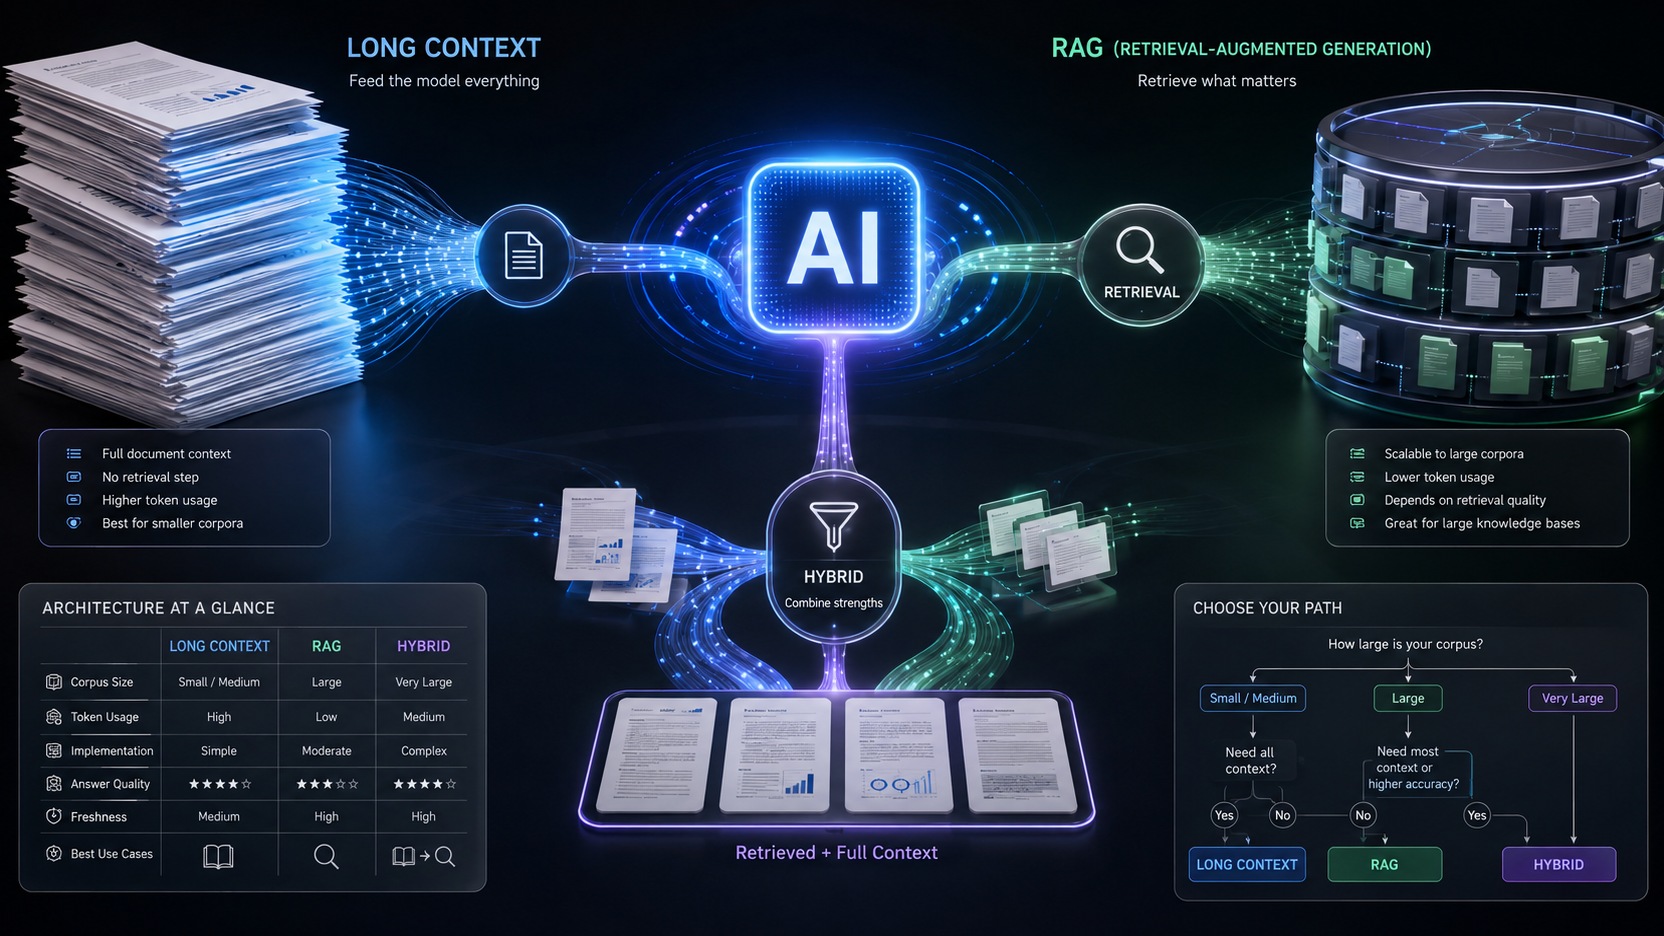
La recuperación externa, como la búsqueda de documentos, el banco de conocimientos o RAG, se convierte en la opción más sólida cuando el corpus es grande y es necesario encontrar información bajo demanda. En lugar de requerir que el modelo cargue toda la colección en cada ronda, el sistema recupera extractos relevantes y los coloca en el contexto de la pregunta actual.
Qué cambia entre ChatGPT, Claude y Gemini
La distinción conceptual es la misma, pero los productos no exponen exactamente los mismos controles. Anthropic documenta explícitamente que más contexto no es automáticamente mejor y que los chats pueden adoptar una gestión continua. Google destaca ventanas muy grandes en varios modelos Gemini y trata la ventana como memoria a corto plazo, al tiempo que reconoce estrategias como resumir y recuperar contenido para gestionar el contexto. OpenAI, en ChatGPT, documenta la memoria y los proyectos como mecanismos de persistencia que pueden incorporar información de otras conversaciones y fuentes a respuestas futuras.
Por lo tanto, comparar solo el número máximo de tokens no responde a la pregunta "¿qué IA olvida menos?". El resultado depende de cómo el modelo utiliza información extensa, cómo la interfaz ensambla el contexto, qué memoria o mecanismos de diseño están activos, qué tan contradictoria es la historia y qué tarea se le pide.
Una ventana más grande reduce un tipo de limitación: la cantidad máxima de material que se puede presentar al modelo. No garantiza una recuperación perfecta, una priorización correcta ni una obediencia uniforme a todas las instrucciones. La capacidad de entrada y la usabilidad del contexto son dimensiones diferentes.
Un script de diagnóstico que funciona mejor que repetir "no olvidar"
Primero, elija una instrucción que haya sido violada y pídale a la IA que la reformule. Si no puede, proporcione un breve resumen de la regla y el estado actual. Si puede, pídales que identifiquen conflictos con otras instrucciones. Resuelve cualquier contradicción en una sola formulación.
Luego repita la tarea en un contexto compacto. Si el rendimiento mejora, mantenga actualizada la conversación o adopte ciclos de resumen en lugar de continuar agregando mensajes al historial anterior. Si no mejora, verifique si la regla es ambigua o si la tarea en sí está más allá de lo que el modelo puede realizar de manera consistente.
Para proyectos a largo plazo, separe tres capas. Las preferencias estables pueden permanecer en la memoria o instrucciones persistentes. El estado operativo actual debe estar en un documento de referencia o resumen. Se debe mantener una gran cantidad de materiales en archivos o en un sistema de recuperación que proporcione solo lo que sea relevante para cada pregunta.
Este diseño evita el error más común: utilizar una única conversación como memoria, base de datos, historial, briefing, documentación y espacio de trabajo al mismo tiempo.
El contexto largo es un recurso, no un archivo perfecto
Los modelos actuales pueden recibir volúmenes de contexto que habrían sido poco prácticos hace apenas unos años, pero recibir no es lo mismo que utilizar cada parte con la misma confiabilidad. La descomposición del contexto describe con precisión la degradación que puede surgir antes de un límite estricto; la memoria persistente resuelve la continuidad entre interacciones, pero no reemplaza una fuente de verdad; y las instrucciones contradictorias pueden simular el olvido incluso cuando ambas todavía están presentes.
Cuando la IA "se olvida", la pregunta más útil no es "¿cuántas fichas quedan?". Pregunte si la regla es accesible, si sigue siendo la única regla vigente, si un contexto corto mejora la ejecución y si esa información debe estar en la memoria, en un proyecto o en una fuente externa. A partir de entonces, resumir, limpiar, empezar de nuevo o recuperar documentos deja de ser prueba y error y se convierte en una elección de arquitectura de contexto.