A escolha entre RAG e contexto longo não deveria começar pela pergunta “quantos tokens cabem no modelo?”. A janela de contexto define quanto material pode ser enviado de uma vez, mas não decide sozinha qual arquitetura é mais adequada. O formato do corpus, a frequência de atualização, o tipo de pergunta, a necessidade de rastrear fontes, a repetição das consultas e o custo por chamada mudam a resposta.
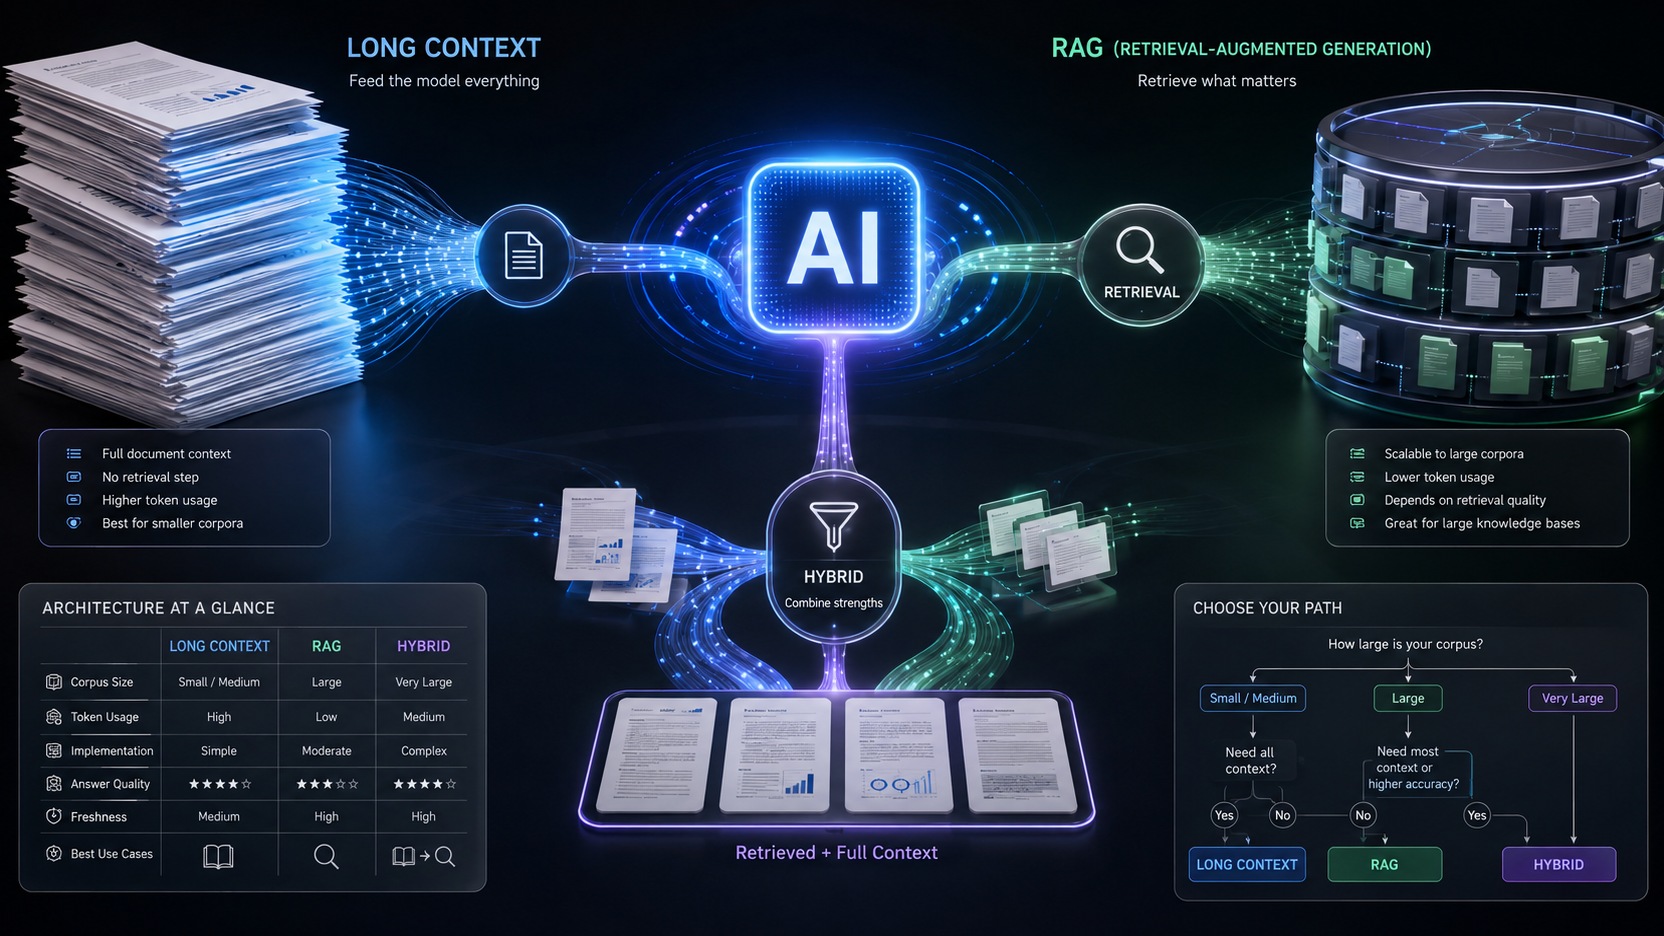
A regra prática é esta: contexto longo tende a ser mais atraente quando o conjunto de documentos é limitado, coerente e precisa ser lido como um todo; RAG tende a ganhar quando a base é extensa, cresce ou muda com frequência e cada pergunta depende de uma pequena fração dela; o híbrido entra quando algumas perguntas exigem visão global e outras exigem recuperação seletiva, ou quando você quer usar busca para reduzir o universo e ainda entregar ao modelo documentos completos para raciocinar.
O ponto importante é tratar isso como uma decisão testável. Em vez de declarar RAG “obsoleto” porque um modelo aceita centenas de milhares ou milhões de tokens, compare as três estratégias com as mesmas perguntas, os mesmos documentos e métricas que representem seu uso real.
Contexto longo não é apenas “RAG sem banco vetorial”
No contexto longo, você coloca diretamente no prompt todos os documentos relevantes, ou uma parte suficientemente grande deles, e pede ao modelo que trabalhe sobre esse material. A documentação atual do Gemini descreve modelos com janelas de 1 milhão de tokens ou mais e apresenta usos como síntese de grandes conjuntos de texto e perguntas e respostas sobre material extenso. Isso torna viável um caminho que, anos atrás, exigiria necessariamente filtragem ou recuperação externa.
A vantagem arquitetural é a simplicidade. Não há etapa de chunking, geração de embeddings, indexação, busca, reranking nem lógica para decidir quais trechos entram na chamada. Relações que atravessam várias páginas ou documentos também permanecem disponíveis ao modelo sem depender de um recuperador ter selecionado todos os pedaços necessários.
Mas “cabe na janela” não significa “é gratuito, rápido e infalível”. O próprio guia de contexto longo do Google recomenda evitar tokens desnecessários, observa que entradas maiores tendem a aumentar o tempo até o primeiro token e ressalta que tarefas com vários elementos relevantes espalhados pelo contexto podem ter comportamento menos consistente do que testes simples de localizar uma única informação.
Por isso, contexto longo é especialmente interessante quando a pergunta precisa de visão global. Resumir um dossiê, comparar argumentos distribuídos em vários capítulos, detectar contradições entre documentos ou interpretar um conjunto que faz sentido como unidade são tarefas em que cortar o material antes da inferência pode eliminar relações importantes.
RAG é uma arquitetura de seleção, não apenas uma solução para janelas pequenas
RAG, de retrieval-augmented generation, acrescenta uma etapa de recuperação antes da geração. Em uma implementação típica, o corpus é dividido, indexado e consultado; os trechos considerados mais relevantes para a pergunta entram no contexto do modelo. A arquitetura reduz a quantidade de material processado em cada chamada e permite trabalhar com bases muito maiores do que aquilo que seria razoável enviar integralmente.
Essa seleção continua útil mesmo quando o modelo possui uma janela enorme. A documentação da Anthropic para aplicações de suporte, por exemplo, alerta que colocar grandes volumes de contexto estático e dinâmico em toda solicitação pode elevar custo, latência e risco de atingir limites, e recomenda RAG quando a recuperação seletiva melhora eficiência e responsividade.
O preço dessa eficiência é a dependência da recuperação. Se o trecho certo não for buscado, o gerador não terá como usá-lo. Se um fato depende de dois trechos separados e apenas um é recuperado, a resposta pode parecer plausível e ainda assim ficar incompleta. Se o chunking quebra uma definição no ponto errado, se o índice está desatualizado ou se a busca semântica não captura um identificador exato, o problema ocorre antes de o modelo começar a responder.
A própria Anthropic publicou uma abordagem de “Contextual Retrieval” para reduzir essas falhas, combinando contexto adicional nos chunks, embeddings, busca lexical e reranking. O detalhe é revelador: RAG não é um único algoritmo. É uma cadeia de decisões de recuperação que precisa ser projetada e avaliada.
O caminho híbrido evita um falso binário
Há pelo menos duas formas comuns de combinar as estratégias. A primeira é recuperar um conjunto menor de documentos e, em vez de mandar apenas pequenos chunks, enviar ao modelo documentos completos ou trechos amplos para preservar relações locais. A segunda é criar um roteador: perguntas pontuais passam por RAG, enquanto perguntas globais recebem um contexto muito maior.
Um estudo de 2024 de Li e colaboradores comparou RAG e modelos de contexto longo em vários conjuntos de dados. Nos benchmarks usados pelos autores, o contexto longo teve melhor desempenho médio quando havia recursos suficientes, enquanto RAG manteve vantagem de custo. O trabalho propôs um método de roteamento entre as duas opções para reduzir custo sem perder muito do desempenho do contexto longo.
Outro preprint, publicado em 2025 por Li e colaboradores, encontrou um quadro ainda menos binário: contexto longo foi geralmente melhor em tarefas de perguntas e respostas avaliadas pelos autores, mas RAG mostrou vantagens em certos cenários de diálogo e perguntas gerais; estratégias de recuperação baseadas em resumo também se aproximaram do contexto longo em alguns testes. Esses resultados não produzem uma regra universal. Eles reforçam que o tipo de tarefa e o desenho da recuperação importam tanto quanto o tamanho da janela.
Matriz de decisão: tamanho e coerência do corpus
Quando você tem um documento único, um conjunto pequeno de documentos fortemente relacionados ou um pacote que precisa ser interpretado como unidade, comece testando contexto longo. O custo de construir e manter uma camada de recuperação pode não se pagar, e a seleção prévia pode retirar justamente a informação que conecta partes distantes do material.
Quando o corpus já é grande demais para ser enviado com conforto, cresce continuamente ou contém milhares de itens independentes, RAG passa a ser mais natural. A pergunta do usuário normalmente precisa de alguns documentos, não de todo o acervo.
No meio desses extremos, o híbrido costuma ser a opção mais flexível. A recuperação reduz o universo de busca e o contexto longo trabalha sobre um conjunto final mais rico. Em vez de recuperar cinco parágrafos isolados, por exemplo, o sistema pode recuperar os três documentos mais relevantes e entregar versões completas ou seções extensas deles ao modelo.
Matriz de decisão: corpus estático ou frequentemente atualizado
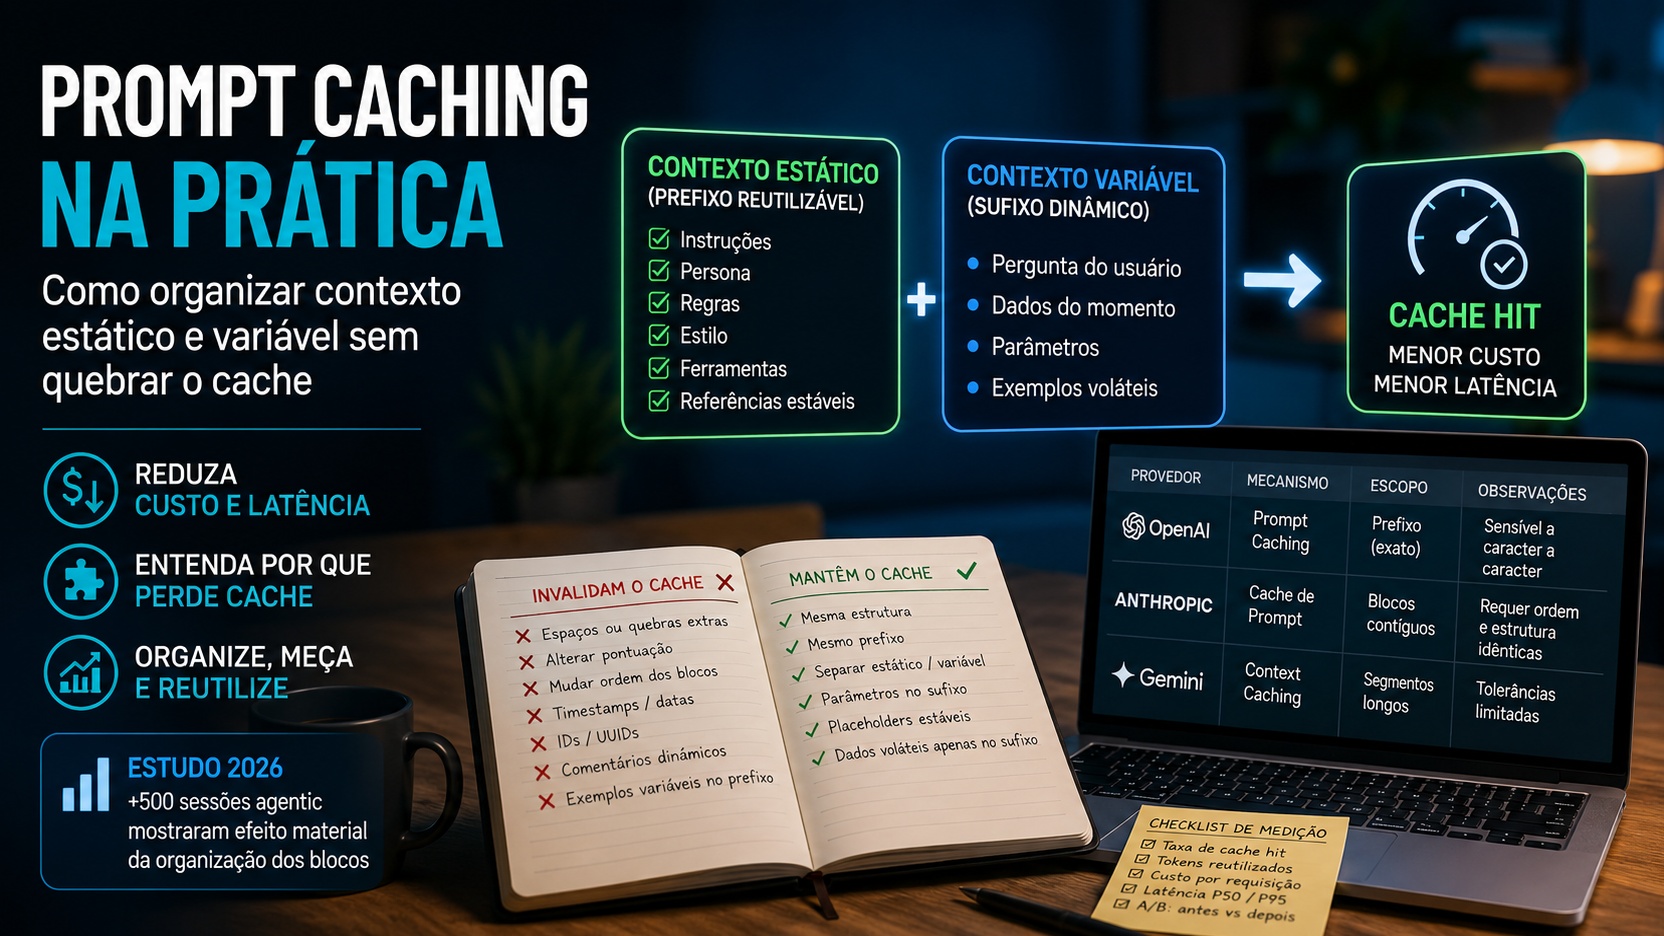
Um corpus estático favorece contexto longo mais do que parece, especialmente quando as mesmas informações são consultadas repetidamente. Mecanismos de cache alteram a economia dessa escolha. O Gemini oferece context caching para reutilizar tokens de entrada, e a Anthropic também documenta prompt caching para reaproveitar prefixos estáveis e reduzir custo e latência em tarefas repetitivas.
Se os documentos mudam pouco e as perguntas se repetem, vale testar contexto longo com cache antes de assumir que RAG será mais barato. O detalhe crítico é medir o padrão real de reutilização: um cache só ajuda quando o material permanece suficientemente estável e as chamadas conseguem reutilizar a parte comum.
Em uma base que muda o tempo todo, a lógica se inverte. Produtos, políticas, tickets, notícias internas, catálogos e registros operacionais podem exigir atualização contínua. Atualizar um índice de recuperação ou consultar uma fonte viva costuma ser mais eficiente do que reconstruir um contexto gigante a cada alteração. Para dados realmente em tempo real, ferramentas de consulta a sistemas de origem podem ser mais adequadas do que embeddings estáticos.
Matriz de decisão: pergunta global ou busca pontual
Perguntas globais puxam a decisão para contexto longo. “Quais são as principais divergências entre estes relatórios?”, “resuma a evolução do argumento ao longo do documento” e “quais premissas aparecem repetidamente em todo o conjunto?” exigem uma visão ampla. Um RAG muito agressivo pode devolver apenas trechos que já parecem responder à consulta e esconder o restante do padrão.
Perguntas pontuais puxam para RAG. “Qual é a política de reembolso para o plano X?”, “em qual documento aparece o código Y?” ou “qual é o prazo associado a esta regra?” tendem a depender de uma pequena parte do acervo. Enviar tudo pode adicionar custo e latência sem melhorar a resposta.
O teste mais útil é separar suas perguntas reais nesses dois grupos e observar a proporção. Se quase tudo for busca pontual, RAG provavelmente será o caminho principal. Se a maior parte exigir leitura transversal, contexto longo merece mais peso. Se os dois tipos forem frequentes, um roteador híbrido pode evitar que todas as consultas paguem pelo pior caso.
Matriz de decisão: citações e rastreabilidade
Necessidade de fonte não significa automaticamente “use RAG”. APIs atuais conseguem fornecer citações também quando os documentos são enviados diretamente. A documentação da Anthropic, por exemplo, permite citações em documentos fornecidos ao modelo e também em resultados de busca usados por aplicações RAG.
A diferença está na arquitetura de proveniência. Em RAG, cada resultado recuperado pode carregar identificador, título e origem antes mesmo da geração, o que facilita auditar o que entrou no contexto. Em contexto longo, você precisa preservar a identidade e a segmentação dos documentos para que a resposta consiga apontar corretamente a fonte.
Se citação é requisito de produto, teste duas coisas separadamente: se a resposta está correta e se a fonte indicada realmente sustenta a afirmação. Uma arquitetura pode acertar o conteúdo e errar a atribuição, ou recuperar a fonte correta e ainda formular uma conclusão excessiva.
Matriz de decisão: custo, latência e repetição das consultas
RAG tende a reduzir tokens de entrada por chamada porque envia apenas uma fração do corpus. Essa vantagem cresce quando a base é enorme e cada pergunta usa poucos trechos. Em
contrapartida, você paga a infraestrutura de ingestão, embeddings, armazenamento, busca, reranking e manutenção.
Contexto longo elimina parte dessa infraestrutura, mas cada chamada pode carregar muito mais entrada. Se o mesmo corpus é consultado repetidamente, caching pode reduzir bastante essa diferença. Se cada usuário traz um corpus diferente e faz uma única pergunta, talvez não haja tempo para amortizar o cache.
Latência também precisa ser medida de ponta a ponta. RAG adiciona uma etapa de busca, mas pode diminuir o tamanho do prompt. Contexto longo remove a busca, mas prompts maiores normalmente elevam o tempo de processamento. A arquitetura mais rápida não é óbvia sem medir a cadeia inteira no seu ambiente.
Matriz de decisão: manutenção da recuperação
RAG transfere parte da complexidade do modelo para o sistema de informação. Você precisa decidir como quebrar documentos, quais metadados guardar, qual modelo de embedding usar, se haverá busca lexical junto da semântica, quantos resultados recuperar, se existe reranking e como avaliar recall.
Essa manutenção é justificável quando a base é grande, viva e reutilizada por muitas consultas. Em um conjunto pequeno e estável, ela pode ser complexidade sem retorno.
Contexto longo reduz essa camada, mas não elimina engenharia. Ainda é preciso controlar ordem dos documentos, instruções, formatos, cache, limites, custos e avaliações de precisão ao longo da janela. O erro comum é comparar um RAG de produção, cheio de componentes visíveis, com um prompt longo tratado como se não tivesse operação nem falhas.
Como testar as três arquiteturas com o seu próprio corpus
Monte um conjunto de perguntas representativas antes de escolher. Inclua perguntas pontuais com uma resposta localizada, perguntas que exigem combinar duas ou mais fontes, perguntas globais sobre o conjunto e casos em que a resposta correta é dizer que a informação não está nos documentos. Se o corpus muda, inclua também perguntas sobre conteúdo recém-atualizado.
Rode o mesmo conjunto em três variantes. Na primeira, envie o máximo de contexto relevante diretamente. Na segunda, use RAG com sua configuração de recuperação. Na terceira, use uma versão híbrida, como recuperar documentos candidatos e então fornecer ao modelo um contexto mais amplo desses candidatos, ou rotear a consulta entre RAG e contexto longo.
Avalie separadamente qualidade da resposta, cobertura das evidências, precisão das citações, taxa de recuperação da fonte correta, latência, tokens processados e custo. Registre também falhas operacionais: consulta que não encontrou o documento certo, cache que não foi reutilizado, documento novo que não entrou no índice ou prompt que excedeu um limite.
Faça o teste em volume suficiente para representar a distribuição de perguntas. Um benchmark composto apenas de buscas pontuais favorecerá RAG; um benchmark composto apenas de sínteses globais favorecerá contexto longo. A matriz só é útil se refletir o tráfego que a aplicação realmente receberá.
Sinais de que você escolheu contexto longo cedo demais
O primeiro sinal é pagar repetidamente por milhares de tokens que quase nunca influenciam a resposta. O segundo é a latência crescer à medida que o corpus aumenta, mesmo quando as perguntas continuam locais. O terceiro é perceber que a maior parte das consultas sempre se
concentra em uma pequena região da base.
Outro sinal aparece quando a atualização vira problema operacional. Se um documento muda e você precisa remontar ou reenviar um grande pacote para quase todas as consultas, uma camada de recuperação pode dar granularidade melhor à atualização.
Sinais de que você escolheu RAG cedo demais
Se os usuários fazem perguntas transversais e a resposta depende de relações que atravessam muitos documentos, um recuperador muito seletivo pode cortar contexto importante. Se a equipe passa mais tempo ajustando chunking, top-k e reranking do que resolvendo o problema do produto, talvez o corpus ainda seja pequeno o suficiente para uma abordagem direta.
Também é um alerta quando o erro dominante não está na geração, mas em “a fonte certa não apareceu”. Nesse caso, aumentar o modelo não resolve necessariamente; é preciso melhorar a recuperação ou ampliar o contexto entregue depois dela.
Quando o híbrido deixa de ser sofisticação e vira a opção mais simples
O híbrido vale a pena quando existe uma fronteira clara entre consultas baratas e locais e consultas raras, mas globais. Um roteador pode manter a maioria das perguntas em RAG e escalar para contexto longo quando a consulta exige síntese ampla.
Também faz sentido quando a recuperação consegue encontrar quais documentos importam, mas chunks pequenos perdem relações internas. Nesse desenho, RAG seleciona documentos e o contexto longo preserva a estrutura dentro do conjunto recuperado.
A desvantagem é operacional: você passa a ter duas rotas para observar, avaliar e depurar. Por isso, o híbrido não deve ser adotado apenas porque parece tecnicamente completo. Ele deve resolver uma diferença real entre tipos de consulta.
A janela de contexto é um limite técnico, não uma estratégia de produto
Janelas de 1 milhão de tokens ou mais mudaram o ponto de partida da arquitetura. Elas tornaram possível enviar volumes que antes exigiam obrigatoriamente uma camada de recuperação. Mas não eliminaram as razões econômicas, operacionais e informacionais para selecionar contexto.
RAG também não deve ser mantido por hábito. Se todo o corpus é pequeno, estável e precisa ser lido em conjunto, uma pilha de embeddings, banco vetorial e reranker pode apenas criar mais lugares para a informação se perder.
A decisão mais defensável é medir três coisas: quanto do corpus cada pergunta realmente precisa, quanto esse corpus muda e quantas vezes o mesmo material será consultado. Depois, teste contexto longo, RAG e uma alternativa híbrida com perguntas reais. A arquitetura certa é a que entrega qualidade e rastreabilidade suficientes dentro do custo, da latência e da manutenção que o produto consegue sustentar.