Prompt caching funciona melhor quando você trata o começo do prompt como uma interface estável, e não como um documento que pode ser remontado a cada chamada. A ideia central é simples: se várias requisições começam com um prefixo reutilizável, o provedor pode reaproveitar trabalho já feito no processamento desse trecho. Se algo muda cedo demais, o trecho comum encolhe e parte do benefício desaparece.
Isso explica um comportamento que costuma parecer contraditório. Dois prompts podem ser praticamente iguais para uma pessoa e, ainda assim, não aproveitar o mesmo cache. O mecanismo não pergunta se os textos têm o mesmo significado. Ele trabalha com a estrutura efetivamente enviada ao modelo, respeitando regras de prefixo, limites mínimos, pontos de cache, tempo de vida e disponibilidade definidos por cada provedor.
O que o prompt caching realmente reutiliza
Antes de gerar a resposta, o modelo precisa processar o contexto de entrada. Nessa etapa, chamada de prefill, o sistema calcula representações internas usadas pelo mecanismo de atenção. Os serviços de prompt caching transformam parte desse trabalho em um recurso reutilizável entre chamadas que compartilham um prefixo compatível.
Isso é diferente de memória de aplicação. O cache não substitui banco de dados, histórico persistente, RAG, estado de sessão nem memória do agente. Você continua responsável por enviar ou referenciar o conteúdo necessário para a tarefa. O ganho vem de evitar processamento repetido de uma parte que o provedor já viu e consegue reconhecer como reutilizável.
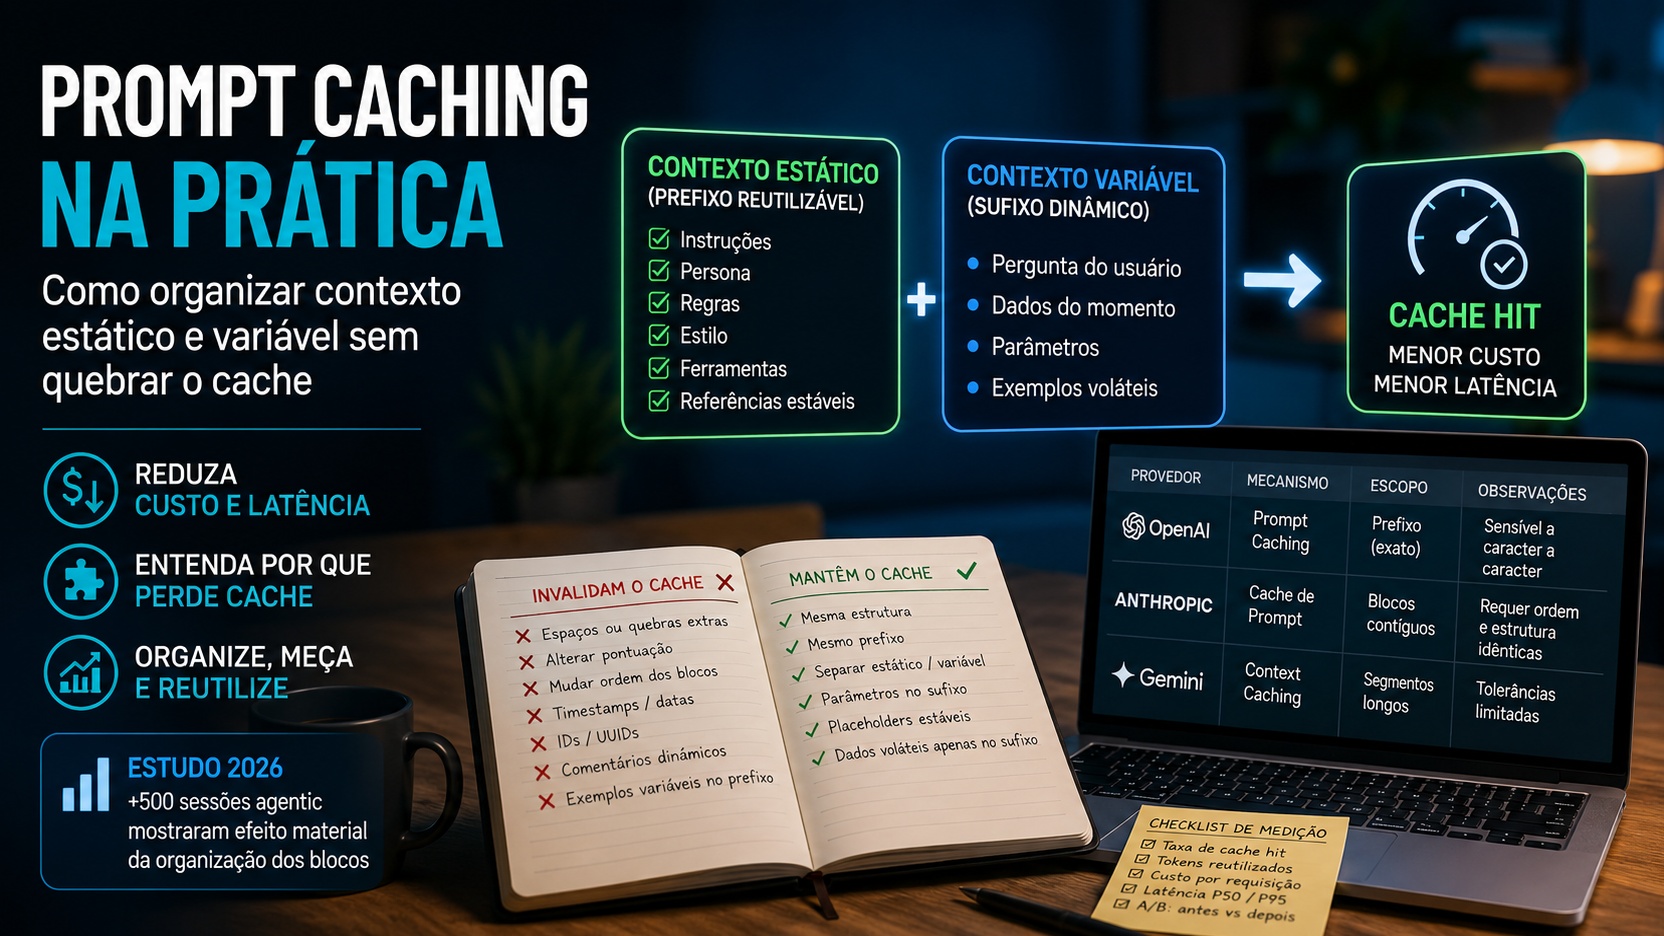
Na prática, pense em um prompt como duas regiões. A primeira contém aquilo que muda pouco: instruções de sistema, políticas, exemplos, definições de ferramentas, schemas e referências estáveis. A segunda concentra o que muda a cada execução: pergunta do usuário, identificadores, timestamp, dados recuperados naquele momento, resultados de tools e parâmetros específicos do
pedido.
Quanto mais cedo a parte variável aparece, menor tende a ser o prefixo que pode ser reaproveitado. Quanto mais estável e longo for o prefixo inicial, maior é a oportunidade de cache, desde que ele ultrapasse o limite mínimo e continue dentro das regras do provedor.
A regra prática: prefixo estático primeiro, dados variáveis depois
A organização mais robusta começa pelo conteúdo que várias requisições realmente compartilham. Instruções permanentes, regras de negócio, formatos de saída, exemplos few-shot estáveis, descrições de tools e material de referência reutilizado pertencem ao início. Conteúdo por usuário ou por execução deve entrar depois da fronteira reutilizável.
Essa fronteira não precisa ser um conceito abstrato. Em APIs que oferecem breakpoints explícitos, ela pode ser marcada diretamente. Em mecanismos automáticos, você ainda pode estruturar o prompt para que o prefixo repetido seja idêntico e suficientemente longo antes de começar a variar.
Também vale separar dados operacionais que não precisam estar dentro do contexto. Um request ID usado apenas para logs, por exemplo, não deveria ocupar uma posição no prefixo estático se a API oferece metadata para esse fim. O mesmo vale para timestamps colocados no prompt por conveniência, mas sem função real na resposta.
Antes e depois: o mesmo agente com estruturas diferentes
Antes: o prompt muda antes de chegar à parte reutilizável
Imagine um agente que monta cada chamada nesta ordem: timestamp atual, request ID, perfil do usuário, lista de tools habilitadas naquele instante, instruções gerais, exemplos e, por fim, a pergunta. O sistema pode até repetir quase todo o texto, mas os primeiros blocos mudam a cada execução. A semelhança visual é alta; o prefixo reutilizável, não.
Se a aplicação ainda serializa os schemas de ferramentas em uma ordem diferente entre chamadas, o problema aumenta. Alterar a ordem de tools, de propriedades ou de blocos dentro da região cacheável pode gerar um prefixo diferente mesmo quando a intenção é a mesma.
Depois: o prefixo é deliberadamente estável
Uma versão mais amigável ao cache começa com instruções de sistema estáveis, políticas, tools em ordem determinística, schemas, exemplos e contexto de referência que realmente se repetem. Depois vem a fronteira cacheável. Só então entram perfil específico do usuário, pergunta, IDs, timestamp e dados recuperados naquela execução.
A mudança parece apenas editorial, mas é arquitetural. Você deixa de perguntar “este prompt é parecido com o anterior?” e passa a perguntar “qual é o maior prefixo idêntico que vale a pena reutilizar?”. Essa segunda pergunta se aproxima muito mais da forma como os mecanismos são documentados.
O que quebra o cache sem parecer uma grande mudança
Pequenas alterações dentro do prefixo
No OpenAI, a documentação atual exige correspondência exata do prefixo para cache hits. Por isso, mudanças de conteúdo, ordem, imagens, tools ou schemas antes da fronteira relevante podem reduzir a reutilização. Espaços, quebras de linha e pontuação também podem importar quando alteram a tokenização do trecho que deveria permanecer estável.
No Claude, o cache é calculado sobre o prefixo formado por tools, system e messages até o breakpoint. A própria documentação alerta que mudanças em blocos anteriores ao ponto de cache
produzem outro hash. Ela também recomenda manter estável a ordenação de chaves em blocos de tool use, porque serialização não determinística pode quebrar o reaproveitamento.
A lição não é congelar toda a aplicação. É tornar determinística a parte que você espera reutilizar.
Tools e schemas que mudam por requisição
Definições de ferramentas costumam ser grandes e, por isso, parecem candidatas naturais a cache. O problema surge quando a aplicação monta uma lista diferente a cada chamada. Acrescentar, remover, reordenar ou reescrever descrições de tools dentro do prefixo pode reduzir hits.
Uma alternativa é manter a definição base estável e controlar disponibilidade por mecanismos próprios da API quando existirem. No OpenAI, por exemplo, a documentação recomenda manter o array de tools inalterado e usar allowed_tools quando suportado, em vez de reconstruir a lista só para restringir o subconjunto disponível.
Histórico reescrito em vez de apenas estendido
Em conversas longas, uma estratégia simples de cache é preservar o histórico anterior e apenas anexar novas mensagens. Quando a aplicação reescreve mensagens antigas, reordena eventos, muda resumos ou compacta trechos anteriores, o prefixo também muda.
Compactação pode continuar sendo uma boa decisão para reduzir contexto total. O ponto é que ela tem um custo de oportunidade: um contexto menor pode ser mais barato, mas a reescrita pode resetar uma região que vinha sendo reutilizada. A decisão correta depende de medir as duas coisas, e não de assumir que menos tokens enviados sempre significa menor custo efetivo.
TTL, limite mínimo e disponibilidade
Nem todo cache miss é consequência de uma mudança no prompt. Os provedores impõem tamanhos mínimos e tempos de vida. Alguns mecanismos também são best-effort: o conteúdo pode continuar idêntico e, ainda assim, não haver uma entrada disponível na infraestrutura que atenda aquela chamada.
Por isso, “o prompt é igual” não basta como diagnóstico. Você precisa saber se o prefixo atingiu o mínimo, se a entrada ainda está viva, se houve uma escrita anterior no ponto certo e se a API reportou tokens realmente lidos do cache.
OpenAI, Claude e Gemini: a mesma ideia, controles diferentes
Os três ecossistemas convergem na importância de conteúdo comum no começo, mas não expõem exatamente a mesma interface. Tratar todos como se tivessem a mesma política costuma gerar configurações frágeis.
OpenAI
A documentação da OpenAI descreve prompt caching automático para requisições elegíveis e enfatiza que cache hits dependem de prefixos exatos. Para GPT-5.6 e famílias posteriores, o mínimo cacheável é de 1.024 tokens e a API também oferece breakpoints explícitos, além do modo implícito.
Nesses modelos mais novos, um breakpoint marca o fim do prefixo reutilizável. O conteúdo depois dele pode variar sem invalidar o prefixo anterior. A documentação também recomenda usar uma prompt_cache_key consistente para melhorar o matching entre chamadas relacionadas. Para medir resultado, cached_tokens mostra leitura do cache; em GPT-5.6 e posteriores, cache_write_tokens ajuda a enxergar quando a aplicação está escrevendo muito e reutilizando pouco.
Modelos anteriores mantêm comportamento automático com limites mínimos que variam por modelo. A implicação prática é não codificar uma única regra de tamanho para toda a frota sem verificar o modelo realmente usado.
Claude
No Claude, o desenvolvedor pode usar cache_control em modo automático ou posicionar breakpoints explícitos em blocos individuais. O prefixo segue a ordem tools, system e messages. A documentação recomenda colocar conteúdo estático no começo e marcar o fim da região que permanece idêntica entre chamadas.
O TTL padrão é de cinco minutos, com opção de uma hora mediante outra estrutura de preço. Os tamanhos mínimos também variam por modelo. Para diagnosticar, a resposta separa tokens de criação e leitura de cache, o que permite distinguir uma chamada que escreveu uma entrada de outra que realmente a reaproveitou.
Um detalhe importante é que o Claude faz lookback de blocos ao procurar entradas previamente escritas, mas isso não transforma conteúdo instável em estável. Se o breakpoint for colocado sobre um bloco que muda a cada requisição e não existir uma entrada anterior adequada, a aplicação continuará criando novos prefixos em vez de reutilizar o que pretendia.
Gemini
No Gemini, o caching implícito está habilitado por padrão nos modelos Gemini 2.5 e posteriores. A documentação recomenda colocar conteúdo grande e comum no início e enviar requisições com prefixos semelhantes em um intervalo curto. Os limites mínimos dependem do modelo: na documentação consultada em agosto de 2026, modelos Gemini 2.5 listam mínimo de 2.048 tokens, enquanto várias famílias 3.x listam 4.096.
O GenerateContent também oferece caching explícito em que a aplicação cria um objeto de cache e o referencia em chamadas posteriores. Nesse modo, o TTL padrão é de uma hora se não for configurado, e o custo considera tanto os tokens em cache quanto o tempo de armazenamento. Já a Interactions API documenta apenas caching implícito.
Para operação, isso significa que “Gemini tem cache” não responde qual cache está sendo usado. É preciso distinguir o mecanismo automático do objeto de cache explícito e medir os tokens reportados como reutilizados no usage metadata.
O que o estudo de 2026 acrescenta aos testes de produção
O preprint Don’t Break the Cache, de Elias Lumer e coautores, avaliou prompt caching em mais de 500 sessões de agentes no DeepResearch Bench, com prompts de sistema de 10 mil tokens, cobrindo OpenAI, Anthropic e Google. O estudo comparou cache de contexto completo, cache apenas do system prompt e uma estratégia que excluía resultados dinâmicos de tools.
O resultado mais útil não é um único percentual, mas a diferença entre estratégias. Os autores encontraram reduções de custo de 41% a 80% nos modelos avaliados e mostraram que a melhora de latência varia mais por provedor e configuração. Em uma das condições, o cache ingênuo de contexto completo chegou a piorar o tempo até o primeiro token, porque conteúdo dinâmico gerava trabalho de escrita sem reaproveitamento proporcional.
A conclusão operacional converge com a arquitetura de prefixo estático: controlar a fronteira do cache foi mais consistente do que tentar armazenar tudo. No conjunto principal do estudo, o cache apenas do system prompt apareceu como estratégia especialmente estável entre custo e latência, embora a melhor configuração absoluta variasse por modelo.
Esse tipo de benchmark não substitui medição própria. O próprio artigo ressalta que TTFT sofre variação de carga, região e infraestrutura. O que ele fornece é uma hipótese de engenharia forte para testar: antes de aumentar TTL ou tentar cachear mais blocos, remova conteúdo volátil da região reutilizável.
Como medir se a reorganização realmente funcionou
Taxa de requisições com cache hit
Conte quantas chamadas retornam algum volume de tokens lidos do cache. Essa métrica ajuda a detectar regressões bruscas, mas sozinha não informa a magnitude do benefício. Um hit de poucos tokens e um hit de dezenas de milhares aparecem igualmente como “requisição com cache”.
Proporção de tokens reutilizados
Acompanhe quantos tokens de entrada foram lidos do cache em relação ao volume de entrada que poderia ser reutilizado. Essa é uma métrica mais próxima do efeito econômico do desenho do prefixo. Se a taxa de requisições com hit estiver alta, mas a proporção de tokens reutilizados for baixa, talvez a fronteira esteja cedo demais.
Relação entre escrita e leitura
Quando a API expõe tokens de criação ou escrita, compare-os com tokens lidos. Uma aplicação que escreve cache repetidamente e quase não lê está pagando o custo de manutenção sem capturar o benefício esperado. Esse padrão costuma apontar para breakpoint mal posicionado, TTL incompatível com a cadência ou conteúdo variável dentro da região escrita.
Custo efetivo por requisição
Use o preço do modelo realmente contratado e separe input normal, cache write, cache read e output quando o provedor fizer essa distinção. Não compare apenas “tokens totais”, porque um token lido do cache pode ter preço diferente de um token processado do zero.
TTFT em p50 e p95
Prompt caching afeta principalmente o processamento de entrada, então o tempo até o primeiro token é uma métrica mais sensível do que a duração total quando a saída é longa. Meça pelo menos mediana e cauda. Uma melhoria de p50 acompanhada por regressão forte de p95 pode ser ruim para uma aplicação interativa.
A/B antes e depois com a mesma carga
Compare a estrutura antiga e a nova usando o mesmo conjunto de solicitações, modelo, região e padrão de concorrência. Faça chamadas de aquecimento quando necessário, separe primeira escrita de leituras subsequentes e não misture mudança de prompt com mudança de modelo no mesmo experimento.
Um checklist de arquitetura que evita a maioria das perdas de cache
Antes de culpar o provedor, verifique se o prefixo realmente permanece estável entre requisições. Instruções, exemplos, tools e schemas devem ter serialização determinística. Dados por usuário, request IDs, timestamps e resultados de ferramentas devem aparecer depois da parte reutilizável sempre que a semântica permitir.
Confirme também o limite mínimo do modelo e o TTL do mecanismo usado. Em seguida, valide a telemetria da própria API: tokens de cache lidos, tokens escritos quando disponíveis, custo e TTFT. Se o sistema só registra tokens totais, fica difícil distinguir um problema de cache de uma simples mudança no tamanho do contexto.
Por fim, trate cache como otimização, não como requisito funcional. Uma cache miss não deve alterar a resposta correta nem quebrar o fluxo do agente. O sistema precisa funcionar sem cache e ficar mais barato ou rápido quando a reutilização acontece.
O objetivo não é cachear tudo; é preservar o que realmente se repete
Prompt caching recompensa arquitetura previsível. O melhor prefixo não é o maior possível, mas o maior trecho que é simultaneamente estável, reutilizado com frequência e compatível com as regras do modelo e da API.
Quando custo ou latência pioram, a primeira investigação deveria ser estrutural: onde aparece o primeiro dado variável? Tools e schemas estão mudando? O histórico antigo é reescrito? O breakpoint está depois do bloco certo? O TTL cobre a cadência real? A telemetria mostra leitura ou apenas novas escritas?
Organizar contexto estático primeiro e contexto variável depois transforma essas perguntas em decisões mensuráveis. Em vez de torcer para o cache funcionar, você passa a projetar o prompt para produzir um prefixo reutilizável e consegue provar, com os próprios dados de uso, se a otimização está valendo a pena.