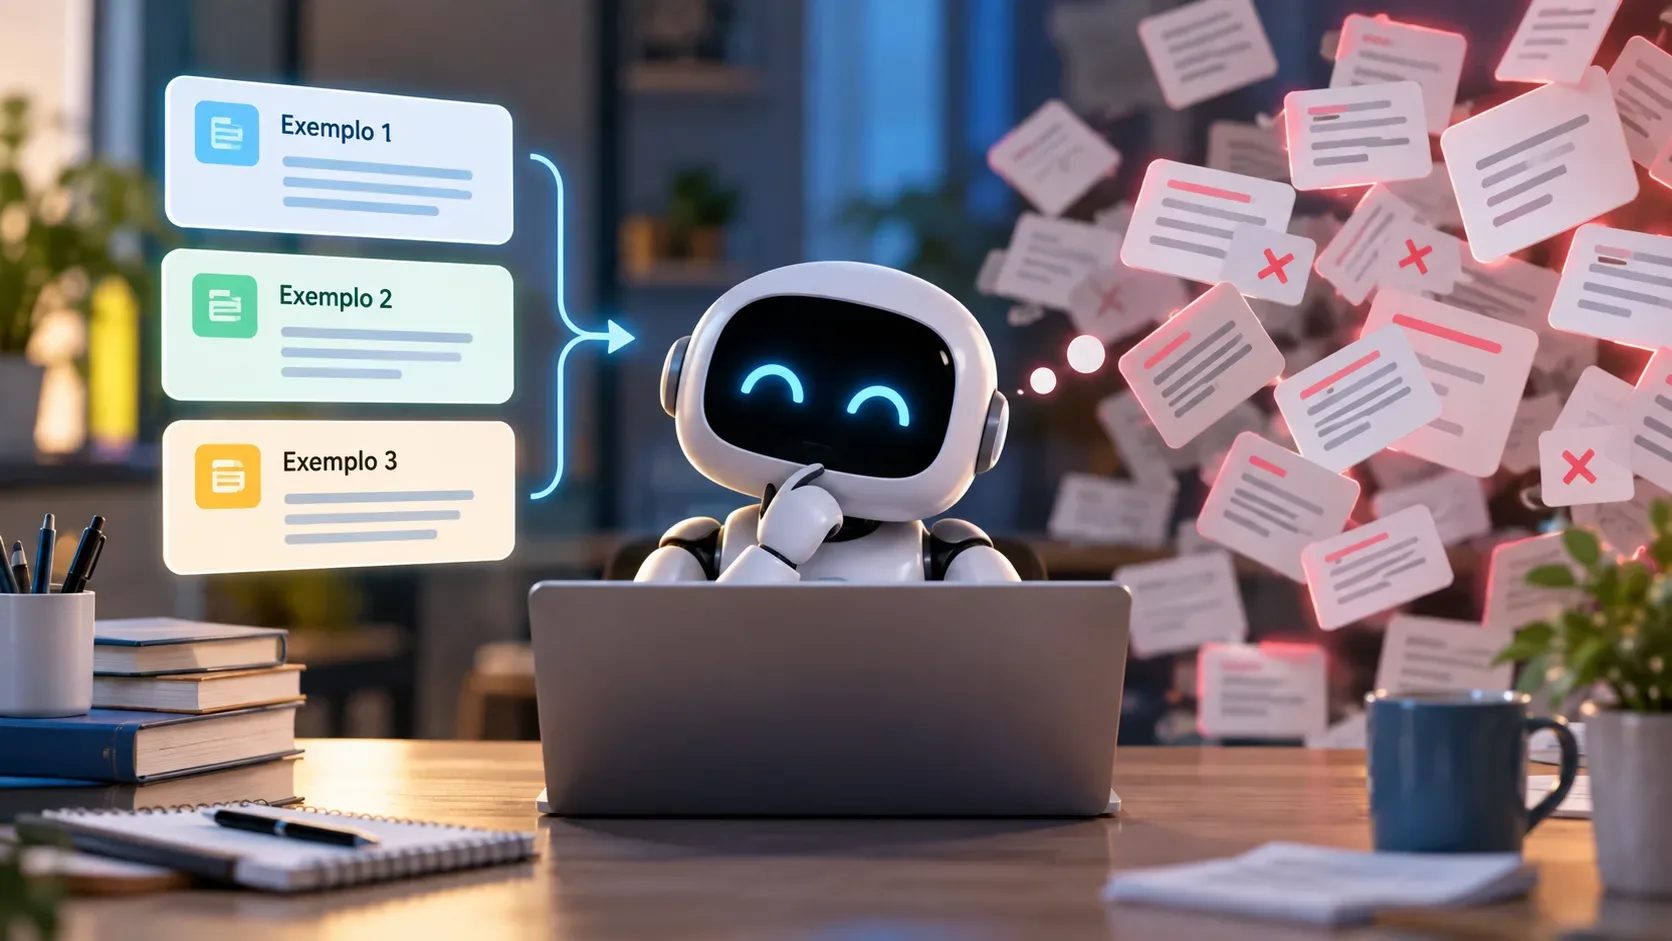
Few-shot prompting é útil quando os exemplos mostram ao modelo um padrão que seria trabalhoso, ambíguo ou frágil de especificar apenas com instruções. Ele tende a ajudar especialmente em tarefas de classificação, transformação, extração e geração com formato muito particular. Mas exemplos não são uma melhoria automática: quando repetem o que a instrução já deixa claro, cobrem casos pouco representativos, entram em conflito entre si ou ocupam contexto demais, podem adicionar ruído em vez de sinal.
O que muda quando um prompt ganha exemplos
Em um prompt zero-shot, o modelo recebe a tarefa e precisa inferir sozinho como executar e formatar a resposta. Em um prompt few-shot, alguns pares de entrada e saída mostram concretamente o comportamento esperado. A documentação da OpenAI descreve few-shot como o uso de um pequeno conjunto de exemplos para orientar o modelo a uma nova tarefa, enquanto o Google destaca que esses exemplos ajudam a regular formato, escopo e padrão da resposta. A Anthropic, por sua vez, recomenda exemplos relevantes, diversos e estruturados.
O efeito prático não vem apenas da quantidade de exemplos. Cada exemplo acrescenta pistas sobre quais características importam, como tratar ambiguidades e qual forma de saída imitar. Por isso, um exemplo bom pode eliminar uma dúvida que exigiria várias linhas de instrução, enquanto vários exemplos fracos podem ensinar padrões acidentais.
Quando few-shot costuma ajudar
1. Quando o formato desejado é difícil de descrever com precisão
Se a saída precisa seguir uma convenção específica, como um rótulo exato, uma estrutura curta, um esquema textual ou uma transformação consistente, um exemplo correto pode tornar a regra mais concreta. Isso é particularmente útil quando pequenas variações de estilo ou estrutura já contam como erro.
2. Quando a tarefa depende de distinções sutis
Classificar mensagens em categorias próximas, decidir se um trecho pertence a uma classe ou outra ou aplicar critérios de tom pode exigir fronteiras que não ficam totalmente claras em uma definição abstrata. Exemplos próximos dessas fronteiras ajudam a mostrar o que pertence e o que não pertence à categoria.
3. Quando há casos de borda recorrentes
Um conjunto de exemplos pode incluir situações que historicamente geram erro. Nesse cenário, o objetivo não é repetir casos óbvios, mas ensinar como agir diante de entradas incomuns, incompletas ou ambíguas.
4. Quando a instrução é curta, mas o comportamento esperado tem vários detalhes
Em algumas tarefas, escrever todas as regras em prosa deixa o prompt longo e difícil de manter. Exemplos bem escolhidos podem funcionar como especificação executável do comportamento. Mesmo assim, eles devem complementar, e não contradizer, a instrução principal.
Quando os exemplos só aumentam ruído
Exemplos redundantes
Se três ou quatro exemplos demonstram exatamente o mesmo padrão simples, o ganho adicional pode ser pequeno. A documentação atual da OpenAI para modelos recentes recomenda prompts mais enxutos e sugere remover instruções e exemplos repetidos um grupo por vez, medindo o resultado. O princípio é simples: mantenha exemplos quando eles codificam uma exigência real ou corrigem uma falha observada.
Exemplos inconsistentes
Se dois exemplos aplicam critérios diferentes a entradas semelhantes, o modelo recebe sinais concorrentes. Isso pode aparecer como rótulos conflitantes, níveis de detalhe diferentes, formatos divergentes ou exceções não explicadas. Antes de aumentar a quantidade, vale verificar se todos os exemplos obedecem à mesma regra.
Exemplos pouco representativos
Um conjunto composto apenas por casos fáceis pode produzir a falsa impressão de que o prompt está robusto. O Google recomenda exemplos específicos e variados e alerta que exemplos em excesso podem levar o modelo a se prender demais aos padrões apresentados. A Anthropic também enfatiza relevância e diversidade para evitar que o modelo aprenda traços acidentais.
Contexto demais para uma tarefa simples
Todo exemplo ocupa espaço no contexto e aumenta o volume de tokens processados. Em tarefas já resolvidas com uma instrução clara, adicionar demonstrações pode aumentar custo, latência e complexidade de manutenção sem produzir melhora mensurável. Em prompts longos, informação útil também pode competir por atenção com material redundante.
Como decidir: teste zero-shot contra few-shot
A decisão mais confiável é experimental. Em vez de assumir que exemplos ajudam, crie uma pequena suíte de testes representativa e compare variantes do mesmo prompt. A própria documentação da OpenAI recomenda trabalhar com avaliações, medir uma linha de base e repetir o ciclo depois de cada mudança.
| Variante | O que contém | Objetivo do teste |
|---|---|---|
| A | Instrução clara, sem exemplos | Estabelecer a linha de base zero-shot |
| B | Mesma instrução + 1 ou 2 exemplos fortes | Medir se o padrão necessário já aparece com poucos exemplos |
| C | Mesma instrução + exemplos variados e casos de borda | Testar robustez em situações difíceis |
| D | Versão enxuta removendo exemplos redundantes | Verificar se a qualidade se mantém com menos contexto |
Monte um conjunto de teste que possa revelar diferenças
Um teste útil não deve conter apenas entradas parecidas com os exemplos do prompt. Separe casos comuns, casos de borda, entradas ambíguas e exemplos que mudam apenas um detalhe relevante. Para uma tarefa de classificação, por exemplo, inclua itens claramente pertencentes a cada classe e itens próximos à fronteira. Para transformação de texto, varie tamanho, ordem, tom e presença de campos opcionais.
Defina também o que significa sucesso antes de rodar o teste. Dependendo da tarefa, os critérios podem incluir acurácia do rótulo, validade de um formato, presença de campos obrigatórios, ausência de texto extra, fidelidade ao conteúdo ou avaliação humana. Sem critério fixo, é fácil preferir uma variante apenas porque uma resposta isolada parece melhor.
Um roteiro prático para selecionar exemplos
- Comece com a instrução mais clara possível e meça o desempenho sem exemplos.
- Liste os tipos de erro reais que aparecem nessa linha de base.
- Adicione exemplos que representem esses erros ou fronteiras, evitando casos que apenas repetem o óbvio.
- Mantenha o formato dos exemplos consistente para não introduzir sinais contraditórios.
- Inclua diversidade suficiente para que o modelo não associe a regra a um detalhe irrelevante.
- Rode novamente o mesmo conjunto de teste e compare métricas e erros, não apenas impressões.
- Remova um grupo de exemplos por vez e confirme se a qualidade cai. Se não cair, o grupo provavelmente era dispensável.
Few-shot não substitui uma instrução ruim
Exemplos podem demonstrar comportamento, mas não corrigem automaticamente uma tarefa mal definida. Se o objetivo, as restrições ou os critérios de sucesso são vagos, o modelo pode imitar os exemplos sem compreender qual regra deve generalizar para novos casos. Primeiro deixe explícito o que deve ser feito; depois use exemplos para mostrar como essa regra aparece na prática.
Quantidade ideal depende da tarefa
Não existe um número universal de exemplos que maximize a qualidade. A Anthropic sugere alguns exemplos bem escolhidos e cita de três a cinco como uma boa referência em sua documentação atual, enquanto o Google observa que o número ótimo precisa ser experimentado e que exemplos demais podem causar sobreajuste ao padrão mostrado. Para outro modelo, outra tarefa ou outro conjunto de entradas, o ponto de equilíbrio pode mudar.
Na prática, a melhor política é usar o menor conjunto que resolva uma falha medida. Se zero-shot já atende aos critérios, não há obrigação de adicionar few-shot. Se dois exemplos corrigem o problema, dez exemplos precisam justificar o custo adicional em resultados.
Regra operacional
Use few-shot quando cada exemplo acrescenta uma informação que a instrução sozinha não transmite com a mesma clareza, como uma fronteira de decisão, um caso de borda ou um formato difícil. Remova exemplos quando eles apenas repetem a regra, introduzem exceções não intencionais ou não melhoram o conjunto de testes. O objetivo não é ter um prompt mais cheio, e sim um prompt que generalize melhor sobre entradas reais.