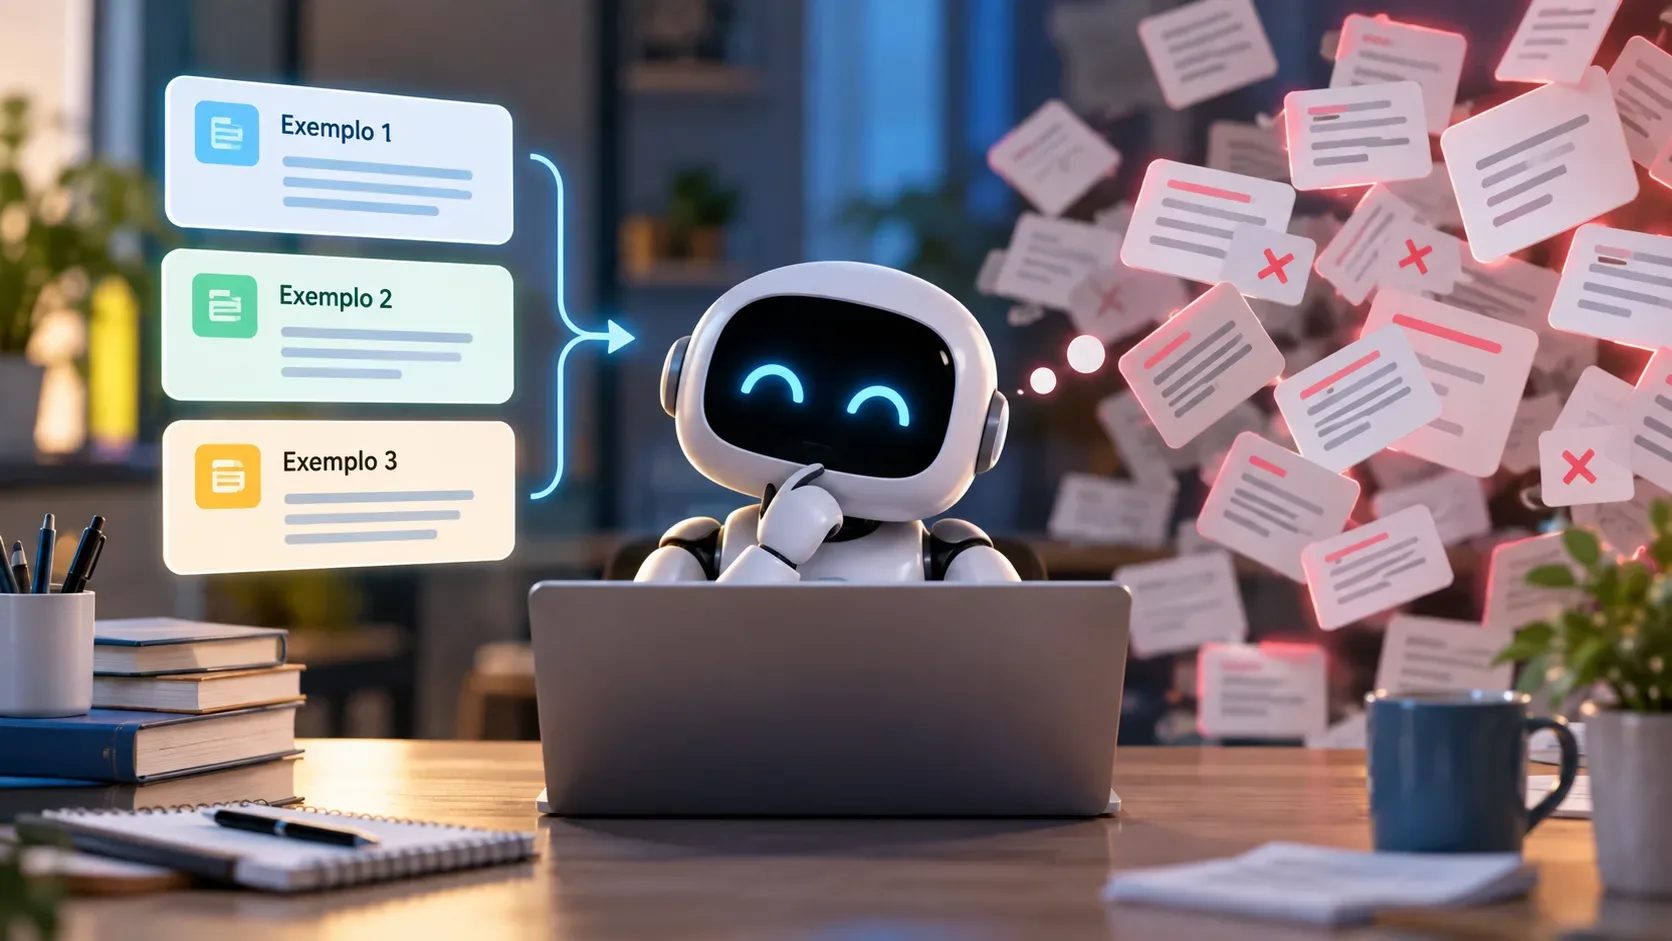
El prompting few-shot es útil cuando los ejemplos muestran al modelo un patrón que sería engorroso, ambiguo o frágil de especificar solo con instrucciones. Suele ayudar especialmente en tareas de clasificación, transformación, extracción y generación que exigen un formato muy particular. Pero los ejemplos no son una mejora automática: cuando repiten lo que la instrucción ya deja claro, cubren casos poco representativos, entran en conflicto entre sí u ocupan demasiado contexto, pueden añadir ruido en lugar de señal.
Qué cambia cuando un prompt incluye ejemplos
En un prompt zero-shot, el modelo recibe la tarea y debe inferir por sí mismo cómo ejecutarla y dar formato a la respuesta. En un prompt few-shot, algunos pares de entrada y salida muestran de forma concreta el comportamiento esperado. La documentación de OpenAI describe few-shot como el uso de unos pocos ejemplos para orientar al modelo hacia una nueva tarea, mientras que Google señala que los ejemplos ayudan a regular formato, alcance y patrón general de respuesta. Anthropic recomienda ejemplos relevantes, diversos y estructurados.
El efecto práctico no depende solo de la cantidad. Cada ejemplo añade pistas sobre qué características importan, cómo tratar ambigüedades y qué forma de salida imitar. Por eso, un buen ejemplo puede eliminar una duda que exigiría varias líneas de instrucción, mientras que muchos ejemplos débiles pueden enseñar patrones accidentales.
Cuándo suele ayudar few-shot
1. Cuando el formato deseado es difícil de describir con precisión
Si la salida debe seguir una convención específica, como una etiqueta exacta, una estructura breve, un esquema textual o una transformación consistente, un ejemplo correcto puede volver la regla más concreta. Esto es especialmente útil cuando pequeñas variaciones de estilo o estructura ya cuentan como error.
2. Cuando la tarea depende de distinciones sutiles
Clasificar mensajes en categorías cercanas, decidir si un fragmento pertenece a una clase u otra o aplicar criterios de tono puede exigir fronteras que no quedan totalmente claras en una definición abstracta. Los ejemplos próximos a esas fronteras ayudan a mostrar qué pertenece y qué no.
3. Cuando existen casos límite recurrentes
Un conjunto de ejemplos puede incluir situaciones que históricamente generan errores. En este escenario, el objetivo no es repetir casos obvios, sino mostrar cómo actuar ante entradas inusuales, incompletas o ambiguas.
4. Cuando la instrucción es corta, pero el comportamiento esperado tiene muchos detalles
En algunas tareas, escribir todas las reglas en prosa vuelve el prompt largo y difícil de mantener. Ejemplos bien elegidos pueden funcionar como una especificación ejecutable del comportamiento. Aun así, deben complementar y no contradecir la instrucción principal.
Cuándo los ejemplos solo añaden ruido
Ejemplos redundantes
Si tres o cuatro ejemplos demuestran exactamente el mismo patrón simple, la ganancia adicional puede ser pequeña. La guía actual de modelos de OpenAI recomienda prompts más concisos y sugiere retirar instrucciones y ejemplos repetidos por grupos, midiendo los resultados. El principio práctico es conservar ejemplos cuando codifican un requisito real o corrigen un fallo observado.
Ejemplos inconsistentes
Si dos ejemplos aplican criterios diferentes a entradas similares, el modelo recibe señales competidoras. Esto puede aparecer como etiquetas conflictivas, niveles de detalle distintos, formatos divergentes o excepciones no explicadas. Antes de aumentar la cantidad, conviene comprobar que todos los ejemplos obedecen a la misma regla.
Ejemplos poco representativos
Un conjunto formado solo por casos fáciles puede crear la falsa impresión de que el prompt es robusto. Google recomienda ejemplos específicos y variados y advierte que demasiados ejemplos pueden hacer que el modelo se ajuste en exceso a los patrones mostrados. Anthropic también enfatiza relevancia y diversidad para evitar que el modelo aprenda rasgos accidentales.
Demasiado contexto para una tarea simple
Cada ejemplo ocupa contexto y aumenta la cantidad de tokens procesados. En tareas ya resueltas con una instrucción clara, añadir demostraciones puede aumentar coste, latencia y complejidad de mantenimiento sin producir una mejora medible. En prompts largos, la información útil también puede competir por atención con material redundante.
Cómo decidir: comparar zero-shot y few-shot
La decisión más fiable es experimental. En lugar de asumir que los ejemplos ayudan, crea un pequeño conjunto de pruebas representativo y compara variantes del mismo prompt. La documentación de OpenAI recomienda trabajar con evaluaciones, medir una línea base y repetir el ciclo después de cada cambio.
| Variante | Qué contiene | Objetivo de la prueba |
|---|---|---|
| A | Instrucción clara, sin ejemplos | Establecer una línea base zero-shot |
| B | Misma instrucción + 1 o 2 ejemplos sólidos | Medir si el patrón necesario aparece con pocos ejemplos |
| C | Misma instrucción + ejemplos variados y casos límite | Probar robustez en situaciones difíciles |
| D | Versión concisa eliminando ejemplos redundantes | Comprobar si la calidad se mantiene con menos contexto |
Construye un conjunto de prueba que pueda revelar diferencias
Una prueba útil no debe contener solo entradas parecidas a los ejemplos del prompt. Separa casos comunes, casos límite, entradas ambiguas y elementos que cambian solo un detalle relevante. Para una tarea de clasificación, por ejemplo, incluye elementos claramente pertenecientes a cada clase y otros próximos a la frontera de decisión. Para transformación de texto, varía longitud, orden, tono y presencia de campos opcionales.
Define también qué significa éxito antes de ejecutar la prueba. Según la tarea, los criterios pueden incluir exactitud de la etiqueta, formato válido, presencia de campos obligatorios, ausencia de texto extra, fidelidad al contenido o evaluación humana. Sin criterios fijos, es fácil preferir una variante simplemente porque una respuesta aislada parece mejor.
Un proceso práctico para seleccionar ejemplos
- Empieza con la instrucción más clara posible y mide el rendimiento sin ejemplos.
- Enumera los tipos de error reales que aparecen en esa línea base.
- Añade ejemplos que representen esos errores o fronteras, evitando casos que solo repitan lo obvio.
- Mantén un formato consistente entre ejemplos para no introducir señales contradictorias.
- Incluye suficiente diversidad para que el modelo no asocie la regla con un detalle irrelevante.
- Ejecuta de nuevo el mismo conjunto de prueba y compara métricas y errores, no solo impresiones.
- Elimina un grupo de ejemplos cada vez y comprueba si la calidad disminuye. Si no disminuye, probablemente ese grupo era innecesario.
Few-shot no sustituye una instrucción deficiente
Los ejemplos pueden demostrar comportamiento, pero no corrigen automáticamente una tarea mal definida. Si el objetivo, las restricciones o los criterios de éxito son vagos, el modelo puede imitar los ejemplos sin comprender qué regla debe generalizar a casos nuevos. Primero deja claro qué debe hacerse; después usa ejemplos para mostrar cómo se manifiesta esa regla en la práctica.
La cantidad ideal depende de la tarea
No existe un número universal de ejemplos que maximice la calidad. Anthropic recomienda un conjunto pequeño de ejemplos bien escogidos y actualmente menciona de tres a cinco como una referencia útil, mientras que Google señala que el número óptimo debe experimentarse y que demasiados ejemplos pueden provocar un ajuste excesivo al patrón mostrado. Para otro modelo, otra tarea u otra distribución de entradas, el equilibrio puede cambiar.
En la práctica, la mejor política es usar el conjunto más pequeño que resuelva un fallo medido. Si zero-shot ya cumple los criterios, no hay obligación de añadir few-shot. Si dos ejemplos corrigen el problema, diez ejemplos deben justificar su coste adicional con mejores resultados.
Regla operativa
Usa few-shot cuando cada ejemplo aporte información que la instrucción por sí sola no transmite con la misma claridad, como una frontera de decisión, un caso límite o un formato difícil. Elimina ejemplos cuando solo repiten la regla, introducen excepciones no deseadas o no mejoran el conjunto de pruebas. El objetivo no es tener un prompt más lleno, sino uno que generalice mejor sobre entradas reales.