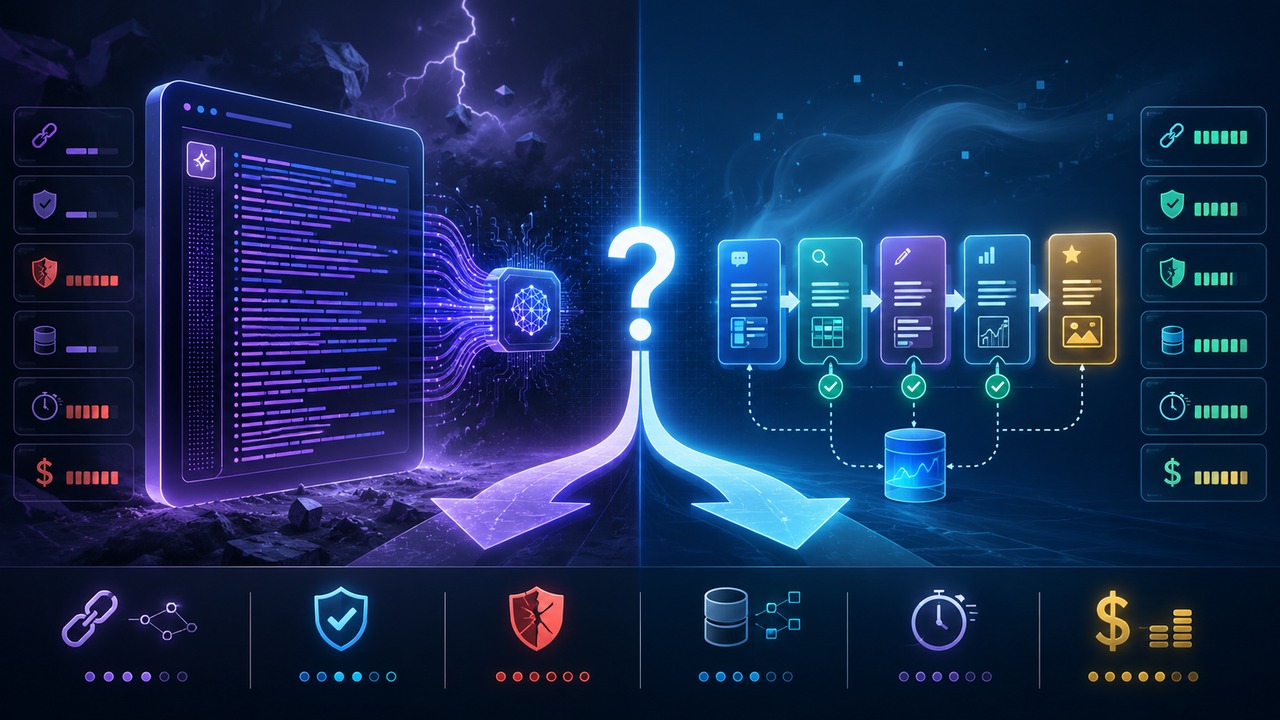
A escolha entre mega-prompt e prompt chaining não deveria começar pelo tamanho do texto do prompt. O critério mais útil é outro: o sistema precisa controlar alguma coisa entre uma etapa e a seguinte? Se a única coisa que importa é a resposta final e o modelo consegue receber todo o contexto relevante de uma vez, uma chamada única costuma ser o melhor ponto de partida. Se um resultado intermediário precisa ser validado, registrado, transformado, aprovado, usado por uma ferramenta ou capaz de mudar o caminho seguinte, separar o trabalho em chamadas passa a criar valor arquitetural.
Aqui, mega-prompt significa uma única chamada que reúne objetivo, contexto, regras, critérios e várias instruções de execução. Prompt chaining significa uma sequência explícita de chamadas em que a saída de uma etapa alimenta, restringe ou condiciona a próxima. Isso é diferente de pedir para o modelo "pensar passo a passo" dentro da mesma resposta. O chaining está na aplicação e no fluxo entre chamadas; o raciocínio interno do modelo pode existir em qualquer uma das duas arquiteturas.
Complexidade sozinha não obriga a criar uma chain
Modelos atuais conseguem lidar com planejamento e tarefas multietapa dentro de uma única interação, por isso não existe uma regra do tipo "mais de três passos exige chaining". A documentação atual da Anthropic diz que seus modelos recentes lidam internamente com boa parte do raciocínio multietapa e reserva o chaining explícito para situações em que é importante inspecionar saídas intermediárias ou impor uma estrutura de pipeline. A documentação do Google Cloud, por outro lado, destaca que dividir tarefas complexas em subtarefas pode aumentar controlabilidade, depuração e precisão. As duas orientações não são contraditórias: elas apontam para a fronteira entre raciocínio que pode ficar dentro da chamada e controle que precisa existir fora dela.
A documentação da OpenAI segue uma lógica parecida ao recomendar que workflows complexos sejam avaliados por sucesso da tarefa, completude, evidências exigidas, tokens, latência e custo. Em outras palavras, contar chamadas não basta. Uma arquitetura com menos chamadas pode ser pior se falhar mais; uma arquitetura com mais chamadas pode ser pior se apenas repetir contexto e aumentar tempo sem criar um checkpoint útil.
Dependência entre etapas: a pergunta mais importante
Se as etapas são apenas partes de uma mesma elaboração, uma chamada única tende a preservar melhor o contexto e evita o custo de transportar resultados intermediários. Imagine uma tarefa de escrever uma resposta técnica que precisa considerar objetivo, público, tom e restrições. Embora seja possível descrever isso como "analisar, planejar, escrever e revisar", essas fases podem ser apenas o processo interno necessário para chegar a um único resultado. Transformá-las automaticamente em quatro chamadas pode não acrescentar controle real.
O chaining ganha força quando a etapa seguinte depende de um artefato intermediário que precisa existir de forma explícita. É o caso de extrair entidades de documentos antes de consultar um banco, classificar uma solicitação antes de escolher uma ferramenta, produzir um plano antes de executar ações ou gerar um rascunho que precisa passar por uma verificação independente. Nesses casos, a saída intermediária não é apenas pensamento: ela vira estado do sistema.
Uma forma simples de testar essa fronteira é perguntar: se eu apagar a saída intermediária e deixar o modelo resolver tudo de uma vez, perco a capacidade de tomar alguma decisão importante? Se a resposta for não, provavelmente a chain ainda não se justificou. Se a resposta for sim, a divisão já está cumprindo uma função de engenharia.
Validação: quando um checkpoint muda a arquitetura
Validação é uma das razões mais fortes para separar chamadas. Em um mega-prompt, o modelo pode ser instruído a conferir o próprio trabalho antes de responder, mas o software só recebe o resultado ao final. Isso pode ser suficiente quando o erro é barato, reversível e fácil de detectar depois.
Em uma chain, o sistema pode exigir um contrato por etapa. Uma extração pode precisar obedecer a um schema antes de avançar. Uma classificação pode precisar atingir uma regra de confiança ou cair em revisão humana. Um rascunho pode ser comparado a critérios objetivos antes da etapa de edição. A diferença prática é que o pipeline consegue parar, repetir ou mudar de rota antes que o erro seja incorporado ao produto final.
Esse padrão aparece também na recomendação da Anthropic de usar chamadas separadas para gerar, revisar e refinar quando se deseja registrar, avaliar ou ramificar em qualquer ponto. O ganho não vem de um suposto efeito mágico de "mais prompts". Vem da possibilidade de observar e governar o que acontece entre eles.
Isolamento de falhas: chains ajudam, mas também propagam erros
Um mega-prompt oferece um ponto único de falha. Isso simplifica operação e observabilidade: há uma entrada, uma resposta e um resultado para avaliar. O problema é que, quando a resposta sai incompleta, pode ser difícil saber se a causa foi interpretação
do objetivo, seleção de evidências, transformação dos dados, formatação ou alguma combinação desses fatores.
Uma chain torna o diagnóstico mais local. Se a extração está correta e a classificação está errada, o erro fica mais fácil de reproduzir e corrigir. Também é possível repetir apenas a etapa problemática em vez de reexecutar todo o fluxo.
Mas modularidade não elimina falhas; ela pode criar falhas em cascata. Uma extração ruim alimenta uma classificação aparentemente consistente, que alimenta uma recomendação ainda mais distante da origem. Por isso, uma chain útil não é apenas uma sequência de prompts. Ela precisa de critérios de parada, validação de contratos e uma decisão clara sobre o que fazer quando uma etapa produz saída insuficiente.
Estado: uma chamada esconde o processo, uma chain externaliza partes dele
Na chamada única, grande parte do estado fica implícita no contexto recebido pelo modelo. Isso é conveniente quando o trabalho é curto e autocontido. Em uma chain, o estado passa a ser um elemento de projeto: quais campos devem atravessar etapas, o que deve ser descartado, o que precisa ser persistido e qual informação pode ser recalculada.
Essa externalização pode melhorar rastreabilidade e permitir branching. Por exemplo, uma etapa de triagem pode encaminhar casos simples para uma resposta barata e casos complexos para um modelo mais capaz, uma ferramenta ou um humano. Também permite que um resultado intermediário seja reutilizado por mais de uma etapa sem pedir ao modelo que o gere novamente.
O risco é transformar a conversa inteira em estado permanente por comodidade. Quanto mais histórico é reenviado sem necessidade, maior a chance de repetir instruções, aumentar tokens e misturar decisões antigas com a tarefa atual. Uma boa chain transporta o estado mínimo necessário, de preferência em um formato previsível e validável.
Latência: etapas sequenciais têm um preço visível
Cada chamada sequencial cria mais um trecho de espera entre entrada e saída. Para uma interface interativa em que o usuário espera uma resposta imediata, esse custo pode ser mais importante do que a melhoria marginal de controle. Se o trabalho pode ser resolvido em uma chamada com qualidade estável, quebrá-lo em cinco etapas tende a alongar o tempo até o resultado.
Nem toda decomposição precisa ser sequencial. A documentação do Google distingue chaining, em que uma saída alimenta a seguinte, de agregação, em que subtarefas independentes podem rodar em paralelo e depois ser combinadas. Essa distinção importa porque duas tarefas independentes não deveriam formar uma chain artificial apenas por estarem no mesmo workflow.
Por isso, a pergunta correta sobre latência não é "quantas etapas existem?", mas "quantas dependências realmente precisam ser serializadas?". O que puder ser feito em paralelo pode reduzir o tempo de parede; o que precisar esperar uma validação inevitavelmente adicionará latência em troca de controle.
Custo: mais chamadas não significa automaticamente mais caro ou mais barato
É fácil assumir que uma única chamada sempre custa menos, mas o total depende de quanto contexto cada etapa recebe, quanto texto intermediário é gerado, quais modelos são usados, quanto trabalho precisa ser repetido e quantas falhas exigem retry. Uma chain mal desenhada pode reenviar o mesmo contexto várias vezes e pagar por saídas intermediárias que não agregam valor. Uma chain bem desenhada pode usar um modelo pequeno em tarefas simples, reservar um modelo mais caro para uma etapa difícil e evitar reexecuções completas quando algo falha.
A orientação mais segura é medir custo por tarefa concluída com sucesso, não custo por chamada. A própria documentação atual da OpenAI recomenda comparar total de tokens, latência, custo, chamadas, turnos e retries junto com a qualidade final. Essa forma de medir evita otimizações que parecem eficientes no contador de requisições, mas produzem mais erros ou mais trabalho corretivo.
O mesmo problema em uma chamada e em uma chain
Considere um sistema que recebe dezenas de comentários de clientes e precisa entregar um plano de melhorias priorizado.
Versão em mega-prompt
Uma única chamada recebe os comentários e a instrução completa: identificar problemas recorrentes, agrupar temas, estimar impacto, priorizar ações e escrever o plano final. Essa arquitetura pode funcionar muito bem quando o volume cabe no contexto, a taxonomia não precisa ser reaproveitada e ninguém precisa aprovar os agrupamentos antes da recomendação. O benefício é a simplicidade: uma requisição, um conjunto de instruções e uma resposta final.
O ponto fraco aparece quando o plano sai ruim. Pode ser difícil separar se o erro começou na extração dos problemas, no agrupamento, na prioridade ou na redação. Também não há um ponto natural para reutilizar os temas extraídos em outro processo.
Versão em prompt chaining
Na primeira chamada, o modelo extrai problemas e evidências de cada comentário em um formato estruturado. O software valida o formato e rejeita registros incompletos. Na segunda chamada, os problemas validados são agrupados e classificados. Na terceira, o sistema aplica regras de prioridade ou solicita revisão humana para casos limítrofes. Só então uma chamada final transforma os dados aprovados em um plano de ação legível.
A chain é maior, mas cada fronteira tem uma função: validar dados, isolar erro, guardar estado ou autorizar o próximo passo. Se essas funções não forem necessárias, a mesma decomposição pode ser apenas burocracia computacional.
O que a pesquisa mostra, e o que ela ainda não permite concluir
Um trabalho publicado no Findings of ACL de 2024 comparou duas formas de fazer refinamento de sumarização. No prompt chaining, rascunho, crítica e revisão foram executados em três chamadas separadas. No chamado stepwise prompt, as mesmas fases
foram solicitadas dentro de uma única geração. No experimento principal, a estratégia de chaining obteve mais vitórias nas comparações de qualidade, incluindo 77 vitórias em 100 comparações reportadas. Os próprios autores limitam a conclusão ao cenário estudado de sumarização e pedem validação em outras tarefas.
Esse detalhe é importante porque evita transformar um resultado específico em uma lei geral. O estudo mostra que separar geração, crítica e revisão pode produzir ganho real em certas condições. Não mostra que qualquer tarefa complexa fica melhor quando repartida em várias chamadas.
Um preprint de 2026 sobre geração automatizada de relatórios acadêmicos chegou a uma conclusão favorável ao chaining no seu caso de uso: o pipeline multietapa foi comparado a um baseline single-shot otimizado e apresentou maior confiabilidade e uma melhora menor na métrica de similaridade textual utilizada. Como é um estudo de caso estreito, com domínio e avaliação específicos, ele serve como evidência de que a arquitetura pode fazer diferença, não como um benchmark universal.
Em outra direção, pesquisas de 2026 sobre workflows com múltiplos agentes reforçam uma cautela útil: mais componentes não garantem melhor resultado. Um estudo com sete benchmarks mostrou que, em workflows homogêneos, um único modelo executando a decomposição em múltiplos turnos podia igualar o desempenho de configurações multiagente com menor custo em seu ambiente. A lição para prompt chaining é que decompor a tarefa e multiplicar executores são decisões diferentes. Às vezes, basta manter um único modelo e tornar as etapas explícitas.
Um método prático para decidir sem dogma
Comece com a menor arquitetura que passa no seu teste
Monte primeiro uma chamada única com objetivo, contexto, restrições, critérios de sucesso e formato de saída claros. Rode uma avaliação com casos representativos. Se ela entrega o resultado com consistência suficiente, a simplicidade é uma vantagem real: menos pontos de falha, menos estado e menos latência de orquestração.
Divida no ponto exato em que aparece uma necessidade de controle
Quando os erros mostrarem um padrão, procure a fronteira. Talvez a extração precise ser validada antes da geração. Talvez uma busca precise acontecer apenas depois de classificar a intenção. Talvez um humano precise aprovar uma decisão antes de disparar uma ferramenta. É nesse limite que uma nova etapa costuma se pagar.
Dê um contrato a cada etapa
Uma etapa sem critério próprio é difícil de testar. Defina o que entra, o que deve sair, quais campos são obrigatórios, que evidência precisa ser preservada e o que caracteriza falha. Quanto mais clara for essa interface, menor a chance de a chain virar apenas uma conversa longa fragmentada em várias requisições.
Meça o sistema inteiro
Compare taxa de sucesso, completude, erros por etapa, retries, latência de ponta a ponta, tokens e custo por tarefa bem-sucedida. Se a chain aumenta a qualidade, mas dobra a latência em um produto sensível a tempo, talvez seja necessário reduzir etapas. Se a
chamada única é barata, mas exige muitas correções, o custo operacional pode estar escondido fora da API.
A regra de bolso
Mantenha uma única chamada quando a tarefa é uma transação conceitualmente única: todo o contexto pode ser fornecido de uma vez, só o resultado final precisa ser consumido e não existe uma decisão externa importante no meio do caminho.
Use prompt chaining quando as fronteiras entre etapas precisam existir para o software: validar, ramificar, registrar, reutilizar, chamar ferramentas, trocar de modelo, pedir aprovação ou repetir apenas uma parte do trabalho.
A diferença central não é "prompt curto versus prompt longo". É raciocínio interno versus arquitetura externa. O mega-prompt deixa o modelo coordenar o processo dentro de uma chamada. A chain transforma partes desse processo em estados observáveis e controláveis. A escolha certa é a que entrega a qualidade necessária com o menor nível de orquestração que seus testes conseguem justificar.