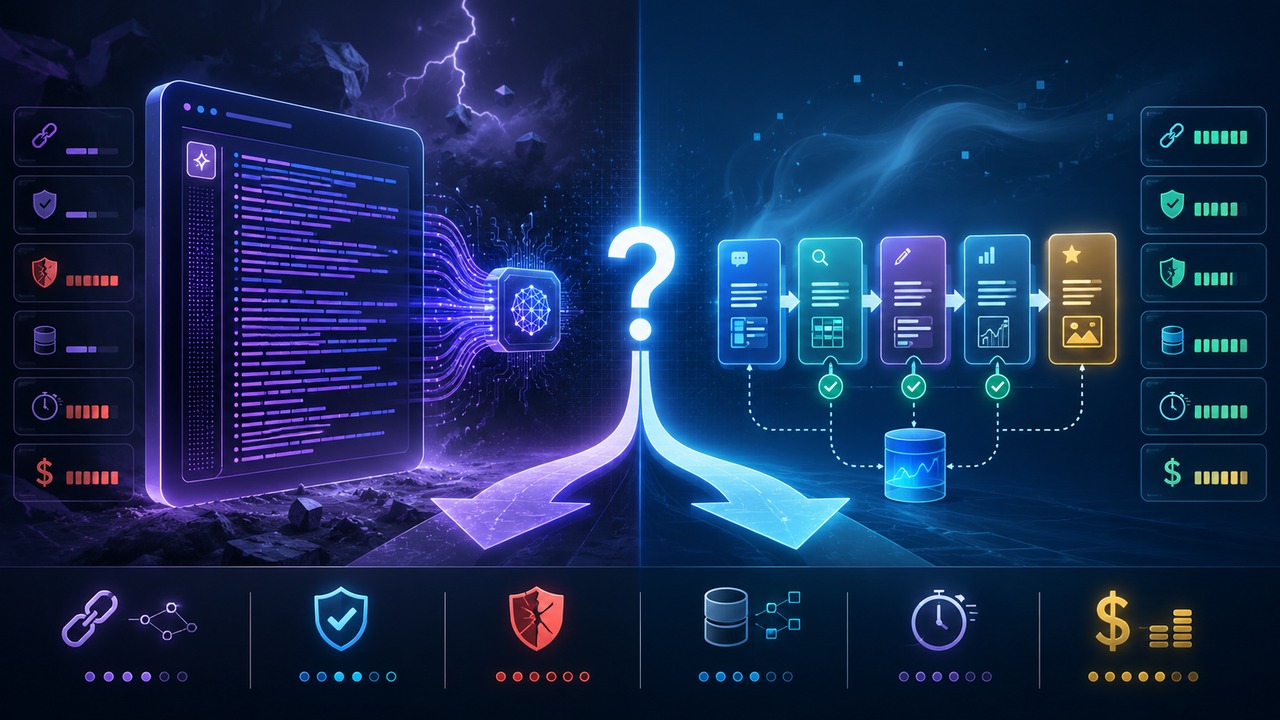
Se a resposta vai ser lida por uma pessoa, pedir “responda em JSON” pode funcionar bem. Se ela vai direto para um parser, banco de dados, fila, planilha, API ou automação, a pergunta muda: qual contrato o seu código precisa receber? Em 2026, OpenAI, Claude e Gemini oferecem mecanismos nativos de saída estruturada com JSON Schema, mas isso não torna prompt, JSON livre e schema equivalentes.
A regra prática é simples. A instrução textual tenta orientar o formato. Um modo JSON cuida principalmente da sintaxe. Structured Outputs tenta impor a forma do objeto. Nenhuma dessas camadas, sozinha, prova que o conteúdo está correto.
Há três problemas diferentes escondidos na frase “quero JSON”
O primeiro problema é a aparência da resposta. Você quer que o modelo não coloque introdução, Markdown, comentários ou explicações em volta do objeto. Um prompt como “responda somente em JSON” costuma ajudar, mas continua sendo uma instrução comportamental. O modelo ainda pode trocar nomes de campos, omitir propriedades, mudar tipos ou escolher um formato parecido, mas incompatível com o seu código.
O segundo problema é a validade sintática. Aqui a pergunta é: a string pode ser analisada como JSON sem erro? A OpenAI ainda documenta um JSON mode separado, mais antigo, que garante JSON válido, mas não o schema desejado. Isso elimina uma classe de falhas de parsing, porém não impede que a resposta venha com os campos errados.
O terceiro problema é a conformidade com um contrato. Nesse caso, não basta receber um objeto válido; ele precisa conter as propriedades previstas, os tipos corretos e, quando aplicável, valores limitados por enum. É para isso que servem Structured Outputs e mecanismos equivalentes baseados em JSON Schema.
A diferença mais importante é esta: formato válido não é o mesmo que estrutura válida, e estrutura válida não é o mesmo que resposta verdadeira.
O mesmo caso de extração mostra onde cada abordagem quebra
Imagine um sistema que recebe uma mensagem de atendimento e precisa extrair cinco campos: nome do cliente, intenção, prioridade, necessidade de retorno e telefone. A intenção só pode ser “upgrade”, “cancelamento” ou “suporte”. A prioridade só pode ser “baixa”, “média” ou “alta”. O telefone pode ser nulo quando não estiver presente.
Com instrução textual, você pode descrever esse formato no prompt e até fornecer um exemplo. Em muitos casos o modelo obedecerá. Mas, em uma execução, ele pode usar “cliente” em vez de “nome_cliente”; em outra, pode transformar prioridade em número; em outra, pode acrescentar uma explicação fora do JSON.
Com JSON válido, o parser deixa de ser o principal problema. Ainda assim, nada impede um objeto perfeitamente analisável como {"urgente": true, "categoria": "upgrade"} quando seu código esperava outro conjunto de campos.
Com JSON Schema, o contrato passa a fazer parte da própria configuração de geração. O modelo fica restrito ao conjunto de chaves, tipos e valores permitidos pelo schema, dentro das capacidades de cada provedor. Isso reduz drasticamente erros de integração, mas não impede um erro semântico. O modelo ainda pode escolher “suporte” quando o texto indicava “upgrade”, ou preencher um valor plausível em um campo que deveria ficar nulo.
Essa separação entre erro de formato e erro de conteúdo é o ponto que mais evita falsa confiança.
OpenAI: JSON mode resolve parsing; Structured Outputs resolve o contrato
Na API da OpenAI, Structured Outputs pode ser usado para estruturar a resposta final ou para restringir argumentos de function calling. A documentação atual recomenda Structured Outputs em vez do JSON mode sempre que o modelo e o caso de uso oferecerem suporte.
No JSON mode, a garantia central é receber JSON válido. O schema continua sendo responsabilidade da aplicação. Se você espera campos específicos, precisa validar o objeto depois e decidir o que fazer quando houver chave ausente, tipo errado ou valor fora do domínio esperado.
Em Structured Outputs, a OpenAI usa um subconjunto de JSON Schema e impõe regras próprias. Objetos devem bloquear propriedades extras com additionalProperties definido como false, e todos os campos precisam constar como required. Quando um campo é conceitualmente opcional, a saída pode modelá-lo como obrigatório, mas aceitando null. O objeto raiz também tem restrições específicas, como não poder ser um anyOf no topo.
Isso significa que um schema que funciona em outra biblioteca ou provedor pode precisar de adaptação antes de ser enviado à OpenAI.
Há ainda duas exceções operacionais que o código precisa tratar. Uma recusa de segurança pode vir fora do schema esperado, em um sinal específico de refusal. E uma resposta interrompida por limite de tokens pode ficar incompleta. Structured Outputs elimina a necessidade de retries por violação normal de schema, mas não transforma toda chamada de API em um objeto de negócio utilizável.
Claude: saída JSON estruturada e tool use estrito são controles diferentes
A Anthropic hoje oferece Structured Outputs no Claude em duas frentes. Para a resposta final, a API usa JSON outputs por meio de output_config.format. Para chamadas de ferramentas, strict: true restringe os parâmetros ao schema da tool.
Essa distinção é útil porque responde a dois problemas diferentes. Se o modelo precisa devolver um objeto para a sua aplicação, você estrutura a saída final. Se ele precisa acionar uma função, você torna estritos os argumentos da ferramenta. Em fluxos agentic, os dois mecanismos podem ser usados juntos.
A documentação do Claude também mostra por que “JSON Schema” não significa automaticamente “toda a especificação JSON Schema”. Alguns constraints não são aceitos diretamente pelo mecanismo de geração. Os SDKs podem simplificar schemas gerados por Pydantic ou Zod, mover certas restrições para descrições e depois validar localmente contra o schema original. Assim, a aplicação continua precisando saber qual parte foi realmente imposta durante a geração e qual parte foi checada depois.
Também existem exceções explícitas. Uma recusa de segurança pode terminar a resposta com stop_reason de refusal e não obedecer ao schema. Um max_tokens pode cortar a saída. E a própria documentação registra uma ressalva incomum para enums de string: a capitalização pode variar em alguns casos. Se seus valores só diferem por caixa, isso é um desenho frágil de contrato.
Há ainda uma armadilha de portabilidade importante: na camada de compatibilidade com o SDK da OpenAI, a Anthropic informa que strict em function calling é ignorado. Para garantia de conformidade no Claude, o caminho recomendado é a API nativa com Structured Outputs.
Gemini: schema reduz a ambiguidade, mas não substitui validação de negócio
A documentação atual do Gemini permite configurar structured outputs com JSON Schema, usando resposta em application/json e um schema associado. O resultado é gerado como JSON sintaticamente válido que corresponde ao formato aceito pela implementação do provedor.
O Gemini suporta um subconjunto de JSON Schema. Há suporte para tipos como string, number, integer, boolean, object, array e null, além de recursos úteis como required, enum, limites numéricos e propriedades de arrays em determinadas superfícies da API. Nem todo recurso da especificação é aceito, e schemas muito grandes ou muito aninhados podem ser rejeitados.
Um detalhe particularmente importante aparece nas próprias boas práticas do Google: structured output garante a forma, não a correção semântica dos valores. A recomendação é validar a saída final no código antes de usá-la em regras de negócio.
Isso evita um erro comum de arquitetura. Um enum pode impedir que o modelo escreva “urgentíssimo” quando o contrato aceita apenas “baixa”, “média” e “alta”. Mas ele não impede que o modelo escolha “alta” quando a mensagem deveria ser classificada como “média”. O objeto pode ser impecável para o parser e ainda estar errado para o produto.
Portabilidade não é copiar o mesmo schema entre três APIs
Os três provedores convergiram em torno de JSON Schema como linguagem de contrato, mas não convergiram em todos os detalhes de implementação.
Na OpenAI, há exigências como required para todos os campos e additionalProperties false. No Claude, há um conjunto próprio de recursos e limites de complexidade, além de transformações que alguns SDKs fazem automaticamente. No Gemini, a documentação também fala explicitamente em subconjunto da especificação e em possíveis rejeições de schemas complexos.
Por isso, a estratégia mais robusta para uma aplicação multi-provedor é manter um modelo canônico de dados dentro do seu código e criar uma camada fina de adaptação para cada API. O domínio deve dizer o que “cliente”, “prioridade” ou “resultado” significam. O adaptador deve traduzir esse contrato para o subconjunto aceito pelo provedor.
Isso também evita que detalhes de uma API vazem para todo o sistema. Se amanhã um provider mudar o nome do parâmetro, ampliar o suporte a JSON Schema ou alterar uma limitação, você modifica o adaptador e preserva o restante da aplicação.
Quanto mais portabilidade importar, mais vale preferir schemas simples: objetos explícitos, tipos claros, enums estáveis, poucos níveis de aninhamento e uma estratégia consistente para valores ausentes.
Campo ausente, recusa e “não sei” precisam ser desenhados
Schemas estritos criam uma consequência que nem sempre é óbvia: se o formato exige uma resposta, o modelo tentará preencher o formato.
A própria OpenAI alerta que, quando a entrada do usuário não permite produzir uma resposta válida para o schema, o modelo pode acabar alucinando um valor para conseguir satisfazer a estrutura. A solução não é abandonar o schema; é desenhar o contrato para representar ausência de informação.
Se um telefone pode não existir, use null como possibilidade. Se uma classificação pode ser indeterminada, considere um valor explícito como “indeterminado”, desde que ele tenha significado real no domínio. Se a tarefa pode falhar por falta de evidência, represente esse estado em um campo próprio em vez de obrigar o modelo a escolher uma resposta que parece completa.
Recusas de segurança são outro caso. Elas não devem ser misturadas com “dado ausente”. OpenAI e Claude expõem sinais próprios de recusa que podem substituir a saída estruturada normal. A aplicação deve detectar esse estado antes de tentar consumir o objeto de negócio.
O mesmo vale para respostas truncadas, erros de rede e limites da API. Um parser não é um sistema de tratamento de falhas.
Enums corrigem o vocabulário, não a decisão
Enums são uma das maiores vantagens práticas de Structured Outputs porque removem variações que costumam quebrar automações.
Sem schema, uma classificação de prioridade pode vir como “alta”, “urgente”, “high”, “P1” ou “crítica”. Com enum, você força o contrato a um conjunto de valores que o código conhece. Isso simplifica banco de dados, métricas, filtros e regras condicionais.
Mas enum não é verificador de verdade. Se os valores permitidos forem “aprovado” e “reprovado”, o schema garante que a resposta use um deles; não garante que a decisão esteja correta. Por isso, tarefas de classificação ainda precisam de exemplos, definições de classe, testes e, quando o risco exigir, revisão ou regras determinísticas.
No Claude, há ainda a ressalva documentada sobre capitalização de alguns valores de enum. Em integração multi-provedor, normalizar caixa no lado da aplicação e evitar categorias que só se distinguem por maiúsculas e minúsculas reduz surpresas.
Validação posterior continua obrigatória
Structured Outputs reduz bastante o trabalho de validação estrutural, mas uma aplicação de produção ainda precisa validar em camadas.
Primeiro: confirme o estado da resposta
Antes de analisar o payload, verifique se a chamada terminou normalmente. Recusa, truncamento, bloqueio, timeout e erro de transporte precisam seguir um fluxo de erro, não o mesmo caminho do dado válido.
Segundo: valide o contrato local
Mesmo quando o provedor promete conformidade, validar o objeto com a mesma biblioteca que define seus tipos ajuda a proteger contra mudanças de SDK, diferenças de integração e schemas transformados. Pydantic, Zod e equivalentes cumprem bem esse papel.
Terceiro: valide a semântica
É aqui que entram regras que JSON Schema não consegue decidir sozinho. Uma data precisa estar no período permitido? Um identificador precisa existir no banco? A soma precisa fechar? Uma categoria escolhida pelo modelo é compatível com o texto de origem? Essas verificações continuam sendo responsabilidade da aplicação.
Essa distinção também aparece em pesquisas sobre geração estruturada. O JSONSchemaBench, apresentado em 2025, reuniu cerca de 10 mil schemas reais e comparou diferentes mecanismos de constrained decoding, incluindo OpenAI e Gemini. O trabalho encontrou diferenças de cobertura, eficiência e comportamento entre implementações. A lição prática não é que schema “não funciona”, e sim que conformidade estrutural precisa ser testada no ambiente e no conjunto de schemas que você realmente usa.
Quando basta escrever “responda em JSON”
A instrução textual é suficiente quando o JSON é apenas uma conveniência de apresentação, a resposta será revisada por uma pessoa ou o consumidor tolera variações de estrutura.
Ela também pode ser aceitável em protótipos rápidos, em tarefas sem automação posterior ou quando você ainda está descobrindo quais campos realmente deveriam existir. Nesse estágio, um contrato rígido pode congelar cedo demais uma estrutura ruim.
O custo dessa flexibilidade é claro: se o conteúdo entrar em código, você terá de assumir que qualquer parte do formato pode variar.
Quando usar JSON livre ou um modo JSON
Um modo que garante JSON válido é útil quando o primeiro requisito é eliminar falhas de parsing, mas a estrutura ainda é aberta ou legada.
Na OpenAI, JSON mode continua existindo justamente como essa camada mais básica. Ele pode fazer sentido quando Structured Outputs não está disponível no modelo ou integração escolhida, ou quando você quer apenas garantir um objeto analisável e pretende validar o shape depois.
Para aplicações novas que já conhecem o contrato, essa camada intermediária costuma trazer menos valor: você continua escrevendo prompt de formato e mantendo validação de schema do lado de fora.
Quando usar JSON Schema
Use schema imposto pela API quando o resultado for consumido automaticamente e a forma do objeto fizer parte do contrato da aplicação.
Isso é especialmente importante em extração de dados, classificação com enums, preenchimento de formulários, geração de registros, composição de interfaces e qualquer fluxo em que uma chave errada gere erro de execução ou dado corrompido.
O schema também ajuda a reduzir prompt engineering acidental. Em vez de gastar várias linhas repetindo “não acrescente campos”, “use exatamente estes nomes” e “não coloque texto fora do JSON”, você transfere parte desse controle para um mecanismo feito para restringir a saída.
Ainda assim, mantenha instruções sobre a tarefa. O schema diz como a resposta deve ser representada; o prompt continua dizendo o que o modelo deve entender e decidir.
Quando a ferramenta é o contrato certo
Se o objetivo não é devolver dados ao usuário, mas executar uma ação, function calling ou tool use costuma ser a interface mais adequada.
OpenAI e Claude diferenciam explicitamente saída estruturada da resposta e chamadas de ferramenta com parâmetros tipados. O Gemini também trata structured outputs e function calling como casos de uso distintos. O padrão arquitetural é útil: resposta estruturada para representar informação; tool calling para pedir que o sistema faça algo.
Misturar os dois papéis costuma gerar APIs confusas. Um objeto chamado “ação” na resposta final não executa nada por si só. Uma tool call, por outro lado, faz parte de um loop em que a aplicação decide se executa, valida argumentos, retorna resultado e continua a conversa.
Um desenho robusto para OpenAI, Claude e Gemini
Comece pelo tipo de dado da sua aplicação, não pela sintaxe de uma API específica. Defina campos, enums, nulabilidade e regras de negócio no seu domínio. Depois gere ou adapte o schema para cada provedor.
Trate o schema como interface, não como substituto do prompt. Use descrições de propriedades para reduzir ambiguidade, escreva instruções claras sobre extração ou classificação e inclua exemplos apenas quando eles ajudam a decidir o conteúdo.
Separe estados de negócio de estados de execução. “Telefone ausente” pertence ao payload. “Modelo recusou”, “resposta truncou” ou “API falhou” pertencem ao controle da chamada.
Valide localmente antes de persistir ou executar. Se o objeto aciona uma transação, uma alteração de conta ou qualquer operação irreversível, acrescente regras determinísticas e autorizações fora do modelo.
E teste o mesmo conjunto de entradas nos provedores que você pretende suportar. Um schema aceito por um não é prova de que outro aceitará as mesmas palavras-chave, profundidade ou combinação de constraints.
A escolha certa depende do consumidor, não do formato bonito
“Responda em JSON” é uma instrução. JSON mode é uma garantia de sintaxe. Structured Outputs é um contrato estrutural mais forte. A diferença só fica clara quando você olha para quem vai consumir a resposta.
Se o consumidor é uma pessoa, flexibilidade pode ser uma vantagem. Se é código, previsibilidade passa a valer mais. Se a saída aciona regras de negócio, nem um JSON perfeito basta sem validação semântica.
Em produção, a meta não é receber um objeto que parece organizado. É receber um dado que o parser entende, o contrato aceita e o sistema sabe quando deve rejeitar.