Quando um agente chama a ferramenta errada, é tentador mexer apenas no prompt do sistema. Muitas vezes, porém, o problema está na própria interface que você apresentou ao modelo. Se duas tools parecem fazer a mesma coisa, se o nome é genérico, se a descrição não explica a fronteira de uso ou se o schema aceita estados ambíguos, o agente está tentando rotear uma intenção sobre uma superfície mal definida.
Tool calling funciona melhor quando a definição da ferramenta serve ao mesmo tempo como contrato de software e como sinal de roteamento. O modelo precisa decidir se deve chamar uma tool, qual delas usar e com quais argumentos. Essas três decisões podem falhar separadamente. Corrigir apenas a validade do JSON não resolve uma seleção errada, e escrever uma descrição perfeita não compensa um schema que permite combinações inválidas.
O erro acontece antes da execução
Há pelo menos dois tipos de falha que costumam aparecer juntos. O primeiro é erro de seleção: o agente escolhe uma ferramenta que não corresponde à intenção do usuário. O segundo é erro de parametrização: a ferramenta escolhida é a correta, mas os argumentos chegam incompletos, com tipo errado, valor fora do domínio ou combinação sem sentido.
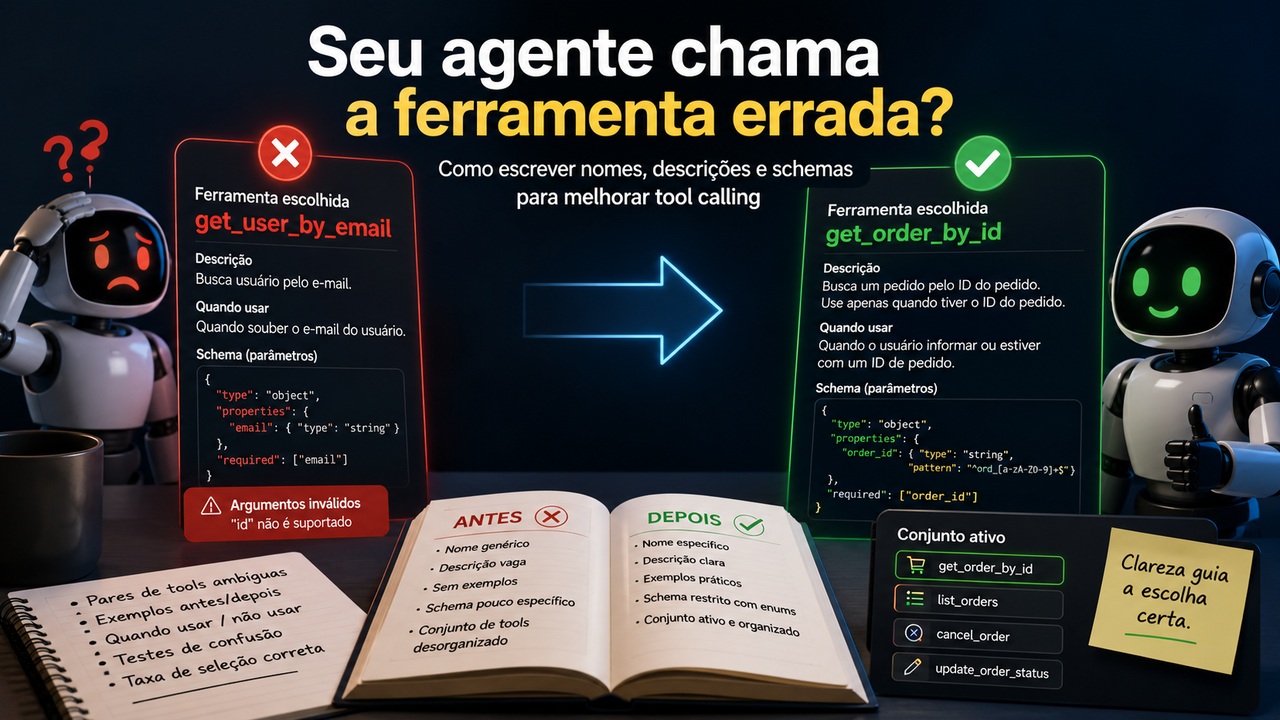
Essa separação muda o diagnóstico. Se o agente chama get_user_by_email quando deveria chamar get_order_by_id, apertar o schema de order_id não corrige a raiz do problema. A definição das duas tools precisa tornar a fronteira semântica explícita. Se o agente escolhe get_order_by_id, mas envia um campo id genérico que a API não aceita, aí o schema e a validação ganham prioridade.
Comece pelo nome: descreva ação e objeto
Nomes curtos demais economizam poucos tokens e cobram caro em ambiguidade. search, lookup, fetch e get são verbos úteis, mas quase não ajudam quando aparecem repetidos em várias ferramentas. Um nome como search_data obriga o modelo a inferir o domínio; crm_find_customer_by_email já antecipa sistema, objeto, operação e chave de busca.
O mesmo vale para pares próximos. get_user e get_customer podem parecer equivalentes se a descrição não disser que user é uma conta autenticada do produto e customer é um registro comercial do CRM. list_orders e search_orders também podem competir se uma retorna pedidos de um cliente conhecido e a outra faz busca global por filtros.
Uma boa regra prática é perguntar se uma pessoa que nunca viu sua aplicação conseguiria escolher entre duas tools lendo apenas nome, descrição e parâmetros. Se a resposta exigir conhecimento tácito da equipe, esse conhecimento precisa entrar na definição.
A descrição é parte do roteador
A documentação atual dos principais provedores converge em um ponto: descrição clara e específica não é decoração. Ela informa o que a ferramenta faz, quando deve ser usada e como seus parâmetros devem ser interpretados. A Anthropic vai além e recomenda descrições muito detalhadas, incluindo quando usar, quando não usar, significado dos parâmetros e limitações relevantes. A OpenAI também orienta explicitar propósito, formato dos parâmetros, saída esperada, exemplos e casos de borda quando eles ajudam a corrigir falhas recorrentes.
A diferença entre uma descrição fraca e uma boa definição costuma estar na fronteira. “Busca um pedido” diz a capacidade. “Busca um pedido pelo identificador único já conhecido; não use para localizar pedidos por e-mail, data ou nome do cliente” diz capacidade e exclusão. É essa segunda parte que reduz competição com tools vizinhas.
Escreva o quando usar e o quando não usar
Para ferramentas concorrentes, inclua na descrição os sinais positivos e negativos. Uma tool para buscar usuário por e-mail pode dizer que deve ser usada somente quando o e-mail do usuário estiver disponível. A tool para pedido por ID pode dizer que exige um identificador de pedido e não serve para descobrir esse ID. Se a intenção do usuário é “qual foi minha última compra?”, nenhuma das duas deveria fingir que consegue responder sem antes localizar o cliente e listar os pedidos.
Esse detalhe também evita o padrão em que o modelo escolhe a ferramenta “mais parecida pelo nome” e improvisa parâmetros para fazê-la caber. Quanto mais claramente a definição admite que uma tool não resolve certos casos, mais fácil fica encaminhar a solicitação para a alternativa correta ou pedir informação faltante.
O schema não escolhe a tool sozinho, mas elimina chamadas inválidas
Depois que a fronteira semântica está clara, o schema precisa transformar intenção em argumentos sem abrir espaço desnecessário. Tipos específicos, campos required, enums e objetos bem estruturados reduzem combinações que o runtime teria de rejeitar depois.
Considere uma atualização de status de pedido. Um campo status como string livre aceita shipped, shipped!, enviado, send e qualquer outro texto. Um enum limitado a pending, paid, shipped e cancelled comunica o domínio e torna estados fora do contrato irrepresentáveis. O mesmo raciocínio vale para unidades, canais, modos de busca, tipos de identificador e ações possíveis.
Na OpenAI, o modo strict é recomendado para aderência confiável ao schema. Nesse modo, objetos precisam bloquear propriedades adicionais e os campos declarados nas propriedades precisam estar marcados como obrigatórios; um campo opcional pode ser modelado aceitando null. Isso melhora conformidade estrutural, mas não garante que o modelo escolheu a ferramenta certa nem que um valor semanticamente incorreto ficou correto só porque passou no tipo.
Torne estados inválidos difíceis de representar
Schemas permissivos transferem decisão para o modelo. Imagine toggle_light com dois booleanos, on e off. A combinação on=true e off=true é sintaticamente possível e semanticamente absurda.
Um único campo action com enum on e off remove o estado inválido. Esse princípio de engenharia é especialmente útil em tool calling porque cada grau de liberdade extra vira mais uma chance de o modelo produzir uma chamada aceitável pelo parser e errada para o negócio.
Quando duas tools competem, talvez elas devam virar uma
Nem toda ambiguidade se resolve com descrições maiores. Às vezes a superfície de ferramentas está fragmentada demais. Se create_pr, review_pr e merge_pr compartilham o mesmo recurso, autenticação e contexto, pode fazer sentido consolidar operações em uma ferramenta com um parâmetro action bem restrito. A Anthropic recomenda esse tipo de consolidação para reduzir ambiguidade de seleção em conjuntos de tools.
Mas consolidar tudo também tem custo. Operações com permissões muito diferentes, efeitos irreversíveis ou pré-condições distintas podem merecer ferramentas separadas para que o runtime aplique políticas específicas. O critério não é “menos tools a qualquer preço”; é “menos sobreposição semântica”. Se duas ferramentas têm a mesma frase de descrição mudando apenas um substantivo, vale revisar o desenho.
Menos ferramentas ativas, menos confusão
Mesmo definitions excelentes perdem clareza quando o modelo recebe um catálogo enorme de opções parecidas. A OpenAI recomenda manter pequeno o conjunto inicialmente disponível e sugere avaliar diferentes quantidades, com menos de vinte funções no início de um turno como referência flexível. O Google recomenda manter o conjunto ativo em torno de 10 a 20 tools. Quando o catálogo é maior, mecanismos de busca, carregamento adiado ou restrição por etapa podem expor apenas o subconjunto relevante.
Isso é especialmente importante em agentes com fases claras. Na etapa de autenticação, não há motivo para deixar uma ferramenta de reembolso competir com ferramentas de identificação. Depois que o pedido foi localizado, a aplicação pode habilitar tools de consulta, cancelamento ou atualização daquele contexto. A própria camada de orquestração pode fazer parte do roteamento em vez de delegar toda a taxonomia ao modelo em um único turno.
Na OpenAI, por exemplo, tool_choice e allowed_tools permitem restringir o conjunto que o modelo pode chamar em determinado momento. O ganho não vem apenas de “obedecer mais”; vem de remover candidatos que não deveriam participar daquela decisão.
Um antes e depois de definição ambígua
Imagine uma tool chamada search com descrição “Pesquisa dados do cliente” e parâmetros query:string e type:string. Ela parece flexível, mas o modelo precisa adivinhar o que significa type, quais valores são válidos, quando usar a busca e o que volta. Se existe ao lado outra tool chamada lookup, a competição fica quase arbitrária.
A versão mais previsível poderia se chamar crm_find_customer_by_email. A descrição explicaria que ela procura exatamente um registro de cliente pelo e-mail normalizado, que deve ser usada somente quando o e-mail estiver disponível, que não pesquisa pedidos e que retorna o customer_id necessário para etapas seguintes. O schema teria email:string com formato esperado e nenhum campo genérico de modo.
Para pedidos, outra tool poderia ser orders_get_by_id, exigindo order_id e dizendo explicitamente que não descobre pedidos por cliente. Se o usuário não forneceu order_id, a descrição aponta para a necessidade de outra etapa. O modelo deixa de escolher entre “search” e “lookup” e passa a escolher entre operações com fronteiras compreensíveis.
Exemplos ajudam quando corrigem um padrão real
Exemplos de chamadas são úteis quando a estrutura é aninhada, os formatos são sensíveis ou existe uma confusão que se repete. A Anthropic oferece input_examples como parte opcional da definição de tool. A OpenAI também sugere exemplos e casos de borda para falhas recorrentes, com a ressalva de que exemplos adicionais podem não ajudar todos os modelos de raciocínio da mesma forma.
O ponto é usar exemplos como teste de fronteira, não como catálogo infinito. Se uma tool de busca aceita date_range, um exemplo pode mostrar o formato correto. Se duas tools são confundidas, exemplos contrastantes podem mostrar uma solicitação que deve chamar cada uma e uma terceira que não deve chamar nenhuma. O efeito precisa ser medido, porque um exemplo muito específico também pode induzir overfitting comportamental.
Valide a chamada antes de executar
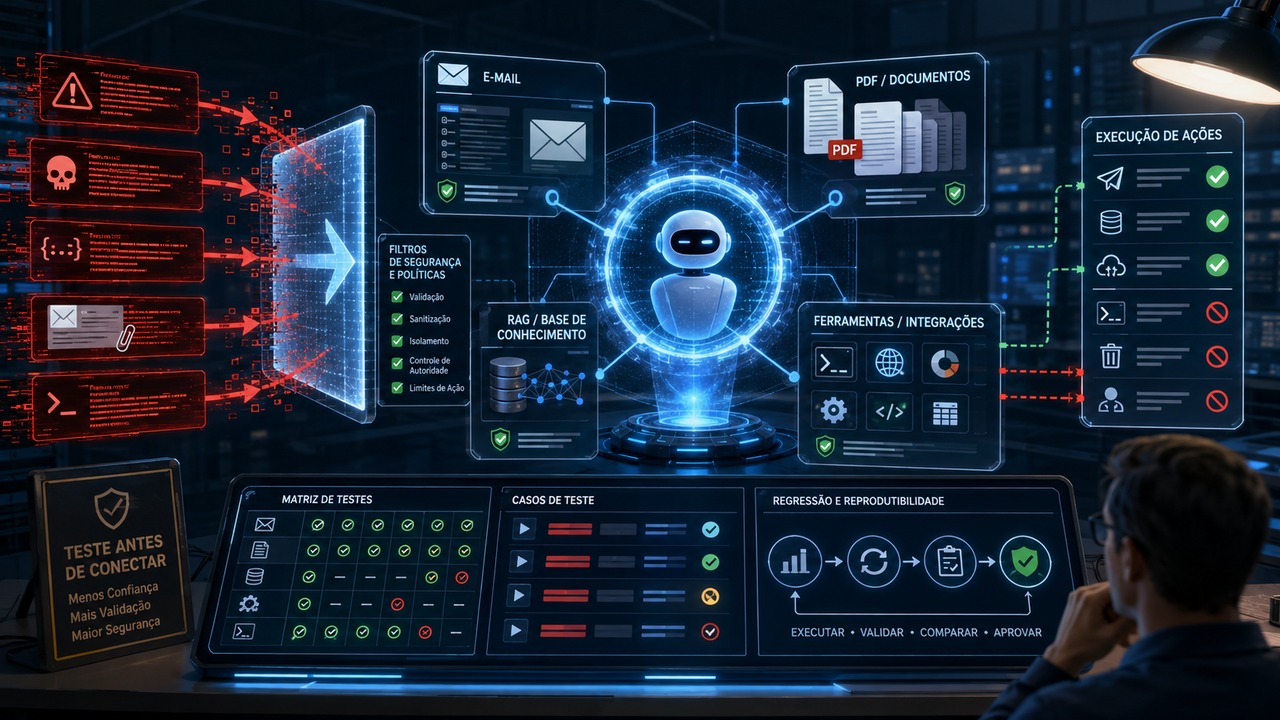
Mesmo um schema bem definido não substitui validação no runtime. O Google recomenda validar function calls antes da execução. Na prática, isso significa conferir tipos, enums, identificadores, permissões, escopo do usuário e pré-condições de negócio antes de tocar um sistema externo.
Essa camada é indispensável para operações com efeito colateral. Um order_id com formato válido pode pertencer a outro cliente. Um status allowed pelo schema pode não ser permitido na fase atual do pedido. Um endereço de e-mail válido pode ser um destinatário que o usuário não autorizou. Tool calling deve produzir uma intenção estruturada; a autorização final continua sendo responsabilidade do código.
Teste tool calling como um problema de roteamento
Avaliar apenas se a tarefa final “deu certo” esconde onde a falha aconteceu. Um conjunto de testes melhor registra, para cada prompt, qual tool era esperada, quais seriam alternativas aceitáveis, se nenhuma ferramenta deveria ser chamada e quais argumentos são obrigatórios. A partir daí, você consegue separar seleção, estrutura e execução.
Uma matriz de confusão é especialmente útil para pares ambíguos. Coloque get_user_by_email e get_order_by_id como classes e rode solicitações que variam apenas o sinal decisivo: e-mail presente, order_id presente, ambos presentes, nenhum presente, referência indireta a “meu último pedido” e pedido para atualizar um registro. Se a maior parte dos erros migra sempre da primeira para a segunda tool, a definição de uma delas provavelmente está capturando linguagem ampla demais.
A taxa de seleção correta é uma métrica direta, mas não deve ficar sozinha. Meça também validade do schema, argumentos semanticamente corretos, chamadas desnecessárias, chamadas omitidas, repetição da mesma tool, latência e custo. Um agente que acerta 98% da ferramenta mas cria duas chamadas extras por tarefa pode estar pior para produção do que outro com a mesma precisão e fluxo mais disciplinado.
Pesquisas de 2026 reforçam que o catálogo importa
Trabalhos recentes ajudam a explicar por que esse cuidado não é apenas estética de API. O benchmark ToolMATH foi desenhado justamente para avaliar ambientes com catálogos grandes e ferramentas sobrepostas. Os autores observaram que redundância não funciona apenas como ruído: candidatos semelhantes podem amplificar pequenos desvios iniciais e empurrar o agente para trajetórias erradas em tarefas de vários passos.
Outro trabalho de 2026, To Call or Not to Call, mostra que a decisão de usar uma ferramenta também pode ser subótima mesmo quando tool use melhora resultados em média. O estudo separa necessidade, utilidade e custo da chamada e mostra que modelos podem chamar ferramentas quando não precisavam ou deixar de capturar o ganho disponível. Para engenharia de
agentes, a leitura prática é clara: não basta verificar se a tool existe e funciona. É preciso medir se ela foi escolhida no momento certo e se valia a pena chamá-la.
O que é portátil entre OpenAI, Claude e Gemini
Os detalhes de API mudam, mas a maior parte da engenharia é portátil. OpenAI, Anthropic e Google tratam nome, descrição e schema como parte central da interface de function calling. Os três valorizam nomes descritivos, parâmetros específicos e contexto suficiente para a escolha.
As diferenças aparecem nos controles. A OpenAI oferece strict para aderência ao schema e mecanismos para limitar tools permitidas. A Anthropic enfatiza descrições extensas, input_examples, namespacing e consolidação de operações relacionadas. O Gemini recomenda descrições claras, nomes descritivos, tipagem forte com enums, conjunto ativo limitado e validação antes da execução. Em todos os casos, o princípio mais importante é não depender de uma frase vaga no prompt para corrigir uma API ambígua.
Um diagnóstico prático para a próxima falha
Quando o agente chamar a ferramenta errada, preserve o caso como teste. Primeiro confirme se havia mais de uma tool plausível pela definição. Depois compare nomes e descrições procurando sobreposição de verbo, objeto e condição de uso. Em seguida, verifique se o schema contém campos genéricos que empurram decisões para strings livres ou booleanos contraditórios. Por fim, reduza o conjunto ativo e rode novamente o mesmo caso junto com exemplos vizinhos.
Se a seleção melhorar apenas quando a tool concorrente é removida, o problema é de fronteira. Se a tool correta é escolhida, mas os argumentos continuam ruins, aperte tipos, enums, required e validação. Se o agente insiste em chamar uma ferramenta mesmo quando nenhuma é necessária, inclua casos de “não chamar” na avaliação e revise as instruções de roteamento. O objetivo é transformar uma falha anedótica em um teste reproduzível.
Clareza de interface vence remendo de prompt
Tool calling confiável nasce de uma superfície de ações que faz sentido antes mesmo de o modelo entrar em cena. Nomes dizem o que é a operação. Descrições delimitam quando ela se aplica e quando não se aplica. Schemas eliminam estados inválidos. O runtime valida o que o schema não consegue garantir. E os testes mostram onde duas tools ainda competem.
Quando esses elementos estão bem desenhados, o prompt do agente deixa de carregar sozinho a responsabilidade de “adivinhar a ferramenta certa”. O modelo recebe opções mais distintas, produz argumentos mais verificáveis e a equipe consegue medir seleção correta em vez de esperar que uma demonstração feliz represente o comportamento em produção.