Cuando un agente llama a la herramienta equivocada, es tentador simplemente alterar el indicador del sistema. Sin embargo, a menudo el problema radica en la interfaz que presentó al modelo mismo. Si dos herramientas parecen hacer lo mismo, si el nombre es genérico, si la descripción no explica el límite de uso o si el esquema acepta estados ambiguos, el agente está intentando encaminar una intención sobre una superficie mal definida.
La llamada a herramientas funciona mejor cuando la definición de la herramienta sirve como contrato de software y señal de enrutamiento. El modelo necesita decidir si llamar a una herramienta, cuál usar y con qué argumentos. Estas tres decisiones pueden fracasar por separado. Simplemente corregir la validez de JSON no resuelve una mala selección y escribir una descripción perfecta no compensa un esquema que permite combinaciones no válidas.
El error ocurre antes de la ejecución
Existen al menos dos tipos de fallos que suelen aparecer juntos. El primero es el error de selección: el agente elige una herramienta que no corresponde a la intención del usuario. El segundo es un error de parametrización: la herramienta elegida es la correcta, pero los argumentos llegan incompletos, con el tipo incorrecto, un valor fuera del dominio o una combinación sin sentido.
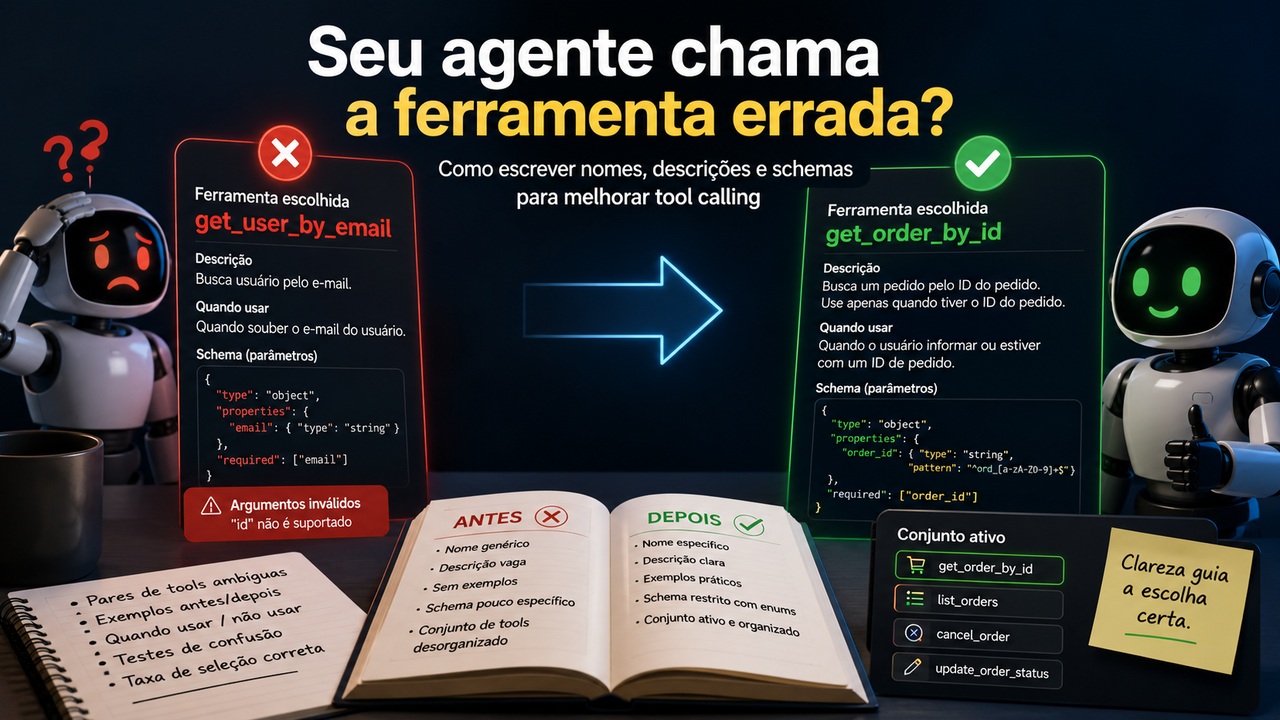
Esta separación cambia el diagnóstico. Si el agente llama a get_user_by_email cuando debería llamar a get_order_by_id, ajustar el esquema order_id no soluciona la causa raíz del problema. La definición de las dos herramientas debe hacer explícito el límite semántico. Si el agente elige get_order_by_id, pero envía un campo de identificación genérico que la API no acepta, entonces el esquema y la validación tienen prioridad.
Comience con el nombre: describa la acción y el objeto
Los nombres demasiado cortos ahorran pocos tokens y cuestan mucho en ambigüedad. buscar, buscar, recuperar y obtener son verbos útiles, pero apenas ayudan cuando aparecen repetidos en varias herramientas. Un nombre como search_data obliga al modelo a inferir el dominio; crm_find_customer_by_email ya anticipa el sistema, el objeto, la operación y la clave de búsqueda.
Lo mismo ocurre con las parejas cercanas. get_user y get_customer pueden parecer equivalentes si la descripción no dice que el usuario es una cuenta de producto autenticada y el cliente es un registro comercial de CRM. list_orders y search_orders también pueden competir si uno devuelve pedidos de un cliente conocido y el otro realiza una búsqueda de filtro global.
Una buena regla general es preguntar si una persona que nunca haya visto su aplicación podría elegir entre dos herramientas leyendo solo el nombre, la descripción y los parámetros. Si la respuesta requiere conocimiento tácito por parte del equipo, ese conocimiento debe incluirse en la definición.
La descripción es parte del enrutador
La documentación actual de los principales proveedores converge en un punto: una descripción clara y específica no es decoración. Le indica qué hace la herramienta, cuándo debe usarse y cómo deben interpretarse sus parámetros. Anthropic va más allá y recomienda descripciones muy detalladas, que incluyen cuándo usar, cuándo no usar, significado de los parámetros y limitaciones relevantes. OpenAI también recomienda explicar el propósito, el formato de los parámetros, el resultado esperado, los ejemplos y los casos extremos cuando ayudan a solucionar fallos recurrentes.
La diferencia entre una descripción débil y una buena definición suele ser dudosa. "Buscar un pedido", dice la capacidad. "Busque un pedido por su identificador único ya conocido; no lo utilice para buscar pedidos por correo electrónico, fecha o nombre del cliente", dice capacidad y exclusión. Es esta segunda parte la que reduce la competencia con las herramientas vecinas.
Anota cuándo usarlo y cuándo no usarlo
Para herramientas de la competencia, incluya signos positivos y negativos en la descripción. Una herramienta para buscar usuarios por correo electrónico puede decir que solo debe usarse cuando el correo electrónico del usuario esté disponible. La herramienta para realizar pedidos por ID puede indicar que requiere un identificador de pedido y no se utiliza para descubrir este ID. Si la intención del usuario es “¿cuál fue mi última compra?”, ninguno debe pretender poder responder sin antes localizar al cliente y enumerar los pedidos.
Este detalle también evita el patrón en el que el modelo elige la herramienta "más similar por nombre" e improvisa parámetros para que encaje. Cuanto más claramente admita la definición que una herramienta no resuelve determinados casos, más fácil será reenviar la solicitud a la alternativa correcta o solicitar la información faltante.
El esquema no elige la herramienta en sí, pero elimina las llamadas no válidas
Una vez que el límite semántico está claro, el esquema necesita transformar la intención en argumentos sin abrir espacios innecesarios. Los tipos específicos, los campos obligatorios, las enumeraciones y los objetos bien estructurados reducen las combinaciones que el tiempo de ejecución tendría que rechazar más adelante.
Considere una actualización del estado del pedido. Un campo de estado como cadena libre acepta enviado, enviado!, enviado, envío y cualquier otro texto. Una enumeración limitada a pendiente, pagado, enviado y cancelado comunica el dominio y hace que los estados fuera del contrato no sean representables. El mismo razonamiento se aplica a unidades, canales, modos de búsqueda, tipos de identificadores y posibles acciones.
En OpenAI, se recomienda el modo estricto para un cumplimiento confiable del esquema. En este modo, los objetos deben bloquear propiedades adicionales y los campos declarados en propiedades deben marcarse como obligatorios; un campo opcional se puede modelar para aceptar nulo. Esto mejora el cumplimiento estructural, pero no garantiza que el modelo haya elegido la herramienta adecuada o que un valor semánticamente incorrecto sea correcto simplemente porque pasó el tipo.
Hacer que los estados no válidos sean difíciles de representar
Los esquemas permisivos transfieren decisiones al modelo. Imagine toggle_light con dos valores booleanos, activado y desactivado. La combinación on=true y off=true es sintácticamente posible y semánticamente absurda.
Un campo de acción única con enumeración activada y desactivada elimina el estado no válido. Este principio de ingeniería es especialmente útil en la llamada de herramientas porque cada grado adicional de libertad se convierte en otra oportunidad para que el modelo produzca una llamada que sea aceptable para el analizador e incorrecta para el negocio.
Cuando dos herramientas compiten, tal vez deberían convertirse en una
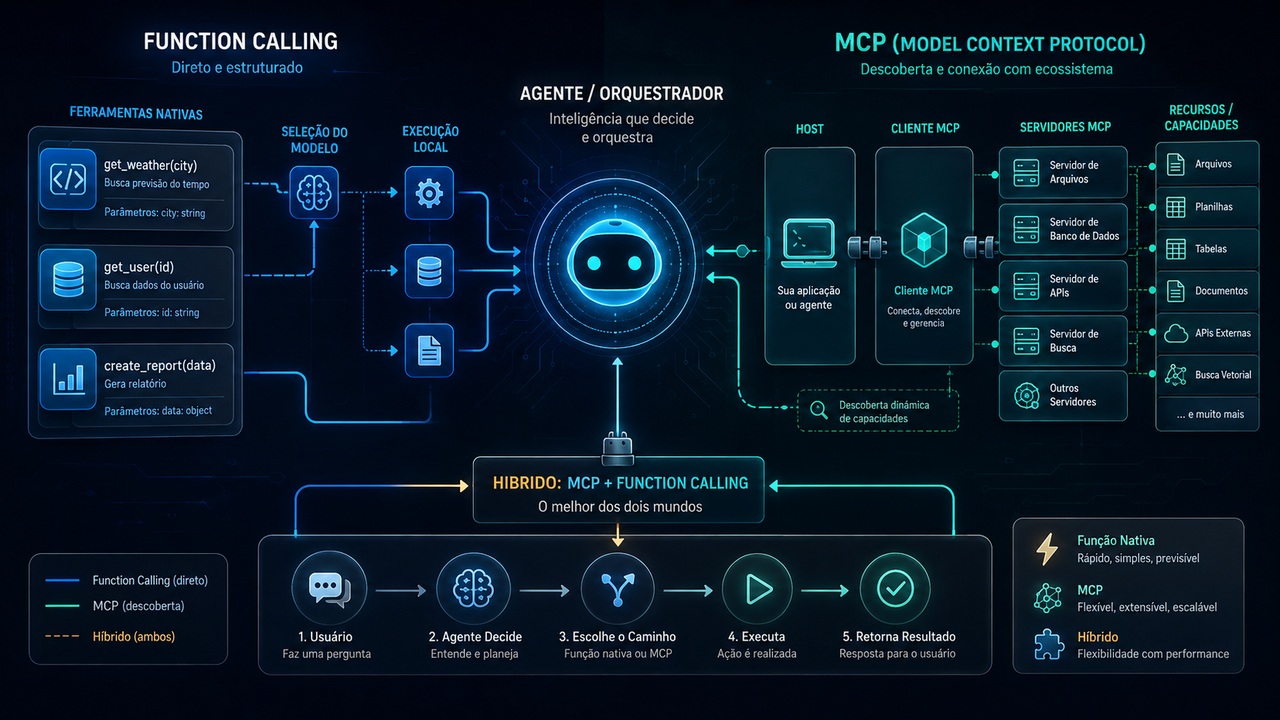
No todas las ambigüedades se pueden resolver con descripciones más amplias. A veces la superficie de la herramienta está demasiado fragmentada. Si create_pr, review_pr y merge_pr comparten el mismo recurso, autenticación y contexto, podría tener sentido consolidar operaciones en una herramienta con un parámetro de acción muy restringido. Anthropic recomienda este tipo de consolidación para reducir la ambigüedad de selección en los conjuntos de herramientas.
Pero consolidarlo todo también tiene un coste. Las operaciones con permisos muy diferentes, efectos irreversibles o condiciones previas diferentes pueden requerir herramientas independientes para que el tiempo de ejecución aplique políticas específicas. El criterio no es “menos herramientas a cualquier precio”; es "menos superposición semántica". Si dos herramientas tienen la misma frase descriptiva, cambiando solo un sustantivo, vale la pena revisar el diseño.
Menos herramientas activas, menos desorden
Incluso las definiciones excelentes pierden claridad cuando el modelo recibe un catálogo enorme de opciones similares. OpenAI recomienda mantener pequeño el grupo inicialmente disponible y sugiere evaluar diferentes cantidades, con menos de veinte funciones al comienzo de un turno como punto de referencia flexible. Google recomienda mantener el conjunto activo entre 10 y 20 herramientas. Cuando el catálogo es más grande, los motores de búsqueda, la carga diferida o la restricción gradual pueden exponer solo el subconjunto relevante.
Esto es especialmente importante en agentes con fases claras. En la etapa de autenticación, no hay razón para permitir que una herramienta de reembolso compita con las herramientas de identificación. Una vez localizada la solicitud, la aplicación puede habilitar herramientas de consulta, cancelación o actualización para ese contexto. La propia capa de orquestación puede hacer parte del enrutamiento en lugar de delegar toda la taxonomía al modelo en un solo turno.
En OpenAI, por ejemplo, tool_choice y autorizado_tools le permiten restringir el conjunto al que el modelo puede llamar en un momento dado. La ganancia no proviene sólo de “obedecer más”; proviene de eliminar candidatos que no deberían participar en esa decisión.
Un antes y un después de una definición ambigua
Imagine una herramienta llamada búsqueda con la descripción "Buscar datos de clientes" y los parámetros consulta:cadena y tipo:cadena. Parece flexible, pero el modelo tiene que adivinar qué significa tipo, qué valores son válidos, cuándo usar la búsqueda y qué devuelve. Si hay otra herramienta llamada búsqueda al lado, la competencia se vuelve casi arbitraria.
La versión más predecible podría llamarse crm_find_customer_by_email. La descripción explicaría que busca exactamente un registro de cliente usando el correo electrónico estándar, que solo debe usarse cuando el correo electrónico esté disponible, que no busca pedidos y que devuelve el customer_id necesario para los pasos posteriores. El esquema tendría email:string con el formato esperado y sin campo de modo genérico.
Para pedidos, otra herramienta podría ser pedidos_get_by_id, que requiere order_id y dice explícitamente que no descubre pedidos por cliente. Si el usuario no proporcionó order_id, la descripción indica la necesidad de realizar otro paso. El modelo deja de elegir entre "búsqueda" y "búsqueda" y comienza a elegir entre operaciones con límites comprensibles.
Los ejemplos ayudan a la hora de corregir un patrón real
Las llamadas de ejemplo son útiles cuando la estructura está anidada, los formatos son sensibles o hay un desorden repetitivo. Anthropic ofrece input_examples como parte opcional de la definición de la herramienta. OpenAI también sugiere ejemplos y casos extremos para fallas recurrentes, con la advertencia de que los ejemplos adicionales pueden no ayudar a todos los modelos de razonamiento por igual.
El punto es utilizar ejemplos como una prueba de límites, no como un catálogo infinito. Si un motor de búsqueda acepta date_range, un ejemplo puede mostrar el formato correcto. Si se confunden dos herramientas, los ejemplos contrastantes pueden mostrar una solicitud que debería llamar a cada una y una tercera que no debería llamar a ninguna. Es necesario medir el efecto, porque un ejemplo muy específico también puede inducir un sobreajuste conductual.
Validar la llamada antes de ejecutar
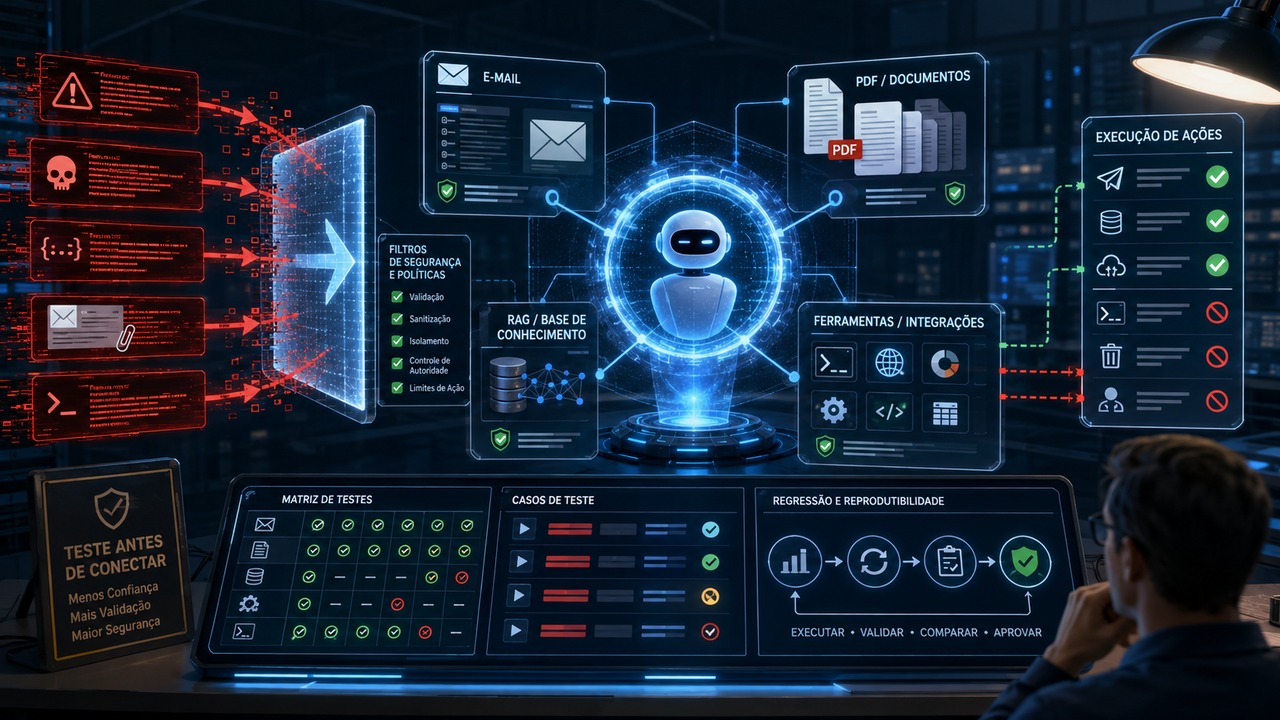
Ni siquiera un esquema bien definido reemplaza la validación en tiempo de ejecución. Google recomienda validar las llamadas a funciones antes de su ejecución. En la práctica, esto significa verificar tipos, enumeraciones, identificadores, permisos, alcance de usuario y condiciones previas comerciales antes de tocar un sistema externo.
Esta capa es esencial para operaciones con efectos secundarios. Un order_id con formato válido puede pertenecer a otro cliente. Es posible que un estado permitido por el esquema no se permita en la fase de solicitud actual. Una dirección de correo electrónico válida puede ser un destinatario que el usuario no ha autorizado. La llamada a herramientas debe producir una intención estructurada; la autorización final sigue siendo responsabilidad del código.
Herramienta de prueba llamando como problema de enrutamiento
Evaluar solo si la tarea final “funcionó” oculta dónde ocurrió la falla. Un mejor conjunto de pruebas registra, para cada mensaje, qué herramienta se esperaba, cuáles serían las alternativas aceptables, si no se debe llamar a ninguna herramienta y qué argumentos se requieren. A partir de ahí, puedes separar la selección, la estructura y la ejecución.
Una matriz de confusión es especialmente útil para pares ambiguos. Ponga get_user_by_email y get_order_by_id como clases y ejecute solicitudes que varíen solo el signo decisivo: correo electrónico presente, order_id presente, ambos presentes, ninguno presente, referencia indirecta a “mi último pedido” y solicitud de actualización de un registro. Si la mayoría de los errores siempre migran de la primera a la segunda herramienta, definir uno de ellos probablemente sea capturar un lenguaje demasiado amplio.
La tasa de selección correcta es una métrica sencilla, pero no debe ser única. Mida también la validez del esquema, argumentos semánticamente correctos, llamadas innecesarias, llamadas omitidas, repetición de la misma herramienta, latencia y costo. Un agente que utiliza correctamente el 98 % de la herramienta pero crea dos llamadas adicionales por tarea puede estar en peor situación para la producción que uno con la misma precisión y un flujo más disciplinado.
La investigación de 2026 refuerza la importancia del catálogo
Un trabajo reciente ayuda a explicar por qué este cuidado no se trata solo de la estética del API. El benchmark ToolMATH fue diseñado precisamente para evaluar entornos con grandes catálogos y herramientas superpuestas. Los autores observaron que la redundancia no sólo funciona como ruido: candidatos similares pueden amplificar pequeñas desviaciones iniciales y empujar al agente hacia trayectorias equivocadas en tareas de varios pasos.
Otro trabajo de 2026, Llamar o no llamar, muestra que la decisión de utilizar una herramienta también puede ser subóptima incluso cuando el uso de la herramienta mejora los resultados en promedio. El estudio separa la necesidad, la utilidad y el costo de la llamada y muestra que los modelos pueden llamar a herramientas cuando no son necesarias o no logran capturar la ganancia disponible. Para ingeniería
agentes, la lectura práctica es clara: no basta con comprobar si la herramienta existe y funciona. Hay que medir si fue elegida en el momento adecuado y si valió la pena llamarla.
Qué es portátil entre OpenAI, Claude y Gemini
Los detalles de la API cambian, pero la mayor parte de la ingeniería es portátil. OpenAI, Anthropic y Google tratan el nombre, la descripción y el esquema como una parte central de la interfaz de llamada de funciones. Los tres valoran nombres descriptivos, parámetros específicos y contexto suficiente para la elección.
Las diferencias aparecen en los controles. OpenAI ofrece un estricto cumplimiento del esquema y mecanismos para limitar las herramientas permitidas. Anthropic enfatiza descripciones largas, ejemplos de entrada, espacios de nombres y consolidación de operaciones relacionadas. Gemini recomienda descripciones claras, nombres descriptivos, escritura segura con enumeraciones, conjunto activo limitado y validación antes de la ejecución. En todos los casos, el principio más importante es no confiar en una frase vaga en el mensaje para corregir una API ambigua.
Un diagnóstico práctico para el próximo fallo
Cuando el agente llame a la herramienta equivocada, conserve el caso como prueba. Primero confirme si había más de una herramienta plausible según la definición. Luego compare nombres y descripciones buscando superposiciones en verbo, objeto y condición de uso. Luego verifique si el esquema contiene campos genéricos que impulsen las decisiones a cadenas libres o valores booleanos contradictorios. Finalmente, reduzca el conjunto activo y ejecute el mismo caso nuevamente con ejemplos vecinos.
Si la selección mejora sólo cuando se elimina la herramienta competidora, el problema es un problema de límites. Si se elige la herramienta correcta, pero los argumentos siguen siendo malos, presione tipos, enumeraciones, requisitos y validación. Si el agente insiste en llamar a una herramienta incluso cuando no es necesaria, incluya los casos de "no llamada" en la evaluación y revise las instrucciones de enrutamiento. El objetivo es convertir un fallo anecdótico en una prueba reproducible.
La claridad de la interfaz supera al parche rápido
La llamada confiable a herramientas nace de una superficie de acciones que tiene sentido incluso antes de que el modelo entre en escena. Los nombres te dicen cuál es la operación. Las descripciones delimitan cuándo se aplica y cuándo no se aplica. Los esquemas eliminan estados no válidos. El tiempo de ejecución valida lo que el esquema no puede garantizar. Y las pruebas muestran dónde todavía compiten dos herramientas.
Cuando estos elementos están bien diseñados, el mensaje del agente ya no tiene la responsabilidad de "adivinar la herramienta adecuada" únicamente. El modelo recibe opciones más distintas, produce argumentos más verificables y el equipo puede medir la selección correcta en lugar de esperar que una demostración feliz represente el comportamiento en producción.