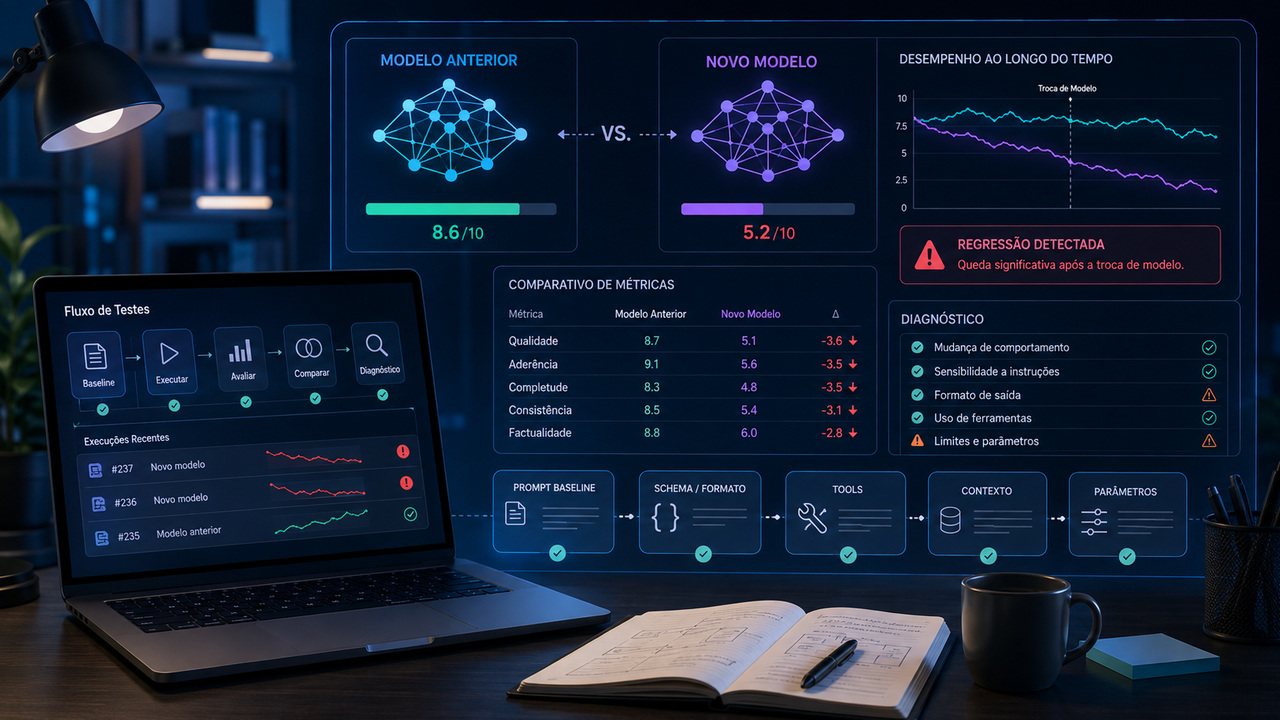
Quando um workflow de IA está estável e piora logo depois de uma troca de modelo, a reação mais comum é abrir o prompt e começar a reescrever. Esse é justamente o momento em que convém preservar o que já funcionava. Se o prompt conhecido permaneceu igual e a variável principal foi o modelo, esse prompt é seu melhor baseline para descobrir o que mudou.
A pergunta útil não é “como consertar o prompt?” logo de saída. É “qual parte do sistema regrediu quando o modelo mudou?”. A resposta pode estar na aderência às instruções, no formato de saída, no uso de ferramentas, na forma como o contexto é processado, nos parâmetros da requisição, no endpoint ou SDK usado na migração, ou simplesmente na variabilidade natural das respostas. Só depois de localizar a falha faz sentido decidir se o prompt realmente precisa ser alterado.
Regressão de prompt nem sempre é um problema de prompt
Modelos diferentes não são versões intercambiáveis de uma mesma função. Eles podem interpretar instruções com graus diferentes de literalidade, calibrar a quantidade de detalhe de outro modo, decidir de forma diferente quando usar uma ferramenta e reagir de maneira distinta ao mesmo contexto. Até versões ou snapshots de uma mesma família podem produzir mudanças observáveis de comportamento.
Esse ponto aparece nas documentações oficiais dos principais provedores. A OpenAI recomenda usar versões fixas quando a consistência importa e manter suítes de avaliação para acompanhar mudanças ao atualizar modelos. A Anthropic mantém guias de migração porque parâmetros, comportamento e versões de ferramentas podem mudar entre gerações. O Google também publica orientação específica de migração e prompting para novas gerações do Gemini, inclusive quando parâmetros e estratégias recomendadas mudam.
Por isso, “o prompt piorou” é apenas uma hipótese. O que você observou foi uma queda no resultado final. Antes de atribuir a causa ao texto do prompt, é preciso separar o que pertence ao prompt do que pertence ao restante do sistema.
Congele o baseline antes de tentar melhorar qualquer coisa
O diagnóstico fica muito mais difícil se você troca o modelo e, ao mesmo tempo, modifica instruções, exemplos, parâmetros, ferramentas e código de integração. Se tudo muda junto, uma melhora não prova que o novo prompt era necessário e uma piora não revela qual alteração causou o problema.
O baseline deve representar a configuração que funcionava. Preserve o texto exato das instruções, a divisão entre mensagens de sistema e usuário, os exemplos, a ordem dos blocos, as definições de ferramentas, o schema de saída, a política de contexto, os parâmetros de geração, os limites de tokens e o fluxo de estado da conversa. Registre também o identificador exato do modelo antigo quando o provedor oferece uma versão fixa.
Em seguida, execute os mesmos casos no modelo novo alterando apenas o identificador do modelo. Se a migração exigir uma mudança obrigatória de API ou parâmetro, trate essa mudança como uma segunda variável e documente-a. O objetivo é chegar o mais perto possível de um teste A/B em que o prompt e o restante do ambiente continuam constantes.
Registre a requisição real, não apenas o texto visível do prompt
Muitos “prompts” em produção são, na prática, sistemas. A requisição pode incluir instruções que o usuário não vê, contexto recuperado de uma base, histórico de conversa, descrições de ferramentas, schema JSON, limites de saída e transformações feitas pelo SDK. Se você comparar apenas o texto principal, pode estar testando duas requisições diferentes sem perceber.
Para cada execução crítica, salve uma representação do input efetivamente enviado ao modelo e uma trilha do que voltou: texto final, chamadas de ferramenta, argumentos, motivo de parada, uso de tokens, erros de validação e qualquer informação de tracing disponível. Esse registro reduz o espaço para diagnósticos por impressão.
Monte uma suíte mínima de regressão antes de mexer no prompt
Você não precisa começar com centenas de casos. Precisa começar com casos que representem o que seu produto realmente exige. O conjunto mínimo deve conter exemplos normais, casos de borda e situações em que a saída precisa obedecer a uma regra objetiva.
Caso normal: o caminho que mais acontece em produção
Escolha uma entrada comum, com contexto suficiente e resposta esperada bem entendida. O objetivo aqui é medir se o novo modelo continua resolvendo a tarefa central com o mesmo nível de utilidade, aderência e completude.
Caso de formato: a saída precisa ser consumida por código
Inclua pelo menos um caso em que a resposta tenha requisitos estruturais claros, como JSON válido, campos obrigatórios, tipos corretos e ausência de texto fora do schema. Quando o provedor oferece Structured Outputs, modo estrito ou mecanismo equivalente, teste esse recurso separadamente do prompt. Pedir “responda em JSON” no texto não é a mesma coisa que ter a estrutura validada pela própria API.
Caso de ferramenta: o modelo precisa decidir quando e como chamar uma função
Registre qual ferramenta deveria ser escolhida, quais argumentos são obrigatórios e o que não deveria ser chamado. Compare não apenas a resposta final, mas a trajetória. Um workflow pode parecer “menos inteligente” porque a chamada de ferramenta mudou, mesmo que o texto posterior esteja bom.
Caso de contexto: a resposta depende de informação longa ou recuperada
Use um exemplo em que a instrução importante esteja distante no contexto ou em que uma base de conhecimento forneça trechos essenciais. Verifique primeiro se os mesmos trechos foram recuperados, na mesma ordem e com o mesmo conteúdo. Se o retrieval mudou, não atribua ao modelo um erro que nasceu antes dele.
Caso de ausência de informação: o modelo deveria admitir limite
Inclua uma entrada em que a resposta correta seja pedir dado adicional, declarar incerteza ou recusar uma conclusão não sustentada. Modelos diferentes podem calibrar confiança e iniciativa de forma diferente. Essa diferença pode ser desejável em um produto e problemática em outro, por isso precisa virar critério explícito.
Caso multi-turno: o comportamento depende do histórico
Se seu workflow usa conversas longas, estado persistente ou respostas encadeadas, teste pelo menos uma sequência real. Mudanças no gerenciamento de estado, no endpoint ou no tamanho efetivo do contexto podem produzir regressões que não aparecem em uma chamada isolada.
Meça primeiro o que pode ser medido de forma determinística
Antes de avaliar “qual resposta parece melhor”, use verificações objetivas onde elas existirem. Para saída estruturada, valide o schema. Para ferramentas, confira nome da função, presença dos argumentos obrigatórios e tipos. Para classificação, compare a classe esperada. Para extração, valide campos e valores críticos. Para limites de tamanho, conte tokens ou caracteres conforme a regra do produto.
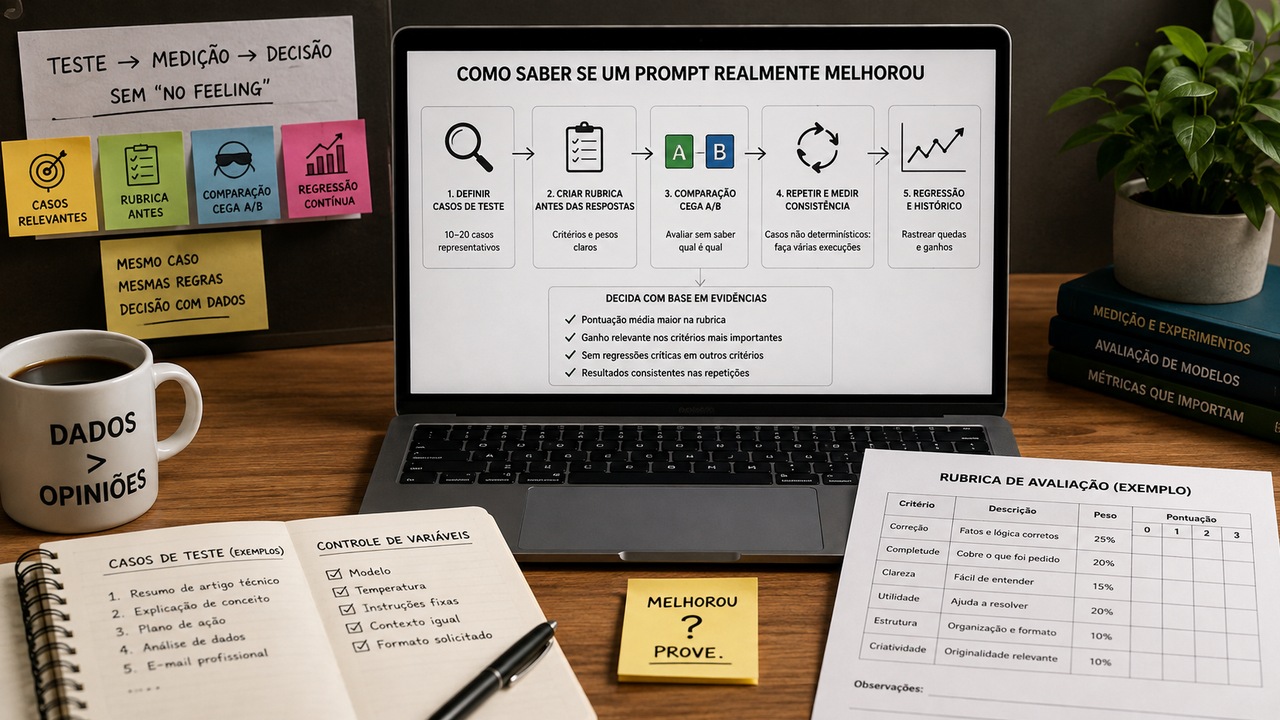
Depois disso, avalie aspectos semânticos como relevância, clareza, completude e tom com uma rubrica estável. Em tarefas importantes, combine automação com revisão humana de uma amostra. Um único julgamento global do tipo “o modelo novo parece pior” é fraco porque mistura várias dimensões em uma nota só.
Como as saídas de modelos generativos não são totalmente determinísticas, repita os casos críticos mais de uma vez quando a estabilidade for requisito. Uma falha única pode ser ruído; uma mudança consistente na taxa de sucesso é um sinal mais forte de regressão.
Árvore de diagnóstico: comece pelo sintoma, não pela solução
Depois de rodar a suíte, classifique o padrão de falha. A mesma sensação de “prompt pior” pode vir de causas muito diferentes.
Sintoma: a resposta ficou mais curta, mais longa ou mudou de estilo
Hipótese: houve drift comportamental ou mudou a calibração de verbosidade e iniciativa do modelo. Teste: mantenha o mesmo input e compare aderência a requisitos objetivos de conteúdo, não apenas comprimento. Veja se informações obrigatórias desapareceram ou se apenas a forma de apresentar mudou.
Se o conteúdo necessário continua presente, talvez não exista regressão funcional. Se o produto exige comprimento, tom ou estrutura específicos, transforme essa preferência em critério explícito e só então ajuste a instrução de estilo. Não reescreva o prompt inteiro para corrigir uma diferença de verbosidade.
Sintoma: o JSON começou a quebrar ou surgiram campos extras
Hipótese: o workflow dependia de obediência informal ao formato e o novo modelo distribui probabilidades de saída de outro modo. Teste: valide o mesmo schema fora do modelo e, quando disponível, ative o mecanismo nativo de Structured Outputs ou modo estrito do provedor. Confirme também se a API nova aceita exatamente o mesmo subconjunto de JSON Schema.
Se a estrutura volta a ficar estável com enforcement de schema, a causa não era necessariamente um “prompt ruim”. Era uma dependência frágil de formatação textual. O reparo mais robusto pode estar na camada de integração, não nas instruções.
Sintoma: a ferramenta certa não é chamada ou os argumentos mudam
Hipótese: mudou a política de tool use, a interpretação das descrições ou a compatibilidade das definições. Teste: reduza temporariamente o conjunto de ferramentas ao mínimo necessário e compare a decisão do modelo. Verifique nomes, descrições, campos obrigatórios, tipos e versões de ferramentas. Confirme se a migração do provedor alterou o formato de function calling ou a forma de retornar tool calls.
Se o modelo chama a ferramenta correta quando o conjunto é enxuto, o problema pode ser ambiguidade entre ferramentas ou descrições excessivas. Se nem assim funciona, investigue diferenças específicas da geração ou da API antes de aumentar o prompt.
Sintoma: o modelo ignora uma instrução que antes obedecia
Hipótese: a nova geração prioriza instruções ou contexto de forma diferente, ou a regra importante está escondida em um prompt longo e redundante. Teste: extraia somente a instrução que falhou e rode um caso mínimo. Se ela funciona isoladamente, reintroduza os blocos do prompt até descobrir qual parte cria conflito.
Esse teste também mostra quando o problema é excesso de instruções. Orientações atuais de fornecedores frequentemente recomendam prompts mais claros e menos contraditórios. Adicionar mais texto para corrigir cada falha pode piorar o sistema ao aumentar conflito e custo de contexto.
Sintoma: o modelo perde informação em contexto longo
Hipótese: o conteúdo relevante chegou em posição diferente, foi truncado, foi recuperado de forma distinta ou a nova geração reage de outro modo à organização do contexto. Teste: compare o contexto efetivamente enviado, a contagem de tokens e a posição das instruções. Em RAG, fixe a recuperação antes de trocar o modelo para separar retrieval de geração.
Se a informação nunca chegou ao modelo, não há prompt capaz de recuperá-la. Se chegou, mas a aderência varia com a posição, teste reorganização do contexto e instruções de ancoragem sem mudar simultaneamente outras partes do sistema.
Sintoma: o workflow ficou mais lento, caro ou termina truncado
Hipótese: mudou o uso de raciocínio, a quantidade de tokens, o tokenizer, o padrão de tool use ou o limite efetivo de saída. Teste: compare tokens de entrada e saída, motivo de parada, latência, número de chamadas de ferramenta e configurações de esforço ou thinking quando existirem.
Uma migração pode melhorar qualidade média e ainda assim piorar seu SLA. Isso é regressão para o seu produto, mesmo que o novo modelo seja mais capaz em benchmarks gerais. O critério de sucesso precisa incluir custo e latência quando eles fazem parte do requisito.
Sintoma: parâmetros antigos agora parecem inúteis ou causam erro
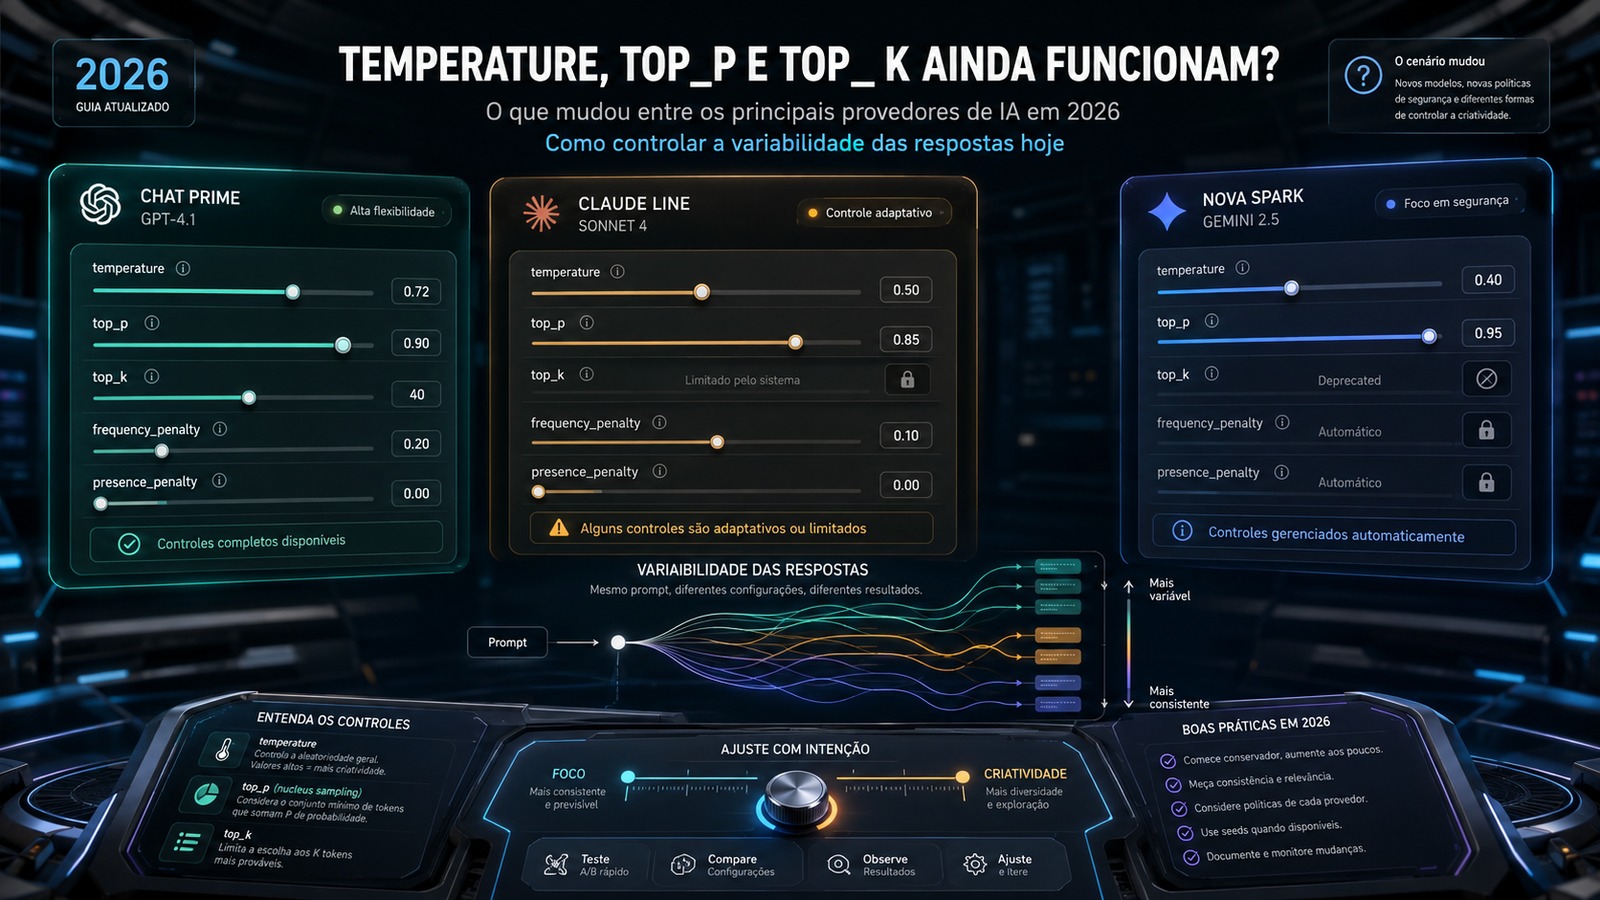
Hipótese: a nova geração mudou defaults, removeu parâmetros ou recomenda outra configuração. Teste: consulte o guia de migração do modelo específico e compare a requisição com a configuração recomendada. Não copie automaticamente temperature, top-p, thinking ou effort de uma geração para outra.
A documentação atual da Anthropic, por exemplo, registra gerações em que certos parâmetros de amostragem deixam de ser aceitos. A orientação do Google para gerações recentes do Gemini também inclui recomendações diferentes para temperature e prompting. Esse tipo de mudança mostra por que migrar apenas o nome do modelo pode não ser suficiente.
Não confunda migração de modelo com migração de API
Outro erro comum é trocar o modelo e aproveitar para migrar endpoint, SDK ou biblioteca. Nesse caso, você deixa de ter uma variável principal. O formato de respostas, o gerenciamento de estado, a representação das chamadas de ferramenta e os campos de saída podem mudar mesmo que o modelo fosse o mesmo.
Se a migração de API for obrigatória, faça dois marcos de comparação sempre que possível: primeiro confirme o comportamento do modelo antigo na nova integração; depois substitua apenas o modelo. Quando isso não for possível, pelo menos registre quais diferenças são de contrato da API e quais aparecem na qualidade da geração.
Quando o prompt realmente precisa mudar
Depois de eliminar problemas de schema, tool use, retrieval, parâmetros e integração, pode restar uma diferença real de interpretação. Aí sim o prompt entra como variável de ajuste.
A mudança mais segura é localizada. Se o novo modelo interpreta uma instrução vaga de maneira literal, torne essa instrução específica. Se responde curto demais, explicite o nível de detalhe. Se executa ações sem autorização, defina fronteiras de autonomia. Se não chama uma ferramenta quando deveria, ajuste a descrição da ferramenta ou a condição de uso. Cada alteração deve corresponder a uma falha medida.
Reescrever tudo de uma vez destrói a evidência acumulada. Você deixa de saber qual mudança resolveu o problema e cria risco de regressões em casos que já funcionavam. O procedimento mais confiável é mudar uma coisa por vez e rerodar a mesma suíte.
Um procedimento de migração que preserva diagnóstico
Passo 1: congele a versão que funciona
Salve prompt, modelo, parâmetros, ferramentas, schema, contexto e casos de teste. Se houver identificador versionado ou snapshot, registre-o. Guarde outputs representativos e métricas básicas.
Passo 2: defina o que significa “continuar funcionando”
Transforme expectativas em critérios. Pode ser taxa de JSON válido, acerto de classificação, chamada correta de ferramenta, presença de campos, aderência factual, latência máxima, custo por tarefa ou uma rubrica de qualidade. Sem critério, qualquer comparação vira gosto pessoal.
Passo 3: rode o modelo antigo e gere o baseline
Execute a suíte na configuração antiga. Esse resultado é a referência local do seu workflow, não um benchmark universal do modelo.
Passo 4: troque somente o modelo
Use a mesma suíte e preserve todas as variáveis que puder. Onde a migração exigir mudanças, documente-as separadamente. Compare os resultados por dimensão.
Passo 5: classifique cada regressão
Marque se a falha é comportamental, de formato, de ferramenta, de contexto, de parâmetro, de integração ou de estabilidade. Essa classificação determina onde testar em seguida.
Passo 6: aplique a menor correção possível
Prefira enforcement de schema para problemas de schema, correção de tool definition para problemas de ferramenta, ajuste de retrieval para problemas de contexto e mudança de parâmetro quando o guia de migração pedir. Reescreva instruções apenas quando a evidência apontar para interpretação ou comportamento.
Passo 7: rode regressão completa antes de promover
A correção precisa resolver o caso quebrado sem derrubar os casos que já passavam. Só promova a nova configuração quando a suíte mostrar que o ganho local não criou perdas em outro ponto do workflow.
O diagnóstico muda a pergunta que você faz ao modelo
Quando uma migração quebra um workflow, o prompt antigo não é lixo: ele é evidência. Ele permite medir a diferença entre duas configurações e localizar o ponto em que o comportamento mudou. Sem esse baseline, a tendência é entrar em um ciclo de tentativa e erro, adicionando instruções até que um exemplo volte a funcionar e sem saber o que aconteceu com os demais.
O caminho mais econômico é tratar a troca de modelo como uma mudança de sistema. Fixe o que funcionava, rode casos representativos, meça formato e tool use de forma objetiva, compare contexto e parâmetros, consulte o guia de migração do provedor e só depois altere o prompt. Às vezes a conclusão será que uma instrução precisa ficar mais explícita. Em outras, o prompt pode continuar exatamente como estava e a correção estará no schema, nas ferramentas, no contexto ou na integração.
Esse é o sinal de um diagnóstico bem feito: você deixa de perguntar “como reescrevo meu prompt?” e passa a saber qual variável precisa ser corrigida, por quê e contra quais testes a mudança deve ser validada.