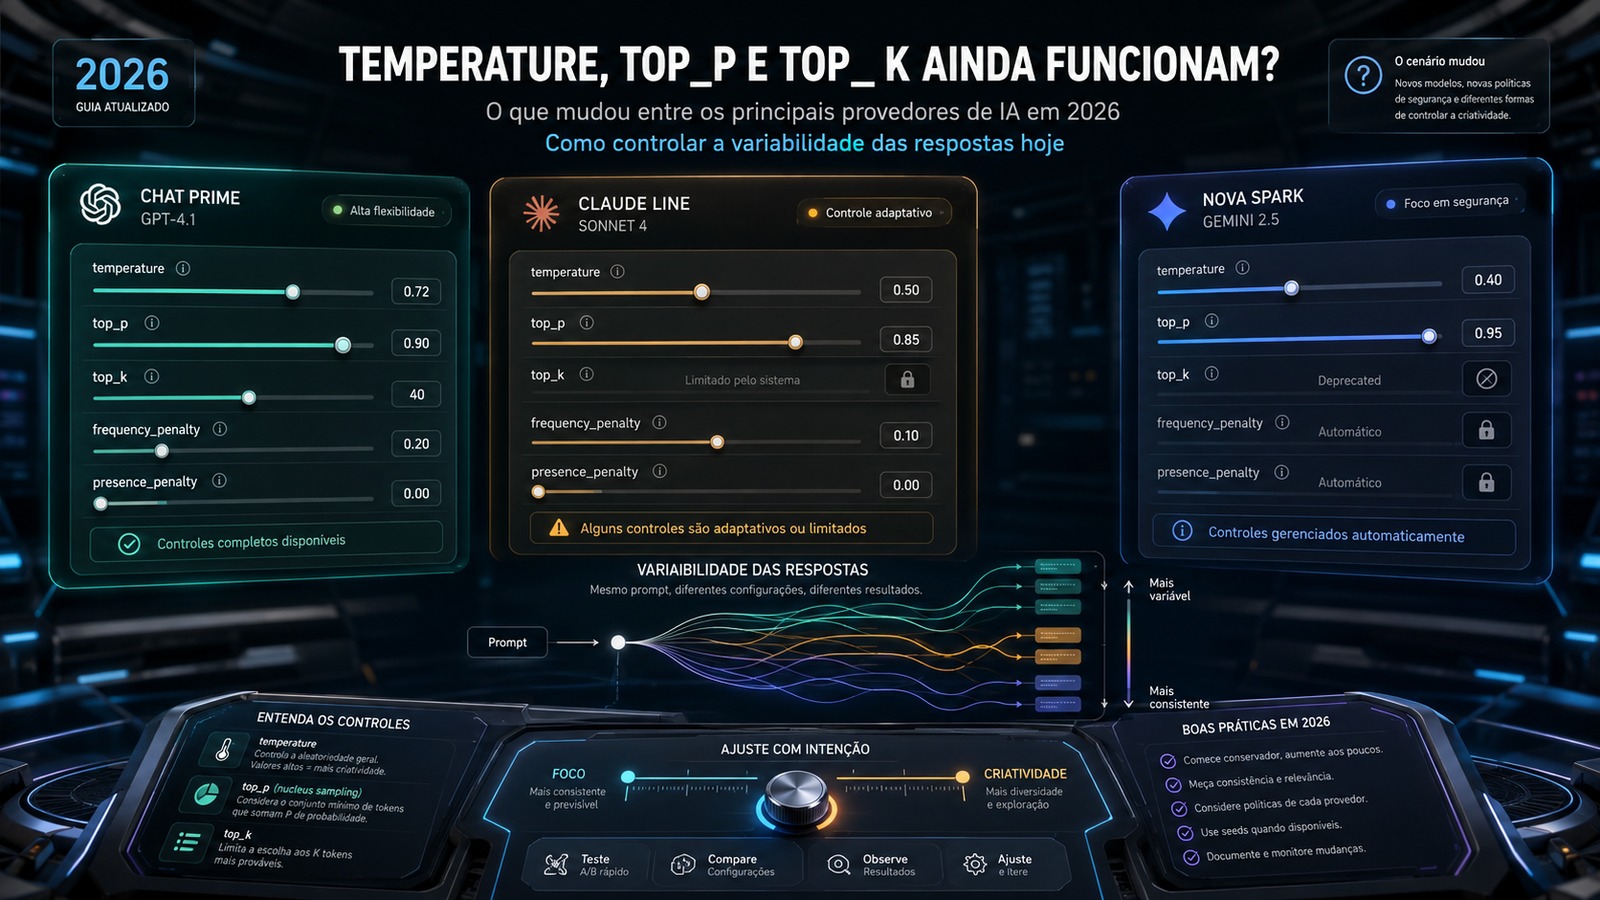
Se você ainda começa toda configuração de geração com temperature = 0 para “garantir determinismo”, é hora de revisar a receita. Em 2026, temperature, top_p e top_k não formam mais um painel universal que funciona do mesmo jeito em qualquer API. Em alguns modelos, continuam disponíveis. Em outros, são aceitos apenas em combinações específicas. Nos modelos mais novos de Claude e Gemini, valores não padrão foram descontinuados ou removidos do caminho recomendado.
A mudança mais importante é esta: a presença de um campo na referência geral de uma API não garante que aquele campo seja aceito pelo modelo que você escolheu. Hoje, o contrato relevante é a combinação entre fornecedor, modelo, endpoint e modo de raciocínio. As documentações oficiais consultadas em 29 de agosto de 2026 deixam esse padrão claro.
A resposta curta: sampling deixou de ser o controle principal
Temperature continua sendo um conceito válido: ela altera a distribuição usada para escolher o próximo token e, em interfaces que ainda expõem o parâmetro, valores mais baixos tendem a concentrar a geração em opções de maior probabilidade. Top_p aplica nucleus sampling, limitando a escolha ao conjunto de tokens cuja massa de probabilidade acumulada atinge o valor configurado. Top_k limita a escolha aos K tokens mais prováveis quando o modelo e a API oferecem esse mecanismo.
O problema não está nos conceitos. O problema é tratá-los como uma camada de controle portátil entre modelos. OpenAI ainda expõe temperature e top_p na referência geral da Responses API, mas a própria documentação mostra restrições por modelo e por reasoning effort. A Anthropic passou a rejeitar valores não padrão desses parâmetros nos Claude mais novos. O Google orienta remover temperature, top_p e top_k ao migrar para os Gemini 3.x mais recentes.
Na prática, os controles que ganharam importância em 2026 são reasoning effort, effort, thinking level, instruções de formato, structured outputs, limite de saída, escolha de ferramentas e testes de regressão. Eles não são substitutos matemáticos de temperature, mas são os controles que os
fornecedores estão oferecendo para governar comportamento, profundidade, custo, formato e consistência.
OpenAI: temperature e top_p existem, mas a compatibilidade é por modelo
A referência geral da Responses API ainda documenta temperature entre 0 e 2 e top_p entre 0 e 1. A OpenAI continua recomendando alterar um ou outro, não os dois ao mesmo tempo, quando o modelo realmente oferece suporte aos campos. Top_k, por outro lado, não aparece como parâmetro de amostragem na interface padrão de Responses ou Chat Completions.
O ponto decisivo é a compatibilidade do modelo. No guia do GPT-5.2, a OpenAI afirma que temperature, top_p e logprobs só são suportados quando reasoning effort está em none. O mesmo guia informa que requisições com esses campos em outros níveis de reasoning effort geram erro, e registra incompatibilidades também em modelos anteriores da família GPT-5.
Isso torna perigosa a regra “a API tem temperature, então meu modelo aceita temperature”. O schema geral descreve possibilidades da API; a página do modelo e o guia de migração dizem o que aquela combinação suporta.
GPT-4.1: o cenário clássico ainda existe
O GPT-4.1 continua listado como modelo sem etapa de reasoning e suporta Responses e Chat Completions. Nesse tipo de modelo, temperature e top_p continuam alinhados ao uso clássico descrito pela API. Para aplicações que precisam justamente de um modelo não reasoning com controle de amostragem tradicional, esse é o tipo de combinação em que a receita antiga ainda faz sentido. Top_k não faz parte desse conjunto de parâmetros padrão da OpenAI.
GPT-5.2: temperature e top_p ficam condicionados ao reasoning
No GPT-5.2, a regra oficial é explícita: temperature e top_p só entram quando reasoning effort está em none. Se você aumenta o esforço de raciocínio e mantém esses campos, a requisição pode falhar em vez de simplesmente “ficar menos criativa”. Essa diferença é operacionalmente importante porque transforma um ajuste que antes parecia contínuo em uma restrição de compatibilidade.
GPT-5.6: controle de comportamento migrou para outros eixos
A família GPT-5.6 é a linha atual da OpenAI em agosto de 2026. O guia de uso destaca reasoning.effort com níveis de none a max, reasoning.mode para o modo pro e text.verbosity para controlar o nível de detalhe. A orientação de migração também enfatiza testar configurações em tarefas representativas em vez de presumir que mais reasoning sempre melhora o resultado.
Ao mesmo tempo, a referência geral da Responses API continua contendo temperature e top_p. Como a documentação atual separa schema geral e compatibilidade específica de modelo, o procedimento seguro é não portar uma configuração antiga por inércia. Verifique a página do modelo, o endpoint e o reasoning effort usados na sua aplicação e faça uma chamada de validação antes de considerar o parâmetro parte do contrato de produção.
Claude: nos modelos novos, omita temperature, top_p e top_k
A mudança da Anthropic é mais direta. A referência atual da Messages API marca temperature, top_p e top_k como deprecated. Para modelos lançados depois do Claude Opus 4.6, a documentação informa que esses controles deixaram de ser ajustáveis da forma tradicional.
Para compatibilidade retroativa, temperature no valor padrão 1.0 pode ser aceito em alguns caminhos, e top_p em valor próximo do padrão também pode passar. Isso não significa que você ainda tenha um controle útil de aleatoriedade. Em Claude Sonnet 5, a documentação de migração é
mais clara: configurar temperature, top_p ou top_k com valores não padrão retorna erro 400. A recomendação é retirar esses campos do payload.
O mesmo movimento aparece na documentação de uso do Claude atual: nos modelos com adaptive thinking, effort é o controle recomendado para ajustar quanto trabalho o modelo dedica à resposta. No Claude Sonnet 5, effort high é o padrão; níveis medium e low reduzem gasto e profundidade, enquanto xhigh e max reservam mais capacidade para tarefas difíceis. No Claude Opus 5, a Anthropic também trata effort como controle principal.
Isso muda o significado de “quero menos variação”. Reduzir effort não equivale a baixar temperature. Effort mexe no trabalho total da resposta, incluindo thinking e, em determinados fluxos, chamadas de ferramentas. Para consistência de forma e conteúdo, a Anthropic recomenda combinar prompting mais explícito com structured outputs quando a saída precisa obedecer a um schema.
Gemini: os 3.x abandonam os knobs clássicos, enquanto 2.5 ainda convive com o modelo antigo
O Google fez uma transição visível em 2026. As notas de versão da Gemini API registraram em 21 de julho a depreciação de temperature, top_p e top_k. O guia do Gemini 3.7 Flash, atual em agosto, manda remover esses três parâmetros da configuração de geração. O mesmo guia observa que o Gemini 3.6 Flash já não os suportava.
O substituto comportamental central na linha 3.x é thinking_level. No Gemini 3.7 Flash, os níveis disponíveis são low, medium e high, com medium como padrão na documentação atual. Assim como effort no Claude e reasoning.effort na OpenAI, esse controle governa a quantidade relativa de raciocínio, não a aleatoriedade token a token.
Há uma nuance importante para código legado. Gemini 2.5 Pro e Gemini 2.5 Flash continuam ativos, sem data de desligamento anunciada na página de deprecações consultada. A referência geral de geração ainda descreve temperature, topP, topK e seed para modelos que suportam esses campos. Por isso, um payload que funciona em Gemini 2.5 pode precisar perder parâmetros quando é migrado para Gemini 3.6 ou 3.7.
Essa convivência explica por que exemplos antigos encontrados em buscas ainda parecem corretos. Eles podem estar corretos para outra geração de modelo ou para um endpoint legado, mas errados para a linha 3.x atual. Ao migrar, siga a página do modelo de destino e o guia de migração, não apenas um exemplo genérico do SDK.
O que “aceito”, “restrito” e “descontinuado” significam na prática
Aceito significa que o modelo documenta o parâmetro como parte normal da requisição e que mudar o valor é uma operação prevista. Restrito significa que o campo existe, mas só funciona em determinadas combinações, como temperature e top_p no GPT-5.2 com reasoning effort em none. Descontinuado significa que o fornecedor quer que você pare de depender do parâmetro; em Claude Sonnet 5, valores não padrão geram erro, e nos Gemini 3.x atuais a orientação é remover os campos.
Há ainda um quarto estado que costuma confundir integrações: aceito apenas como compatibilidade. Um valor padrão pode ser tolerado para não quebrar payloads antigos, mas sem oferecer controle real. Quando isso acontece, deixar o campo no JSON é pior do que removê-lo, porque passa a impressão de que sua aplicação está governando um comportamento que o modelo já controla internamente.
Como controlar a variabilidade agora
A primeira mudança é separar três problemas que antes eram colocados na conta da temperature: profundidade de raciocínio, formato da resposta e diversidade semântica. São problemas diferentes e precisam de controles diferentes.
Fixe modelo, versão e caminho de API
Se você mede consistência, registre o ID exato do modelo e o endpoint. Quando o fornecedor oferece snapshot ou versão fixa, use-a no teste. A OpenAI documenta snapshots como forma de manter uma versão específica do modelo. A Anthropic informa que os IDs do Claude a partir da geração 4.6 identificam versões fixas durante a vida daquele ID. Evite comparar uma execução de hoje com outra feita semanas depois usando um alias que pode apontar para comportamento atualizado sem registrar a mudança.
Use o controle de reasoning ou thinking para o que ele realmente faz
Na OpenAI, reasoning.effort altera a profundidade de raciocínio dos modelos que suportam esse mecanismo. No Claude, effort é o sinal recomendado para ajustar trabalho total e profundidade de thinking nos modelos atuais. No Gemini 3.x, thinking_level controla a intensidade relativa do raciocínio.
Esses parâmetros são mais úteis para decidir custo, latência e capacidade do que para produzir “a mesma frase toda vez”. Se a tarefa é classificação simples, reduzir esforço pode diminuir caminhos desnecessários. Se a tarefa é análise complexa, reduzir demais pode aumentar erros. A escolha deve vir de avaliação, não de uma equivalência imaginária com temperature.
Trave a estrutura da saída
Se o seu problema é “cada resposta vem em um formato diferente”, structured outputs costuma ser um controle mais forte do que sampling. OpenAI, Claude e Gemini oferecem mecanismos atuais para restringir a saída a um schema. Isso não garante que o conteúdo semântico seja idêntico, mas reduz variação de chaves, tipos, ordem lógica e formato de dados.
Para extração, classificação e integração com sistemas, essa mudança é especialmente importante. Em vez de tentar obter JSON estável apenas baixando temperature, declare o schema e valide o resultado.
Especifique critérios, não só estilo
Prompts consistentes descrevem o que deve permanecer invariável. Defina escopo, formato, campos obrigatórios, condições de parada, como tratar ausência de informação e quais decisões são permitidas. Se o modelo deve escolher entre categorias, forneça as categorias. Se deve retornar uma conclusão e duas evidências, diga isso. Se deve evitar inferências, defina como representar informação ausente.
Um prompt com critérios testáveis reduz liberdade onde ela atrapalha sem tentar eliminar toda a flexibilidade do modelo.
Controle ferramentas e contexto
Em agentes, boa parte da variação não nasce do sampling. Ela nasce de resultados de busca diferentes, ordem de ferramentas, dados que mudaram, histórico de conversa, cache, chamadas paralelas e decisões intermediárias. Se você compara duas configurações, mantenha ferramentas, contexto e dados de entrada constantes ou registre as diferenças.
Isso também explica por que temperature = 0 nunca foi uma garantia completa de reprodutibilidade. A própria Anthropic observa que temperature 0 não torna o resultado totalmente determinístico nos
modelos em que o parâmetro ainda existia. Em sistemas com ferramentas e raciocínio, há ainda mais fontes de variação além da escolha local de tokens.
Use seed apenas quando o modelo e o endpoint realmente oferecerem esse recurso
A documentação do Google ainda descreve seed em superfícies que suportam esse campo e ressalta que a saída pode ficar mais reprodutível, mas não absolutamente determinística. Seed é útil para testes quando está disponível, porém não é um padrão portátil entre OpenAI, Claude e Gemini e não substitui versionamento, controle de contexto e avaliação repetida.
Um teste reproduzível para saber se sua configuração realmente ficou mais consistente
A forma mais segura de decidir entre parâmetros é medir o comportamento da sua própria tarefa. O teste abaixo não depende de acreditar que um valor “baixo” é automaticamente melhor.
Defina um caso de teste fechado
Escolha uma tarefa representativa e mantenha a entrada fixa. Um bom exemplo é pedir a classificação de um texto em uma de cinco categorias, com justificativa curta e saída estruturada. Registre prompt de sistema, prompt do usuário, contexto, ferramentas disponíveis, schema, limite de tokens, modelo, endpoint e controles de reasoning ou thinking.
Rode uma linha de base repetida
Execute a mesma configuração pelo menos vinte vezes. Salve a resposta bruta, o uso de tokens, a latência, chamadas de ferramentas e qualquer erro de API. Se houver seed documentada para aquele modelo, registre também o valor usado.
A métrica principal não precisa ser “texto idêntico”. Para classificação, meça a taxa de concordância da categoria. Para extração, meça validade do schema e igualdade dos campos. Para texto livre, avalie presença das informações obrigatórias, comprimento e divergências semânticas relevantes.
Altere uma variável por vez
Troque apenas um elemento: reasoning effort, effort, thinking level, modelo, prompt ou structured output. Não mude o modelo e o prompt ao mesmo tempo. Se a API ainda oferecer temperature ou top_p naquele modelo, teste um deles de cada vez, seguindo a recomendação do fornecedor de não ajustar os dois simultaneamente sem necessidade.
Depois repita as execuções e compare. O objetivo é descobrir qual configuração entrega a melhor combinação de acerto, consistência, latência e custo para o seu caso, não encontrar um número mágico.
Trate erro de parâmetro como resultado do teste
Em 2026, um 400 causado por temperature, top_p ou top_k é informação útil: ele mostra que sua configuração está acoplada a uma geração de modelo diferente. Seu teste de compatibilidade deve falhar cedo no deploy quando um campo deixa de ser aceito, em vez de silenciosamente manter um parâmetro sem efeito.
Por que “temperature = 0” virou uma recomendação incompleta
A frase continua sendo útil em modelos que realmente expõem temperature e quando o objetivo é reduzir diversidade de amostragem. O erro é transformá-la em sinônimo de determinismo, qualidade ou consistência operacional.
Determinismo depende de mais coisas: versão do modelo, infraestrutura, contexto, ferramentas, dados recuperados, reasoning, formato de saída e eventuais atualizações de backend. Além disso, fornecedores atuais estão deslocando o controle de comportamento para parâmetros que não existem na antiga receita de sampling.
Em um modelo moderno, a melhor configuração pode ser não enviar temperature, usar reasoning ou thinking no nível adequado, exigir structured output, limitar a saída e executar evals. Em outro modelo, temperature ainda pode ser legítimo. A decisão agora começa pela compatibilidade documentada do modelo, não pelo valor numérico do parâmetro.
Regra de migração para não quebrar sua aplicação
Ao trocar de modelo, preserve primeiro o prompt e o caso de teste, depois revise o payload contra a documentação específica do destino. Remova parâmetros descontinuados, fixe explicitamente o novo controle de reasoning ou thinking quando isso afetar custo e comportamento, mantenha o mesmo schema de saída e rode a suíte de avaliação antes de ajustar o texto do prompt.
Na OpenAI, não presuma que um campo disponível na Responses API funciona em todos os GPT com qualquer reasoning effort. No Claude atual, retire temperature, top_p e top_k dos modelos novos e trabalhe com effort, prompting e structured outputs. No Gemini 3.x, siga a migração para thinking_level e remova os três sampling controls clássicos. Se você permanece em Gemini 2.5 ou em um modelo não reasoning mais antigo, documente essa dependência para que a próxima migração não seja uma surpresa.
O controle moderno é por contrato, não por superstição de parâmetro
Temperature, top_p e top_k não desapareceram da teoria de geração, mas perderam o status de knobs universais de produto. A prática de 2026 é mais específica: confirme o que o modelo aceita, use o controle de reasoning ou thinking apropriado, imponha estrutura quando a saída precisar ser previsível e meça repetidamente a tarefa real.
Se você precisa de consistência, a pergunta mais útil deixou de ser “qual temperature devo usar?” e passou a ser “qual combinação de modelo, versão, raciocínio, formato, contexto e teste mantém o comportamento dentro da variação que meu produto tolera?”. Essa pergunta continua válida mesmo quando o fornecedor decide remover o próximo parâmetro da API.