Mudar duas frases em um prompt e gostar mais da resposta seguinte não prova que o prompt melhorou. Pode ter mudado o caso, o modelo pode ter variado a saída ou a nova versão pode ter ficado melhor em um tipo de tarefa e pior em outro. A pergunta útil, portanto, não é “essa resposta ficou boa?”, mas “a versão nova vence a antiga de forma repetível nos casos que importam, sem criar regressões relevantes?”.
Esse raciocínio aproxima a avaliação de prompts de um teste. A documentação de avaliação da OpenAI recomenda objetivos explícitos, conjuntos de dados ligados ao uso real, métricas definidas e comparação contínua. A Anthropic também parte de critérios de sucesso mensuráveis, casos próximos da distribuição real e rubricas claras. O Google Cloud, por sua vez, documenta avaliação pairwise como uma forma apropriada de escolher entre prompts quando o objetivo é comparar duas alternativas. A ideia comum é simples: primeiro definir o que conta como sucesso; depois gerar evidência.
O erro mais comum: mudar o prompt e mudar o teste ao mesmo tempo
Imagine que a versão A respondeu mal a uma solicitação complicada. Você reescreve o prompt, envia outro exemplo mais simples e a versão B responde melhor. Isso pode ser um sinal de progresso, mas não é uma comparação. Para medir efeito da alteração, o caso de entrada precisa ser o mesmo, e as demais variáveis relevantes precisam permanecer controladas tanto quanto possível.
Se o objetivo é testar apenas o prompt, mantenha o mesmo modelo e a mesma versão do modelo, as mesmas instruções de sistema, as mesmas ferramentas disponíveis, o mesmo contexto recuperado, a mesma política de tamanho de saída e parâmetros equivalentes de geração. Quando alguma dessas condições precisar mudar, registre a mudança. Sem isso, uma melhora pode estar sendo atribuída ao prompt quando veio de outra parte do sistema.
Em uso manual, o controle não precisa virar laboratório acadêmico. Basta anotar o que foi mantido fixo e executar A e B sobre o mesmo conjunto de casos. O importante é que a comparação tenha regras estáveis.
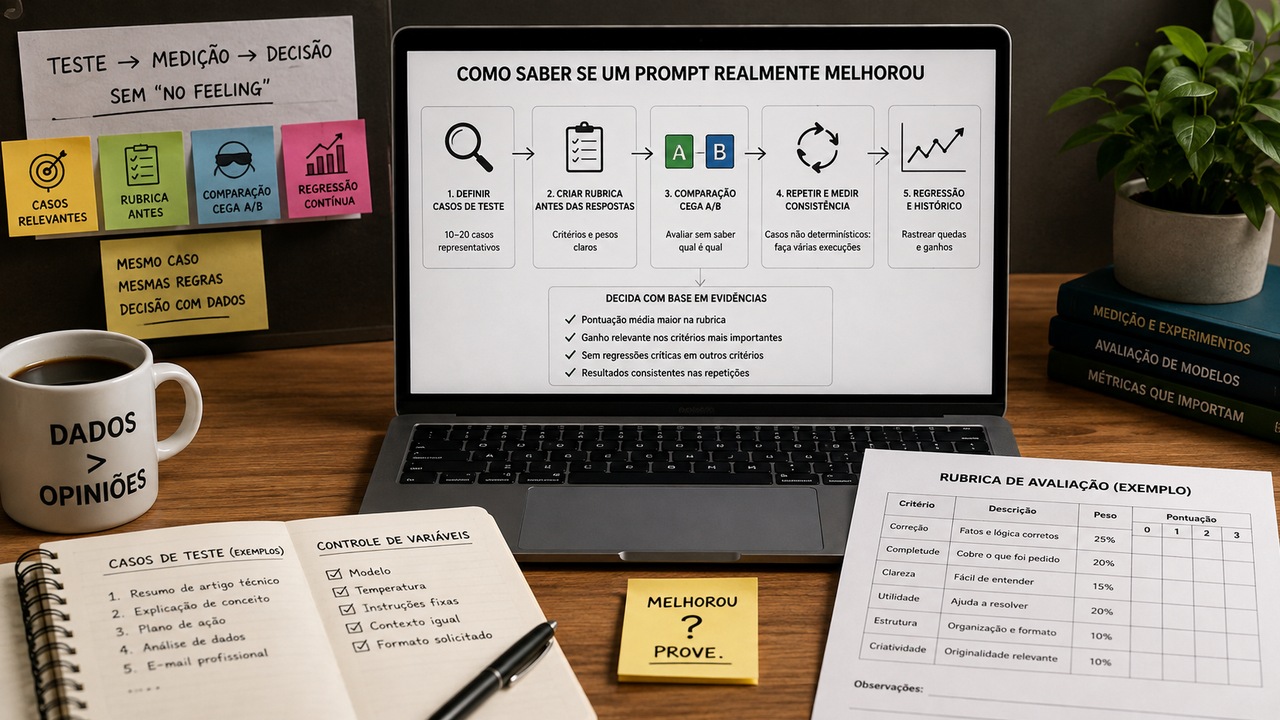
Comece com 10 a 20 casos que representem o trabalho real
Para uma primeira avaliação operacional, um conjunto de 10 a 20 casos pode ser suficiente para descobrir diferenças grandes entre duas versões. Esse número não é um padrão estatístico universal nem garante que um prompt esteja pronto para qualquer uso. Ele funciona como um conjunto inicial de alta utilidade, pequeno o bastante para ser revisado manualmente e grande o bastante para não depender de um único exemplo.
Os casos devem cobrir o centro e as bordas da tarefa. Se o prompt resume documentos, não teste apenas textos curtos e bem escritos; inclua material longo, informação faltante, trechos contraditórios e entradas com detalhes irrelevantes. Se o prompt responde clientes, inclua uma solicitação comum, uma mensagem ambígua, um pedido fora de política, um cliente irritado e um caso em que a resposta correta seja admitir que falta informação.
É útil separar os casos por fatias. Uma fatia pode ser “pedido simples”, outra “ambiguidade”, outra “risco de inventar informação”, outra “formatação”. Quando a média final mudar, essas fatias mostram onde o ganho aconteceu e onde uma regressão ficou escondida.
Também vale reservar alguns casos que não serão usados durante a reescrita do prompt. Eles funcionam como uma pequena validação fora do conjunto que orientou a melhoria. Isso reduz o risco de ajustar a versão B apenas para os exemplos que você já conhece.
Defina a rubrica antes de olhar as respostas
Uma rubrica transforma “gostei mais” em critérios observáveis. O momento de escrevê-la importa: se os critérios aparecem depois que você já viu A e B, existe a tentação de escolher regras que favoreçam a resposta preferida. Por isso, escreva a rubrica antes de gerar ou comparar as saídas.
Para uma tarefa geral de texto, uma rubrica pode combinar correção, aderência à instrução, completude, clareza e formato. Não existe uma combinação universal. A rubrica deve refletir o que causaria sucesso ou falha no uso real. Se omitir uma ressalva crítica é pior do que escrever de forma menos elegante, esse peso precisa aparecer na avaliação.
Uma escala curta costuma ser mais fácil de aplicar com consistência. Por exemplo, cada critério pode receber nota de 0 a 3. Zero significa falha grave ou ausência do requisito; 1 significa atendimento parcial com problema relevante; 2 significa atendimento adequado com pequenas falhas; 3 significa atendimento completo. O valor da escala está menos no número e mais nas âncoras que explicam o que cada nota quer dizer.
Os pesos podem refletir prioridade. Em um prompt de resposta ao cliente, um exemplo plausível seria correção com 30%, aderência à instrução com 25%, completude com 20%, clareza com 15% e formato com 10%. Se uma dimensão for inegociável, trate-a também como critério de bloqueio. Assim, uma versão não é aprovada apenas porque compensou uma falha crítica com boa escrita em outros itens.
Compare A e B sem deixar o nome da versão contaminar o julgamento
Uma comparação cega simples ajuda quando a avaliação é humana. Em vez de mostrar “prompt antigo” e “prompt melhorado”, rotule as respostas como X e Y, embaralhe a ordem em cada caso e peça ao avaliador para aplicar a rubrica sem saber qual versão produziu cada saída. Depois, revele a origem.
Esse desenho é especialmente útil quando quem avalia também escreveu a versão nova. A pessoa naturalmente espera que a alteração funcione. Ocultar a identidade das respostas não elimina todos os vieses, mas reduz a chance de transformar expectativa em pontuação.
Além da nota por rubrica, registre a preferência direta: X melhor, Y melhor ou empate. Avaliações pairwise são úteis quando duas respostas são aceitáveis, mas uma atende melhor ao objetivo. A própria documentação da OpenAI destaca que modelos tendem a ser mais confiáveis ao discriminar opções do que em avaliações totalmente abertas, e o Google Cloud oferece métricas pairwise especificamente para comparar prompts e modelos.
Repita os casos em que a saída varia
Modelos generativos podem produzir respostas diferentes para a mesma entrada. Uma única execução pode favorecer A ou B por acaso. Se um caso importante oscila, rode novamente as duas versões mantendo a configuração igual.
Em um processo manual, três repetições já podem revelar um padrão útil: uma versão que parecia excelente na primeira rodada pode falhar nas duas seguintes, enquanto outra pode ser menos brilhante, porém mais estável. Para tarefas de maior risco ou grande variabilidade, aumente o número de repetições e trate estabilidade como um critério próprio.
Não some repetições como se fossem casos independentes sem pensar no desenho. O objetivo prático é descobrir se o comportamento é consistente. Registre cada execução e depois resuma a tendência por caso: vitória estável de A, vitória estável de B, empate ou resultado volátil.
Regressão é a parte que a média esconde
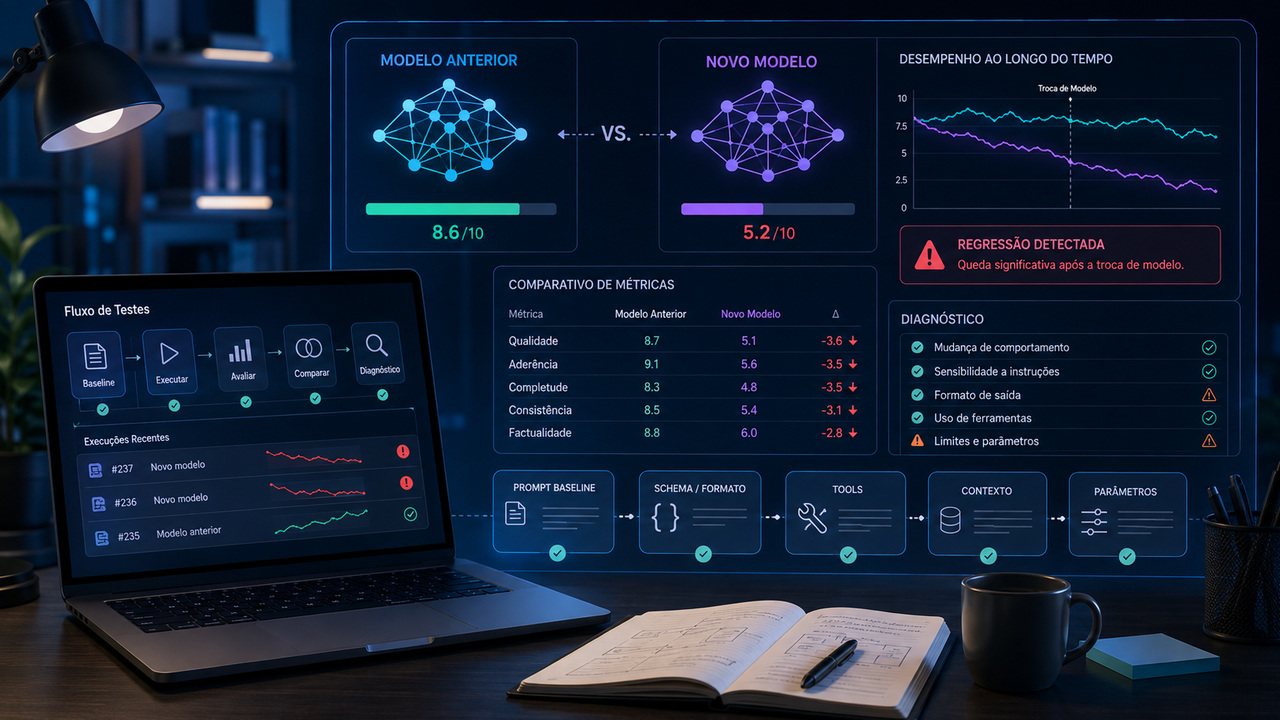
Uma nova versão pode elevar a nota média e ainda ser pior. Isso acontece quando ela melhora muitos casos fáceis, mas quebra um caso raro e importante. A regressão é justamente a perda de desempenho em algo que antes funcionava.
Por isso, compare caso a caso. Marque como regressão qualquer situação em que B piorou em relação a A e classifique a gravidade. Uma queda pequena de estilo pode ser tolerável; inventar uma informação que a versão anterior não inventava pode bloquear a mudança.
Antes do teste, defina a regra de decisão. Um exemplo prático seria: B precisa ter nota ponderada superior, vencer mais casos do que perde e não apresentar regressão crítica. Outro projeto pode exigir um ganho mínimo em um critério específico, como aderência a formato. O importante é evitar criar a regra depois de ver o placar.
A planilha-modelo pode ser simples
Você não precisa de uma plataforma de evals para começar. Uma planilha já permite executar um processo disciplinado. Cada linha representa um caso ou uma repetição de caso. As colunas essenciais podem ser: ID do caso, fatia, entrada, comportamento esperado, criticidade, versão avaliada, número da repetição, resposta, notas por critério, nota ponderada, preferência A/B, regressão, observação, modelo e configuração usados.
Se quiser manter A e B lado a lado, use uma linha por caso com dois blocos de colunas: resposta A e notas A, resposta B e notas B. Acrescente uma coluna “vencedor” e outra “regressão crítica?”. Para comparação cega, faça a avaliação primeiro em uma cópia onde as respostas aparecem como X e Y; só depois preencha a coluna que revela qual prompt gerou cada uma.
A planilha deve guardar também a versão exata dos prompts. Evite nomes vagos como “novo prompt”. Use identificadores como A-2026-08-16 e B-2026-08-16. Se a avaliação for repetida no futuro após trocar modelo, contexto ou ferramenta, esse histórico ajuda a distinguir regressão de prompt de mudança no restante do sistema.
Exemplo completo: de um prompt genérico para um prompt testável
Considere um caso fictício: uma equipe usa IA para responder e-mails de clientes sobre o andamento de solicitações. A versão A do prompt diz: “Responda ao cliente de forma educada e objetiva, explicando o status e o próximo passo.” Parece razoável, mas deixa decisões importantes implícitas.
A versão B diz: “Responda ao cliente em até 120 palavras. Explique apenas informações presentes no contexto fornecido. Informe o status atual, o próximo passo confirmado e, se não houver prazo confirmado, diga explicitamente que o prazo ainda não está disponível. Não invente datas, responsáveis ou garantias. Mantenha tom cordial e direto.”
Antes de testar, a equipe define quatro critérios. Correção factual recebe peso de 35%; aderência às restrições, 30%; completude, 20%; clareza, 15%. Inventar prazo ou responsável é regressão crítica e bloqueia aprovação, independentemente da média.
O conjunto contém 12 casos. Há mensagens simples, pedidos sem prazo confirmado, clientes irritados, contexto incompleto e um caso em que o histórico traz duas datas conflitantes. As respostas são geradas com o mesmo modelo, a mesma configuração e o mesmo contexto de cada caso. Um avaliador recebe apenas X e Y, sem saber qual corresponde a A ou B.
Suponha que, nesse exemplo hipotético, B vença 8 casos, A vença 2 e ocorram 2 empates. B também obtém média ponderada maior. Porém, em um caso com datas conflitantes, B escolhe uma data e a apresenta como confirmada, enquanto A evita afirmar um prazo. Pela regra definida antes do teste, B ainda não está aprovada: houve regressão crítica.
A equipe então altera apenas a instrução relacionada a conflito de informações, criando uma versão C. Os mesmos 12 casos são repetidos, com atenção especial ao caso que falhou. Se C mantiver os ganhos de B e eliminar a regressão crítica, existe evidência muito mais forte de melhoria do que a impressão causada por uma resposta bonita.
O ponto do exemplo não é que todo teste precise de 12 casos, quatro critérios ou esses pesos. O ponto é que a decisão foi definida antes do placar, as versões enfrentaram as mesmas entradas e uma melhoria média não apagou uma falha importante.
Como escolher entre nota absoluta e preferência A/B
A nota absoluta responde “quanto esta resposta atende ao padrão?”. Ela é melhor quando a equipe precisa saber se cada versão passa um nível mínimo. A preferência A/B responde “qual das duas é melhor neste caso?”. Ela é útil quando as respostas são difíceis de pontuar com precisão, mas a diferença entre elas é perceptível.
As duas abordagens podem coexistir. Use a rubrica para verificar qualidade mínima e critérios críticos; use a preferência pairwise para comparar versões diretamente. Quando rubrica e preferência discordarem, investigue o caso em vez de esconder a divergência na média.
Avaliação automática também pode entrar no processo. Regras de código são excelentes para requisitos objetivos, como presença de campos, formato válido ou tamanho máximo. Julgamento humano é mais flexível, mas custa tempo. Um modelo julgador pode escalar avaliações subjetivas, porém precisa ser testado e calibrado contra avaliações humanas antes de receber confiança operacional. A documentação da Anthropic e do Google Cloud trata explicitamente dessa necessidade de rubricas claras e calibração do avaliador automático.
Quando um prompt pode ser considerado melhor
Uma mudança está bem sustentada quando há convergência de evidências: a nova versão melhora a métrica principal, vence mais casos relevantes, mantém ou melhora critérios prioritários, não cria regressões críticas e repete o resultado em casos que apresentam variabilidade.
Isso é diferente de exigir perfeição. Prompts reais quase sempre envolvem trade-offs. Uma versão pode ficar um pouco mais longa e, em troca, reduzir omissões. Outra pode ganhar clareza, mas perder velocidade. O teste torna esse custo visível para que a equipe escolha conscientemente.
Também é saudável registrar resultado inconclusivo. Se A e B empatam, se as repetições oscilam muito ou se a rubrica não consegue separar qualidade, a conclusão correta pode ser “ainda não há evidência de melhoria”. Isso é melhor do que forçar uma vitória para justificar o trabalho já feito.
Transforme falhas novas em casos permanentes
O conjunto de testes não deve ficar congelado. Sempre que surgir uma falha real importante, transforme-a em um novo caso de regressão. Na próxima alteração de prompt, esse caso volta a ser executado. Com o tempo, a suíte passa a representar não apenas exemplos planejados, mas também erros que o sistema já cometeu.
Esse ciclo é o que faz avaliação de prompt deixar de ser uma revisão ocasional e virar controle de qualidade. A versão nova não precisa apenas parecer inteligente em uma conversa; ela precisa sobreviver ao histórico de problemas que a equipe já aprendeu a reconhecer.
No fim, “prompt melhor” é uma afirmação comparativa. Ela só faz sentido quando existe uma versão de referência, um conjunto de casos, critérios definidos antes da observação e uma regra de decisão. O feeling continua útil para formular hipóteses e perceber que algo pode estar melhor. A aprovação, porém, deve vir dos testes.