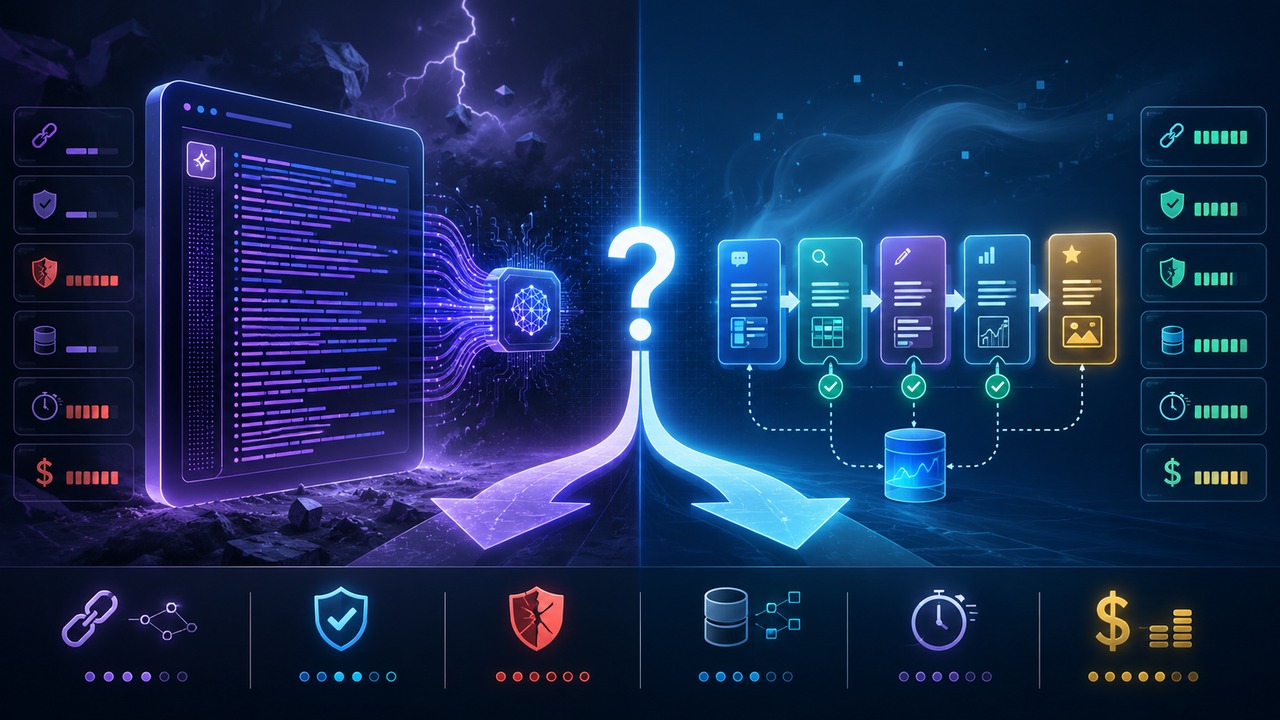
Si una persona va a leer la respuesta, puede funcionar bien preguntar "responder en JSON". Si va directamente a un analizador, base de datos, cola, hoja de cálculo, API o automatización, la pregunta cambia: ¿qué contrato necesita recibir su código? En 2026, OpenAI, Claude y Gemini ofrecen mecanismos de salida estructurados nativos con esquema JSON, pero esto no hace que JSON y esquema sean equivalentes de forma rápida y gratuita.
La regla general es simple. La instrucción textual intenta guiar el formato. Un modo JSON se encarga principalmente de la sintaxis. Las Salidas Estructuradas intentan imponer la forma del objeto. Ninguna de estas capas demuestra por sí sola que el contenido sea correcto.
Hay tres problemas diferentes ocultos en la frase "Quiero JSON"
El primer problema es la apariencia de la respuesta. Desea que la plantilla no incluya una introducción, Markdown, comentarios o explicaciones alrededor del objeto. Un mensaje como "responder solo en JSON" suele ser útil, pero sigue siendo una instrucción de comportamiento. El modelo aún puede cambiar los nombres de los campos, omitir propiedades, cambiar tipos o elegir un formato similar, pero incompatible con su código.
El segundo problema es la validez sintáctica. Aquí la pregunta es: ¿se puede analizar la cadena como JSON sin errores? OpenAI todavía documenta un modo JSON antiguo e independiente que garantiza JSON válido, pero no el esquema deseado. Esto elimina una clase de errores de análisis, pero no evita que la respuesta llegue con campos incorrectos.
El tercer problema es el cumplimiento de un contrato. En este caso, no basta con recibir un objeto válido; debe contener las propiedades esperadas, los tipos correctos y, cuando corresponda, valores vinculados a enumeraciones. Para eso están las Salidas Estructuradas y los mecanismos equivalentes basados en el Esquema JSON.
La diferencia más importante es esta: el formato válido no es lo mismo que la estructura válida, y la estructura válida no es lo mismo que la respuesta verdadera.
El mismo caso de extracción muestra dónde falla cada enfoque
Imagínese un sistema que recibe un mensaje de servicio al cliente y necesita extraer cinco campos: nombre del cliente, intención, prioridad, necesidad de devolución y número de teléfono. La intención sólo puede ser "actualizar", "cancelar" o "soporte". La prioridad sólo puede ser “baja”, “media” o “alta”. El teléfono puede estar nulo cuando no está presente.
Con instrucciones textuales, puede describir este formato en el mensaje e incluso proporcionar un ejemplo. En muchos casos el modelo cumplirá. Pero en una ejecución, puede utilizar “cliente” en lugar de “nombre_cliente”; en otro, puede transformar la prioridad en número; en otro, puedes agregar una explicación fuera de JSON.
Con JSON válido, el analizador ya no es el principal problema. Aún así, nada detiene un objeto perfectamente analizable como {"urgent": true, "category": "upgrade"} cuando su código esperaba otro conjunto de campos.
Con JSON Schema, el contrato pasa a formar parte de la propia configuración de generación. El modelo está restringido al conjunto de claves, tipos y valores permitidos por el esquema, dentro de las capacidades de cada proveedor. Esto reduce drásticamente los errores de integración, pero no evita un error semántico. El modelo aún puede elegir "soporte" cuando el texto indica "actualización" o completar un valor plausible en un campo que debería ser nulo.
Esta separación entre error de formato y error de contenido es el punto que más previene la falsa confianza.
OpenAI: el modo JSON resuelve el análisis; Productos Estructurados resuelve el contrato
En la API de OpenAI, las salidas estructuradas se pueden utilizar para estructurar la respuesta final o para restringir los argumentos de llamada a funciones. La documentación actual recomienda salidas estructuradas en modo JSON siempre que el modelo y el caso de uso lo admitan.
En modo JSON, la garantía central recibe JSON válido. El esquema sigue siendo responsabilidad de la aplicación. Si espera campos específicos, deberá validar el objeto más adelante y decidir qué hacer cuando falte una clave, un tipo incorrecto o un valor fuera del dominio esperado.
En resultados estructurados, OpenAI utiliza un subconjunto de esquema JSON e impone sus propias reglas. Los objetos deben bloquear propiedades adicionales con propiedades adicionales establecidas en falso y todos los campos deben configurarse como obligatorios. Cuando un campo es conceptualmente opcional, la salida puede modelarlo según sea necesario pero aceptando nulo. El objeto raíz también tiene restricciones específicas, como que no puede ser un anyOf en la parte superior.
Esto significa que un esquema que funciona en otra biblioteca o proveedor puede necesitar una adaptación antes de enviarse a OpenAI.
Todavía hay dos excepciones operativas que el código debe manejar. Un rechazo de seguridad puede salirse del esquema esperado, ante una señal de rechazo específica. Y una respuesta interrumpida por un límite de token puede estar incompleta. Las salidas estructuradas eliminan la necesidad de reintentos por violaciones normales del esquema, pero no convierten cada llamada API en un objeto comercial utilizable.
Claude: la salida JSON estructurada y el uso estricto de herramientas son controles diferentes
Anthropic ofrece hoy resultados estructurados en Claude en dos frentes. Para la respuesta final, la API utiliza salidas JSON a través de output_config.format. Para llamadas a herramientas, estricto: verdadero restringe los parámetros al esquema de la herramienta.
Esta distinción es útil porque responde a dos problemas diferentes. Si el modelo necesita devolver un objeto a su aplicación, usted estructura el resultado final. Si necesita activar una función, haga que los argumentos de la herramienta sean estrictos. En flujos agentes, ambos mecanismos se pueden utilizar juntos.
La documentación de Claude también muestra por qué "esquema JSON" no significa automáticamente "toda la especificación del esquema JSON". Algunas restricciones no son aceptadas directamente por el mecanismo de generación. Los SDK pueden simplificar los esquemas generados por Pydantic o Zod, mover ciertas restricciones a las descripciones y luego validar localmente con el esquema original. Por lo tanto, la aplicación aún necesita saber qué parte se impuso realmente durante la generación y qué parte se verificó después.
También hay excepciones explícitas. Un rechazo de seguridad puede finalizar la respuesta con un rechazo stop_reason y no cumplir con el esquema. Un max_tokens puede recortar la salida. Y la documentación misma señala una advertencia inusual para las enumeraciones de cadenas: las mayúsculas pueden variar en algunos casos. Si sus valores solo difieren en efectivo, eso es un diseño de contrato débil.
También hay una trampa de portabilidad importante: en la capa de compatibilidad con OpenAI SDK, Anthropic informa que se ignora la llamada estricta a funciones. Para garantizar el cumplimiento en Claude, la ruta recomendada es la API nativa con salidas estructuradas.
Gemini: el esquema reduce la ambigüedad, pero no reemplaza la validación empresarial
La documentación actual de Gemini le permite configurar salidas estructuradas con un esquema JSON, utilizando una respuesta en application/json y un esquema asociado. El resultado se genera como JSON sintácticamente válido que coincide con el formato aceptado por la implementación del proveedor.
Gemini admite un subconjunto de esquemas JSON. Se admiten tipos como cadena, número, entero, booleano, objeto, matriz y nulo, así como funciones útiles como requerido, enumeración, límites numéricos y propiedades de matriz en ciertas superficies API. No se admiten todas las funciones de la especificación y es posible que se rechacen los esquemas que sean demasiado grandes o demasiado anidados.
Un detalle particularmente importante aparece en las mejores prácticas de Google: la salida estructurada garantiza la forma, no la corrección semántica de los valores. La recomendación es validar el resultado final en el código antes de usarlo en reglas de negocio.
Esto evita un error arquitectónico común. Una enumeración puede evitar que el modelo escriba "muy urgente" cuando el contrato sólo acepta "bajo", "medio" y "alto". Pero no impide que el modelo elija “alto” cuando el mensaje debería clasificarse como “medio”. El objeto puede ser perfecto para el analizador y aun así ser incorrecto para el producto.
La portabilidad no se trata de copiar el mismo esquema entre tres API
Los tres proveedores han convergido en torno al esquema JSON como lenguaje de contrato, pero no han convergido en todos los detalles de implementación.
En OpenAI, existen requisitos como obligatorio para todos los campos y propiedades adicionales falsas. En Claude, existe su propio conjunto de recursos y límites de complejidad, así como transformaciones que algunos SDK realizan automáticamente. En Gemini, la documentación también habla explícitamente sobre subconjuntos de especificaciones y posibles rechazos de esquemas complejos.
Por lo tanto, la estrategia más sólida para una aplicación multiproveedor es mantener un modelo de datos canónico dentro de su código y crear una capa delgada de adaptación para cada API. El dominio debe decir qué significa "cliente", "prioridad" o "resultado". El adaptador debe traducir este contrato al subconjunto aceptado por el proveedor.
Esto también evita que los detalles de una API se filtren a todo el sistema. Si mañana un proveedor cambia el nombre del parámetro, amplía la compatibilidad con el esquema JSON o cambia una limitación, usted modifica el adaptador y conserva el resto de la aplicación.
Cuanto más importa la portabilidad, mejor es preferir esquemas simples: objetos explícitos, tipos claros, enumeraciones estables, pocos niveles de anidamiento y una estrategia coherente para los valores faltantes.
Los campos faltantes, el rechazo y el “No sé” deben dibujarse
Los esquemas estrictos crean una consecuencia que no siempre es obvia: si el formato requiere una respuesta, el modelo intentará llenar el formato.
El propio OpenAI advierte que, cuando la entrada del usuario no permite producir una respuesta válida para el esquema, el modelo puede terminar alucinando un valor para satisfacer la estructura. La solución no es abandonar el esquema; es diseñar el contrato para representar la ausencia de información.
Si es posible que no exista un teléfono, utilice nulo como posibilidad. Si una clasificación puede ser indeterminada, considere que un valor explícito es "indeterminado" siempre que tenga un significado real en el dominio.. Si la tarea puede fallar debido a la falta de evidencia, represente ese estado en un campo propio en lugar de obligar al modelo a elegir una respuesta que parezca completa.
Las denegaciones de seguridad son otro caso. No deben mezclarse con “datos faltantes”. OpenAI y Claude exponen sus propias señales de exclusión voluntaria que pueden reemplazar la salida estructurada normal. La aplicación debe detectar este estado antes de intentar consumir el objeto comercial.
Lo mismo ocurre con las respuestas confusas, los errores de red y los límites de API. Un analizador no es un sistema de manejo de fallas.
Las enumeraciones fijan el vocabulario, no la decisión
Las enumeraciones son una de las mayores ventajas prácticas de los resultados estructurados porque eliminan variaciones que a menudo interrumpen la automatización.
Sin un esquema, una clasificación de prioridad puede ser “alta”, “urgente”, “alta”, “P1” o “crítica”. Con enum, fuerza el contrato a un conjunto de valores que el código conoce. Esto simplifica la base de datos, las métricas, los filtros y las reglas condicionales.
Pero enum no es un verdadero verificador. Si los valores permitidos son “aprobado” y “reprobado”, el esquema asegura que la respuesta utilice uno de ellos; no garantiza que la decisión sea correcta. Por lo tanto, las tareas de clasificación aún necesitan ejemplos, definiciones de clases, pruebas y, cuando el riesgo lo requiera, revisión o reglas deterministas.
En Claude, también existe la advertencia documentada sobre la capitalización de algunos valores de enumeración. En la integración de múltiples proveedores, normalizar las mayúsculas y minúsculas en el lado de la aplicación y evitar categorías que solo se distinguen por mayúsculas y minúsculas reduce las sorpresas.
La validación posterior sigue siendo obligatoria
Las salidas estructuradas reducen en gran medida el trabajo de validación estructural, pero una aplicación de producción aún necesita validar en capas.
Primero: confirmar el estado de la respuesta
Antes de analizar la carga útil, verifique si la llamada finalizó normalmente. El rechazo, el truncamiento, el bloqueo, el tiempo de espera y el error de transporte deben seguir un flujo de error, no la misma ruta que los datos válidos.
Segundo: validar el contrato local
Incluso cuando el proveedor promete cumplimiento, validar el objeto con la misma biblioteca que define sus tipos ayuda a proteger contra cambios en el SDK, diferencias de integración y esquemas transformados. Pydantic, Zod y equivalentes cumplen bien esta función.
Tercero: validar la semántica
Aquí es donde entran las reglas que JSON Schema no puede decidir por sí solo. ¿Es necesario que una fecha esté dentro del período permitido? ¿Es necesario que exista un identificador en el banco? ¿Es necesario cerrar la suma? ¿Es una categoría elegida por el modelo compatible con el texto fuente? Estos controles siguen siendo responsabilidad de la aplicación.
Esta distinción también aparece en la investigación sobre generación estructurada. JSONSchemaBench, presentado en 2025, reunió alrededor de 10 mil esquemas reales y comparó diferentes mecanismos de decodificación restringidos, incluidos OpenAI y Gemini. El trabajo encontró diferencias en cobertura, eficiencia y comportamiento entre implementaciones. La lección práctica no es que el esquema "no funciona", sino que el cumplimiento estructural debe probarse en el entorno y en el conjunto de esquemas que realmente se utilizan.
Cuando simplemente escribe “responder en JSON”
La instrucción textual es suficiente cuando el JSON es simplemente una conveniencia de presentación, la respuesta será revisada por un humano o el consumidor tolera variaciones en la estructura.
También puede ser aceptable en prototipos rápidos, en tareas sin mayor automatización o cuando aún estás descubriendo qué campos deberían existir realmente. En esta etapa, un contrato rígido puede congelar una mala estructura demasiado pronto.
El coste de esta flexibilidad es claro: si el contenido se convierte en código, hay que asumir que cualquier parte del formato puede variar.
Cuándo usar JSON gratuito o un modo JSON
Un modo que garantiza JSON válido es útil cuando el primer requisito es eliminar errores de análisis, pero el marco aún está abierto o es heredado.
En OpenAI, el modo JSON sigue existiendo precisamente como esta capa más básica. Puede tener sentido cuando las salidas estructuradas no están disponibles en el modelo o la integración elegidos, o cuando simplemente desea garantizar un objeto analizable y desea validar la forma más adelante.
Para aplicaciones nuevas que ya conocen el contrato, esta capa intermedia generalmente aporta menos valor: continúas escribiendo indicaciones de formato y manteniendo la validación del esquema en el exterior.
Cuándo utilizar el esquema JSON
Usa el esquema impuesto por la API cuando el resultado se consume automáticamente y la forma del objeto forma parte del contrato de aplicación.
Esto es especialmente importante en la extracción de datos, la clasificación con enumeraciones, el llenado de formularios, la generación de registros, la composición de interfaces y cualquier flujo en el que una clave incorrecta genere un error de ejecución o datos corruptos.
El esquema también ayuda a reducir la ingeniería de avisos accidentales. En lugar de gastar varias líneas repitiendo "no agregue campos", "use estos nombres exactos" y "no coloque texto fuera de JSON", transfiere parte de ese control a un mecanismo diseñado para restringir la salida.
Aun así, conserve las instrucciones sobre la tarea. El esquema indica cómo se debe representar la respuesta; el mensaje continúa diciéndole al modelo qué entender y decidir.
Cuando la herramienta es el contrato adecuado
Si el objetivo no es devolver datos al usuario, sino realizar una acción, la llamada a funciones o el uso de herramientas suele ser la interfaz más adecuada.
OpenAI y Claude diferencian explícitamente la salida de respuesta estructurada y las llamadas a herramientas con parámetros escritos. Gemini también trata las salidas estructuradas y las llamadas a funciones como casos de uso distintos. El patrón arquitectónico es útil: respuesta estructurada para representar información; herramienta que llama para pedirle al sistema que haga algo.
Mezclar las dos funciones a menudo conduce a API confusas. Un objeto llamado “acción” en la respuesta final no realiza nada por sí solo. Una llamada a una herramienta, por otro lado, es parte de un bucle en el que la aplicación decide si se ejecuta, valida los argumentos, devuelve resultados y continúa la conversación.
Un diseño robusto para OpenAI, Claude y Gemini
Comience con el tipo de datos de su aplicación, no con la sintaxis de una API específica. Defina campos, enumeraciones, capacidad de nulos y reglas comerciales en su dominio. Luego genere o adapte el esquema para cada proveedor.
Trate el esquema como una interfaz, no como un reemplazo del mensaje. Utilice descripciones de propiedades para reducir la ambigüedad, escriba instrucciones claras sobre la extracción o la clasificación e incluya ejemplos solo cuando le ayuden a decidir el contenido.
Separe los estados comerciales de los estados de ejecución. El “teléfono perdido” pertenece a la carga útil. "Modelo rechazado", "respuesta truncada" o "API fallida" pertenecen al control de llamadas.
Validar localmente antes de persistir o ejecutar. Si el objeto desencadena una transacción, un cambio de cuenta o cualquier operación irreversible, agregue reglas deterministas y autorizaciones fuera del modelo.
Y pruebe el mismo conjunto de entradas en los proveedores que desea respaldar. Un esquema aceptado por uno no es prueba de que otro aceptará las mismas palabras clave, profundidad o combinación de restricciones.
La elección correcta depende del consumidor, no de la bella forma
“Responder en JSON” es una instrucción. El modo JSON es una garantía de sintaxis. Los Productos Estructurados son un contrato estructural más fuerte. La diferencia sólo queda clara cuando observas quién consumirá la respuesta.
Si el consumidor es una persona, la flexibilidad puede ser una ventaja. Si se trata de código, la previsibilidad se vuelve más valiosa. Si el resultado activa reglas de negocio, incluso un JSON perfecto no es suficiente sin una validación semántica.
En producción, el objetivo no es recibir un objeto que parezca organizado. Está recibiendo datos que el analizador comprende, el contrato acepta y el sistema sabe cuándo rechazarlo.