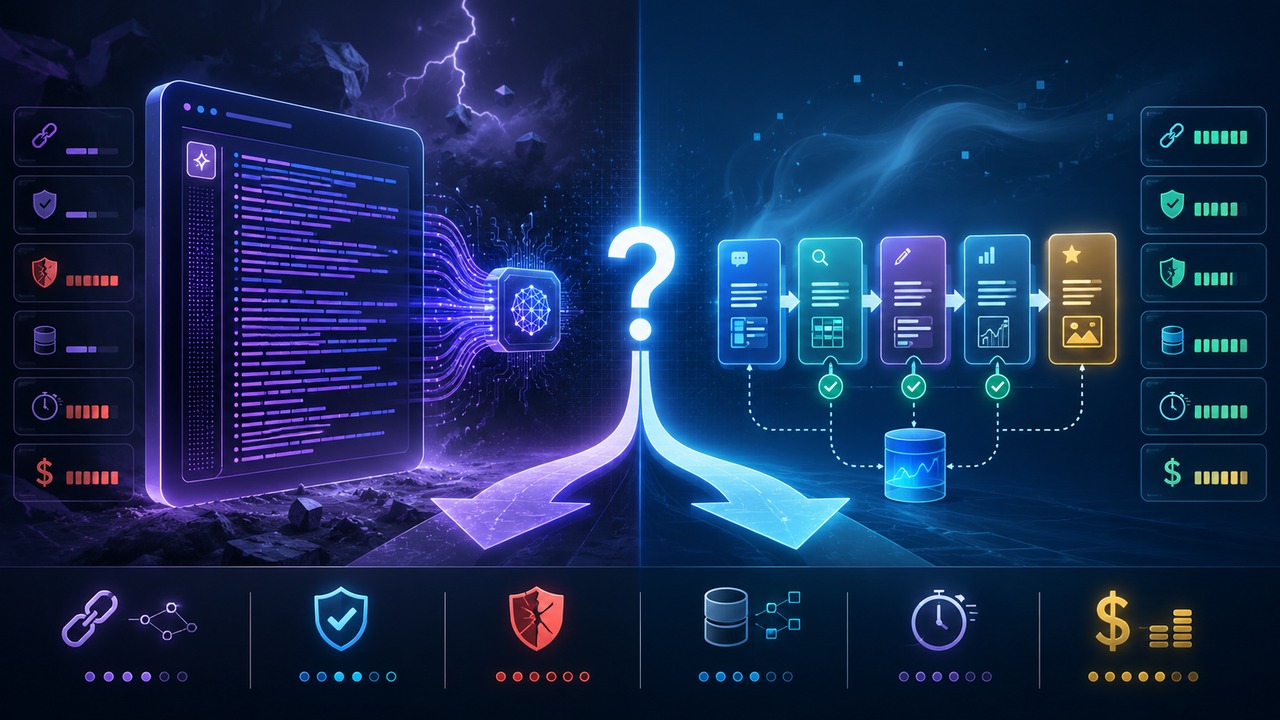
La elección entre mega-mensaje y encadenamiento de mensajes no debe comenzar con el tamaño del texto del mensaje. El criterio más útil es otro: ¿necesita el sistema controlar algo entre un paso y el siguiente? Si lo único que importa es la respuesta final y el modelo puede recibir todo el contexto relevante a la vez, una sola llamada suele ser el mejor punto de partida. Si un resultado intermedio necesita ser validado, registrado, transformado, aprobado, utilizado por una herramienta o capaz de cambiar el siguiente camino, separar el trabajo en llamadas crea valor arquitectónico.
Aquí, mega-prompt significa una única llamada que reúne objetivo, contexto, reglas, criterios y varias instrucciones de ejecución. Encadenamiento rápido significa una secuencia explícita de llamadas en las que la salida de un paso alimenta, restringe o condiciona el siguiente. Esto es diferente a pedirle al modelo que "piense paso a paso" dentro de la misma respuesta. El encadenamiento está en la aplicación y en el flujo entre llamadas; El razonamiento interno del modelo puede existir en cualquiera de las dos arquitecturas.
La complejidad por sí sola no requiere la creación de una cadena
Los modelos actuales pueden manejar tareas de planificación y de varios pasos dentro de una sola interacción, por lo que no existe una regla como "más de tres pasos requieren encadenamiento". La documentación actual de Anthropic dice que sus modelos recientes manejan gran parte del razonamiento de varios pasos internamente y reservan el encadenamiento explícito para situaciones en las que es importante inspeccionar resultados intermedios o hacer cumplir una estructura de canalización. La documentación de Google Cloud, por otro lado, destaca que dividir tareas complejas en subtareas puede aumentar la controlabilidad, la depuración y la precisión. Las dos orientaciones no son contradictorias: señalan el límite entre el razonamiento que puede permanecer dentro de la llamada y el control que debe existir fuera de ella.
La documentación de OpenAI sigue una lógica similar al recomendar que los flujos de trabajo complejos se evalúen según el éxito de la tarea, su integridad, la evidencia requerida, los tokens, la latencia y el costo. En otras palabras, no basta con contar las llamadas. Una arquitectura con menos llamadas puede ser peor si falla más; una arquitectura con más llamadas puede ser peor si simplemente repite el contexto y aumenta el tiempo sin crear un punto de control útil.
Dependencia entre etapas: la cuestión más importante
Si los pasos son solo partes de la misma elaboración, una sola llamada tiende a preservar mejor el contexto y evita el costo de transportar resultados intermedios. Imagine la tarea de escribir una respuesta técnica que deba considerar el objetivo, la audiencia, el tono y las limitaciones. Si bien podría describir esto como "analizar, planificar, escribir y revisar", estas fases pueden ser simplemente el proceso interno necesario para llegar a un resultado único. Es posible que convertirlas automáticamente en cuatro llamadas no agregue un control real.
El encadenamiento gana fuerza cuando el siguiente paso depende de un artefacto intermedio que debe existir explícitamente. Este es el caso de extraer entidades de documentos antes de consultar a un banco, clasificar una solicitud antes de elegir una herramienta, elaborar un plan antes de tomar acciones o generar un borrador que debe someterse a una verificación independiente. En estos casos, el resultado intermedio no es sólo pensamiento: se convierte en el estado del sistema.
Una forma sencilla de probar este límite es preguntar: si elimino la salida intermedia y dejo que el modelo resuelva todo de una vez, ¿pierdo la capacidad de tomar decisiones importantes? Si la respuesta es no, es probable que la cadena aún no se haya justificado. Si la respuesta es sí, la división ya está cumpliendo una función de ingeniería.
Validación: cuando un punto de control cambia la arquitectura
La validación es una de las razones más importantes para separar las llamadas. En un mega mensaje, se puede indicar al modelo que verifique su propio trabajo antes de responder, pero el software solo recibe el resultado al final. Esto puede ser suficiente cuando el error es barato, reversible y fácil de detectar más adelante.
En una cadena, el sistema puede requerir un contrato por etapa. Es posible que un extracto deba cumplir con un esquema antes de seguir adelante. Es posible que una calificación deba cumplir con una regla de confianza o someterse a revisión humana. Un borrador se puede comparar con criterios objetivos antes de la etapa de edición. La diferencia práctica es que el oleoducto puede detenerse, repetirse o cambiar de ruta antes de que el error se incorpore al producto final.
Este patrón también aparece en la recomendación de Anthropic de utilizar llamadas separadas para generar, revisar y refinar al grabar, evaluar o bifurcar en cualquier punto. La ganancia no proviene de un supuesto efecto mágico de "más indicaciones". Surge de la posibilidad de observar y gobernar lo que sucede entre ellos.
Aislamiento de fallos: las cadenas ayudan, pero también propagan errores
Un mega mensaje proporciona un único punto de error. Esto simplifica la operación y la observabilidad: hay una entrada, una respuesta y un resultado para evaluar. El problema es que, cuando la respuesta es incompleta, puede resultar difícil saber si la causa fue la interpretación.
objetivo, selección de evidencia, transformación de datos, formato o alguna combinación de estos factores.
Una cadena hace que el diagnóstico sea más local. Si la extracción es correcta y la clasificación es incorrecta, el error es más fácil de reproducir y corregir. También puedes repetir solo el paso problemático en lugar de volver a ejecutar todo el flujo.
Pero la modularidad no elimina los fallos; puede crear fallas en cascada. Una extracción deficiente alimenta una clasificación aparentemente consistente, que alimenta una recomendación aún más alejada de la fuente. Por lo tanto, una cadena útil no es sólo una secuencia de indicaciones. Necesita criterios de parada, validación del contrato y una decisión clara sobre qué hacer cuando un paso produce resultados insuficientes.
Estado: una llamada oculta el proceso, una cadena exterioriza partes del mismo
En la llamada única, gran parte del estado está implícito en el contexto recibido por el modelo. Esto es conveniente cuando el trabajo es corto y autónomo. En una cadena, el estado se convierte en un elemento de diseño: qué campos deben pasar por etapas, qué se debe descartar, qué se debe conservar y qué información se puede recalcular.
Esta externalización puede mejorar la trazabilidad y permitir la ramificación. Por ejemplo, un paso de clasificación podría derivar casos simples a una respuesta económica y casos complejos a un modelo, herramienta o ser humano más capaz. También permite reutilizar un resultado intermedio para más de un paso sin pedirle al modelo que lo genere nuevamente.
El riesgo es transformar toda la conversación en un estado permanente por conveniencia. Cuanta más historia se resienta innecesariamente, mayores serán las posibilidades de repetir instrucciones, aumentar las fichas y mezclar viejas decisiones con la tarea actual. Una buena cadena lleva el estado mínimo necesario, preferiblemente en un formato predecible y validable.
Latencia: los pasos secuenciales tienen un precio visible
Cada llamada secuencial crea otro período de espera entre la entrada y la salida. Para una interfaz interactiva donde el usuario espera una respuesta inmediata, este costo puede ser más importante que la mejora marginal del control. Si el trabajo se puede resolver en una sola llamada con calidad estable, dividirlo en cinco pasos tiende a alargar el tiempo para obtener el resultado.
No todas las descomposiciones necesitan ser secuenciales. La documentación de Google distingue el encadenamiento, en el que una salida alimenta la siguiente, de la agregación, en la que subtareas independientes pueden ejecutarse en paralelo y luego combinarse. Esta distinción es importante porque dos tareas independientes no deberían formar una cadena artificial sólo porque estén en el mismo flujo de trabajo.
Entonces, la pregunta correcta sobre la latencia no es "¿cuántos pasos hay?", sino "¿cuántas dependencias realmente es necesario serializar?". Cualquier cosa que se pueda hacer en paralelo puede reducir el tiempo de construcción; Todo lo que deba esperar la validación inevitablemente agregará latencia a cambio de control.
Coste: más llamadas no significa automáticamente más caras o más baratas
Es fácil suponer que una sola llamada siempre cuesta menos, pero el total depende de cuánto contexto recibe cada paso, cuánto texto intermedio se genera, qué plantillas se utilizan, cuánto trabajo debe repetirse y cuántas fallas requieren reintentos. Una cadena mal diseñada puede reenviar el mismo contexto varias veces y pagar por productos intermedios que no agregan valor. Una cadena bien diseñada puede utilizar un modelo pequeño para tareas sencillas, reservar un modelo más caro para un paso difícil y evitar reejecuciones completas cuando algo falla.
La pauta más segura es medir el costo por tarea completada con éxito, no el costo por llamada. La propia documentación actual de OpenAI recomienda comparar el total de tokens, latencia, costo, llamadas, turnos y reintentos junto con la calidad final. Esta forma de medir evita optimizaciones que parecen eficientes en el contador de solicitudes, pero producen más errores o más trabajo correctivo.
Mismo problema en una llamada y en una cadena
Considere un sistema que recibe docenas de comentarios de clientes y necesita ofrecer un plan de mejora priorizado.
Versión mega-prompt
En una sola llamada se reciben comentarios e instrucciones completas: identificar problemas recurrentes, agrupar temas, estimar impacto, priorizar acciones y redactar el plan final. Esta arquitectura puede funcionar muy bien cuando el volumen se ajusta al contexto, no es necesario reutilizar la taxonomía y nadie necesita aprobar las agrupaciones antes de la recomendación. El beneficio es la simplicidad: una solicitud, un conjunto de instrucciones y una respuesta final.
El punto débil aparece cuando el plan sale mal. Puede resultar difícil separar si el error comenzó en la extracción, la agrupación, la prioridad o la redacción del problema. Tampoco tiene sentido reutilizar temas extraídos en otro proceso.
Versión de solicitud de encadenamiento
En la primera llamada, el modelo extrae problemas y evidencia de cada comentario en un formato estructurado.. El software valida el formato y rechaza registros incompletos. En la segunda convocatoria se agrupan y clasifican los problemas validados. En el tercero, el sistema aplica reglas de prioridad o solicita revisión humana para casos límite. Sólo entonces una convocatoria final transforma los datos aprobados en un plan de acción legible.
La cadena es más grande, pero cada límite tiene una función: validar datos, aislar errores, guardar estado o autorizar el siguiente paso. Si estas funciones no son necesarias, la misma descomposición puede ser simplemente burocracia computacional.
Lo que muestra la investigación y lo que aún no nos permite concluir
Un trabajo publicado en 2024 Findings of ACL comparó dos formas de perfeccionar el resumen. En el encadenamiento de mensajes, el borrador, la crítica y la revisión se realizaron en tres convocatorias separadas. En el llamado mensaje paso a paso, las mismas fases
fueron solicitados dentro de una sola generación. En el experimento principal, la estrategia de encadenamiento logró la mayor cantidad de victorias en comparaciones de calidad, incluidas 77 victorias de 100 comparaciones informadas. Los propios autores limitan la conclusión al escenario de resumen estudiado y piden validación en otras tareas.
Este detalle es importante porque evita transformar un resultado específico en una ley general. El estudio muestra que separar la generación, la crítica y la revisión puede producir beneficios reales bajo ciertas condiciones. No demuestra que cualquier tarea compleja sea mejor si se divide en varias llamadas.
Una preimpresión de 2026 sobre la generación automatizada de informes académicos llegó a una conclusión favorable al encadenamiento en su caso de uso: la canalización de varios pasos se comparó con una línea base optimizada de un solo disparo y mostró una mayor confiabilidad y una mejora menor en la métrica de similitud textual utilizada. Debido a que se trata de una evaluación y un estudio de caso limitado y de un dominio específico, sirve como evidencia de que la arquitectura puede marcar la diferencia, no como un punto de referencia universal.
En otra dirección, la investigación de 2026 sobre flujos de trabajo de múltiples agentes refuerza una advertencia útil: más componentes no garantizan un mejor resultado. Un estudio con siete puntos de referencia demostró que, en flujos de trabajo homogéneos, un único modelo que ejecuta descomposición de múltiples rondas podría igualar el rendimiento de configuraciones de múltiples agentes a un costo menor en su entorno. La lección del encadenamiento rápido es que descomponer la tarea y multiplicar los ejecutores son decisiones diferentes. A veces sólo necesitas ceñirte a un único modelo y hacer explícitos los pasos.
Un método práctico para decidir sin dogmas
Comience con la arquitectura más pequeña que pase su prueba
Primero organice una única convocatoria con un objetivo, contexto, limitaciones, criterios de éxito y formato de salida claros. Realizar una evaluación con casos representativos. Si ofrece el resultado con suficiente coherencia, la simplicidad es una ventaja real: menos puntos de error, menos estado y menos latencia de orquestación.
Dividir en el punto exacto donde aparece la necesidad de control
Cuando los errores muestran un patrón, busque el límite. Es posible que sea necesario validar la extracción antes de la generación. Quizás sea necesario realizar una búsqueda solo después de clasificar la intención. Quizás un humano necesite aprobar una decisión antes de utilizar una herramienta. Es dentro de este límite donde una nueva etapa suele amortizarse sola.
Dar un contrato en cada etapa
Un paso sin criterios propios es difícil de probar. Defina qué entra, qué debe salir, qué campos son obligatorios, qué evidencia debe preservarse y qué caracteriza el fracaso. Cuanto más clara sea esta interfaz, menos posibilidades habrá de que la cadena se convierta en una sola conversación larga fragmentada en varias solicitudes.
Mida todo el sistema
Compare la tasa de éxito, la integridad, los errores por paso, los reintentos, la latencia de un extremo a otro, los tokens y el costo por tarea exitosa. Si la cadena aumenta la calidad pero duplica la latencia en un producto urgente, es posible que deba reducir los pasos. Si un
una sola llamada es económica, pero requiere muchas correcciones, el costo operativo puede estar oculto fuera de la API.
La regla del bolsillo
Mantenga una única llamada cuando la tarea sea una transacción conceptualmente única: se puede proporcionar todo el contexto a la vez, solo es necesario consumir el resultado final y no hay ninguna decisión externa importante en el medio del camino.
Utilice el encadenamiento de mensajes cuando sea necesario que existan límites entre los pasos del software: validar, bifurcar, registrar, reutilizar, llamar a herramientas, cambiar modelos, solicitar aprobación o repetir solo una parte del trabajo.
La diferencia central no es "un mensaje corto versus un mensaje largo". Es razonamiento interno versus arquitectura externa. El megamensaje permite que el modelo coordine el proceso dentro de una llamada. La cadena transforma partes de este proceso en estados observables y controlables. La elección correcta es aquella que ofrece la calidad necesaria con el nivel más bajo de orquestación que sus pruebas puedan justificar.