Si todavía comienza toda configuración de generación con temperature = 0 para "garantizar determinismo", es hora de revisar la receta. En 2026, temperature, top_p y top_k ya no forman un panel universal que funcione igual en cualquier API. En algunos modelos, siguen disponibles. En otros, se aceptan solo en combinaciones específicas. En los modelos más nuevos de Claude y Gemini, los valores no predeterminados fueron descontinuados o eliminados de la ruta recomendada.
El cambio más importante es este: la presencia de un campo en la referencia general de una API no garantiza que ese campo sea aceptado por el modelo que eligió. Hoy, el contrato relevante es la combinación entre proveedor, modelo, endpoint y modo de razonamiento. La documentación oficial consultada el 29 de agosto de 2026 deja claro este patrón.
La respuesta corta: sampling dejó de ser el control principal
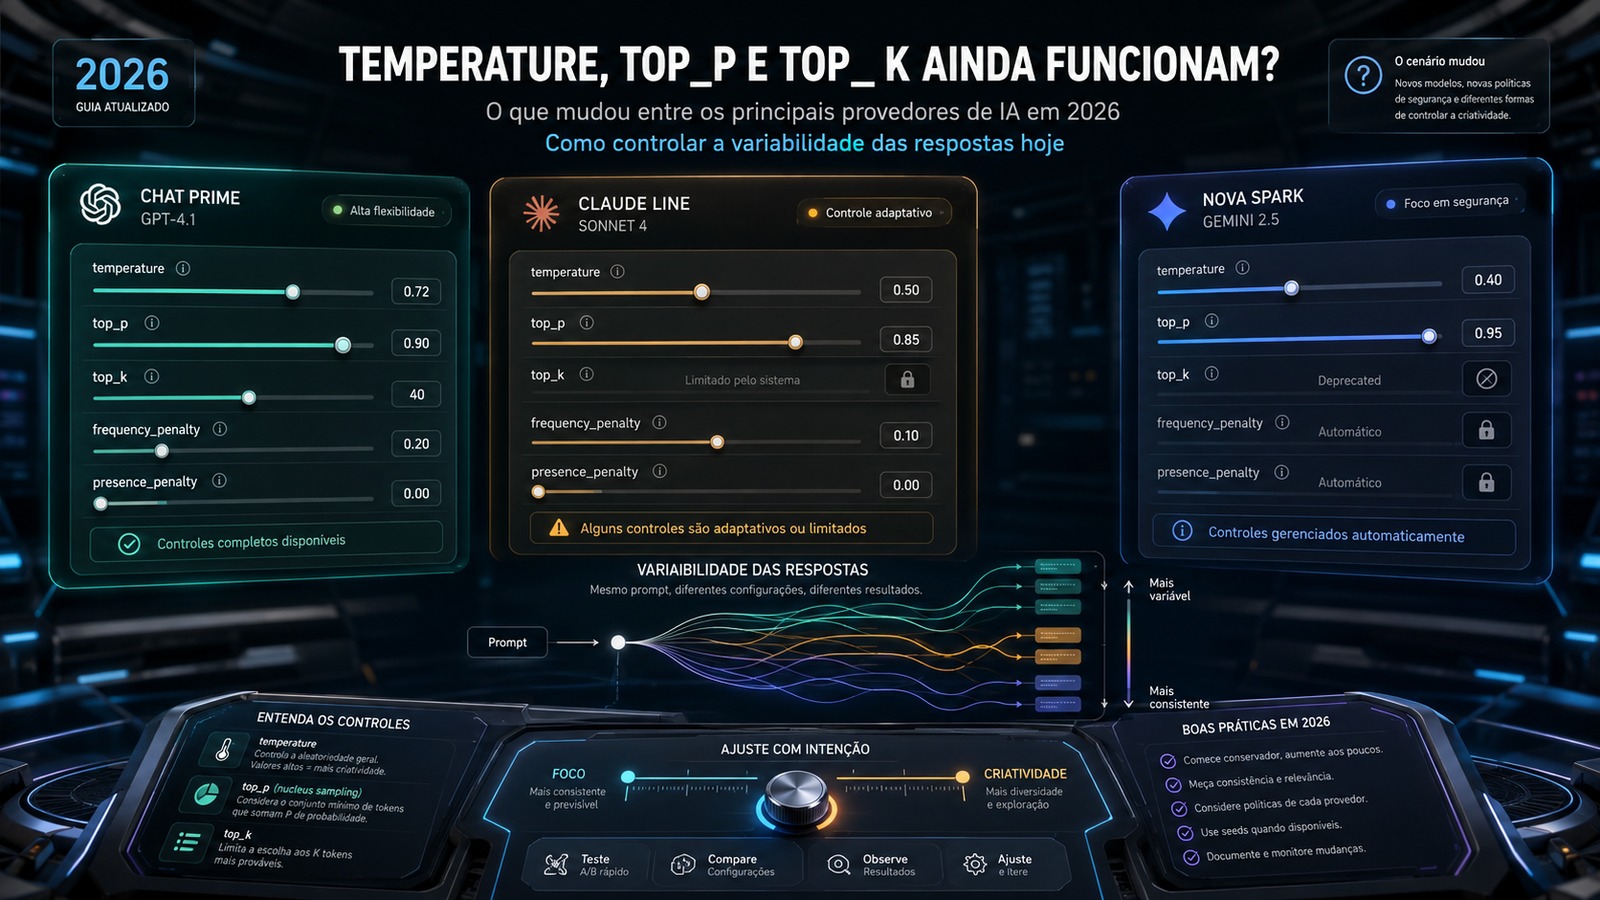
Temperature sigue siendo un concepto válido: modifica la distribución usada para elegir el siguiente token y, en interfaces que aún exponen el parámetro, los valores más bajos tienden a concentrar la generación en opciones de mayor probabilidad. Top_p aplica nucleus sampling, limitando la elección al conjunto de tokens cuya masa de probabilidad acumulada alcanza el valor configurado. Top_k limita la elección a los K tokens más probables cuando el modelo y la API ofrecen ese mecanismo.
El problema no está en los conceptos. El problema es tratarlos como una capa de control portátil entre modelos. OpenAI aún expone temperature y top_p en la referencia general de la Responses API, pero su propia documentación muestra restricciones por modelo y por reasoning effort. Anthropic pasó a rechazar valores no predeterminados de estos parámetros en los Claude más nuevos. Google indica eliminar temperature, top_p y top_k al migrar a los Gemini 3.x más recientes.
En la práctica, los controles que ganaron importancia en 2026 son reasoning effort, effort, thinking level, instrucciones de formato, structured outputs, límite de salida, selección de herramientas y pruebas de regresión. No son sustitutos matemáticos de temperature, pero son los controles que los proveedores están ofreciendo para gobernar comportamiento, profundidad, costo, formato y
consistencia.
OpenAI: temperature y top_p existen, pero la compatibilidad depende del modelo
La referencia general de la Responses API todavía documenta temperature entre 0 y 2 y top_p entre 0 y 1. OpenAI sigue recomendando modificar uno u otro, no ambos al mismo tiempo, cuando el modelo realmente admite esos campos. Top_k, en cambio, no aparece como parámetro de muestreo en la interfaz estándar de Responses o Chat Completions.
El punto decisivo es la compatibilidad del modelo. En la guía de GPT-5.2, OpenAI afirma que temperature, top_p y logprobs solo son compatibles cuando reasoning effort está en none. La misma guía informa que las solicitudes con esos campos en otros niveles de reasoning effort generan un error, y también registra incompatibilidades en modelos anteriores de la familia GPT-5.
Eso vuelve peligrosa la regla "la API tiene temperature, por lo tanto mi modelo acepta temperature". El schema general describe posibilidades de la API; la página del modelo y la guía de migración dicen qué admite esa combinación específica.
GPT-4.1: el escenario clásico todavía existe
GPT-4.1 sigue listado como un modelo sin etapa de reasoning y es compatible con Responses y Chat Completions. En este tipo de modelo, temperature y top_p siguen alineados con el uso clásico descrito por la API. Para aplicaciones que necesitan precisamente un modelo sin reasoning con control de muestreo tradicional, este es el tipo de combinación en el que la receta antigua todavía tiene sentido. Top_k no forma parte de ese conjunto de parámetros estándar de OpenAI.
GPT-5.2: temperature y top_p quedan condicionados al reasoning
En GPT-5.2, la regla oficial es explícita: temperature y top_p solo entran cuando reasoning effort está en none. Si aumenta el esfuerzo de razonamiento y mantiene esos campos, la solicitud puede fallar en lugar de simplemente "volverse menos creativa". Esta diferencia es importante operativamente porque transforma un ajuste que antes parecía continuo en una restricción de compatibilidad.
GPT-5.6: el control del comportamiento migró a otros ejes
La familia GPT-5.6 es la línea actual de OpenAI en agosto de 2026. La guía de uso destaca reasoning.effort con niveles de none a max, reasoning.mode para el modo pro y text.verbosity para controlar el nivel de detalle. La orientación de migración también enfatiza probar configuraciones en tareas representativas en vez de asumir que más reasoning siempre mejora el resultado.
Al mismo tiempo, la referencia general de la Responses API sigue conteniendo temperature y top_p. Como la documentación actual separa el schema general de la compatibilidad específica del modelo, el procedimiento seguro es no trasladar una configuración antigua por inercia. Verifique la página del modelo, el endpoint y el reasoning effort usados en su aplicación y haga una llamada de validación antes de considerar el parámetro parte del contrato de producción.
Claude: en los modelos nuevos, omita temperature, top_p y top_k
El cambio de Anthropic es más directo. La referencia actual de la Messages API marca temperature, top_p y top_k como deprecated. Para modelos lanzados después de Claude Opus 4.6, la documentación informa que estos controles dejaron de ser ajustables de la forma tradicional.
Por compatibilidad retroactiva, temperature con el valor predeterminado 1.0 puede aceptarse en algunas rutas, y top_p con un valor cercano al predeterminado también puede pasar. Eso no significa que todavía tenga un control útil de aleatoriedad. En Claude Sonnet 5, la documentación de migración es más clara: configurar temperature, top_p o top_k con valores no predeterminados devuelve un
error 400. La recomendación es retirar esos campos del payload.
El mismo movimiento aparece en la documentación de uso del Claude actual: en modelos con adaptive thinking, effort es el control recomendado para ajustar cuánto trabajo dedica el modelo a la respuesta. En Claude Sonnet 5, effort high es el valor predeterminado; los niveles medium y low reducen gasto y profundidad, mientras que xhigh y max reservan más capacidad para tareas difíciles. En Claude Opus 5, Anthropic también trata effort como control principal.
Esto cambia el significado de "quiero menos variación". Reducir effort no equivale a bajar temperature. Effort modifica el trabajo total de la respuesta, incluido thinking y, en determinados flujos, llamadas a herramientas. Para consistencia de forma y contenido, Anthropic recomienda combinar prompting más explícito con structured outputs cuando la salida debe obedecer a un schema.
Gemini: los 3.x abandonan los knobs clásicos, mientras 2.5 todavía convive con el modelo anterior
Google realizó una transición visible en 2026. Las notas de versión de la Gemini API registraron el 21 de julio la deprecación de temperature, top_p y top_k. La guía de Gemini 3.7 Flash, vigente en agosto, ordena eliminar esos tres parámetros de la configuración de generación. La misma guía observa que Gemini 3.6 Flash ya no los admitía.
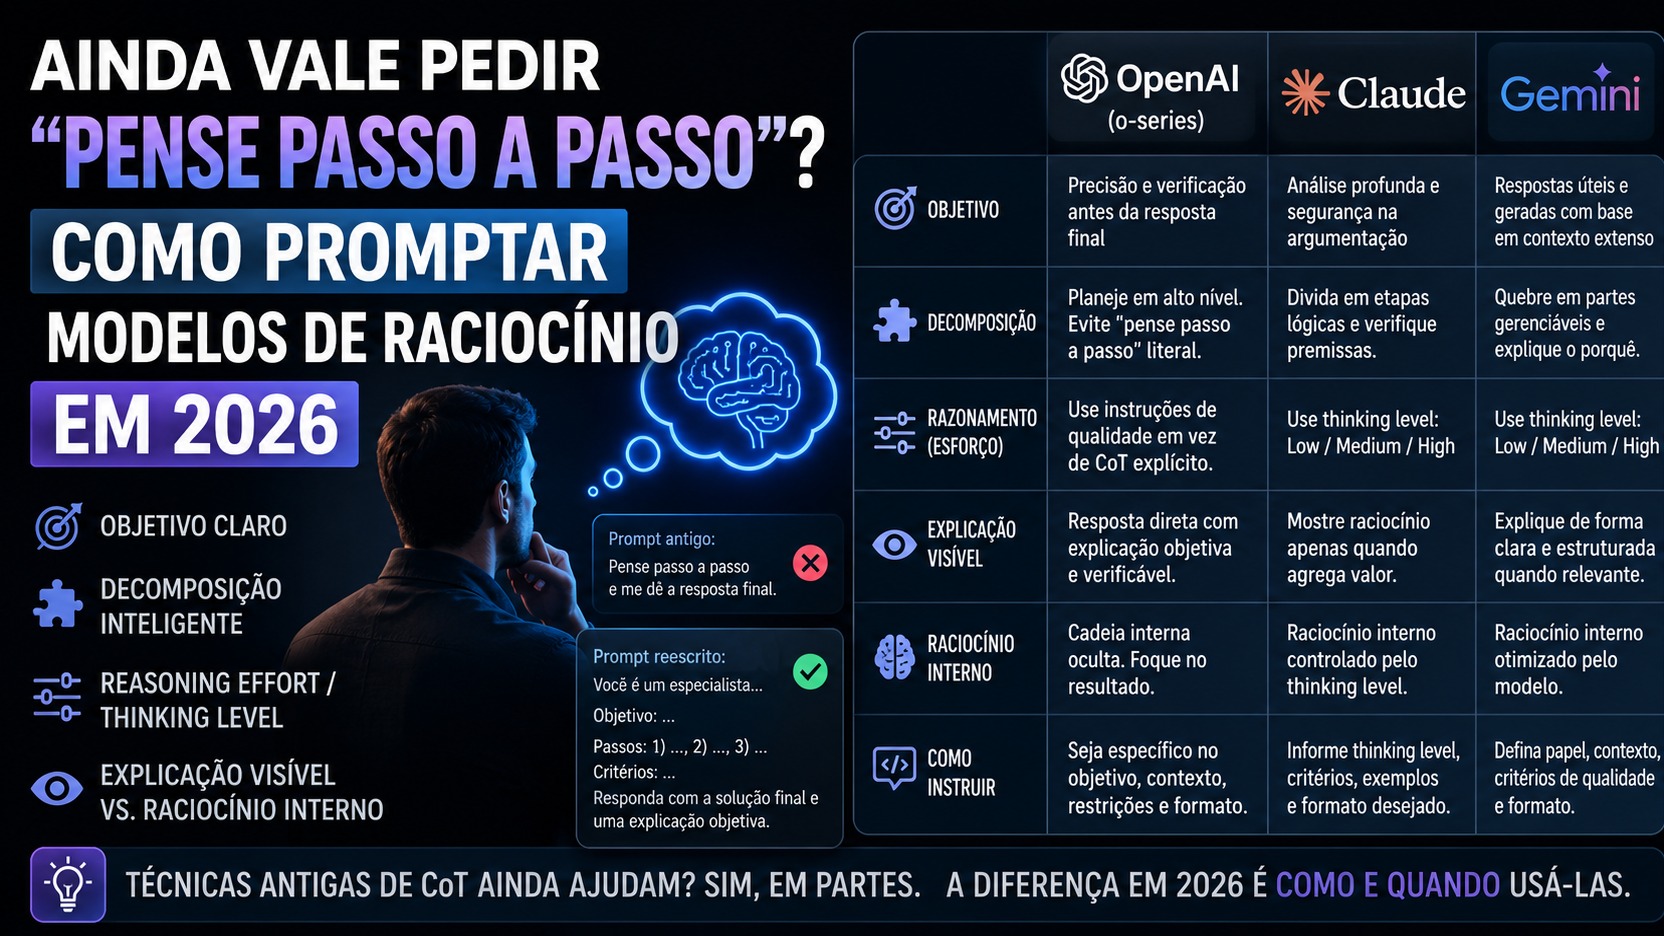
El sustituto conductual central en la línea 3.x es thinking_level. En Gemini 3.7 Flash, los niveles disponibles son low, medium y high, con medium como valor predeterminado en la documentación actual. Al igual que effort en Claude y reasoning.effort en OpenAI, este control gobierna la cantidad relativa de razonamiento, no la aleatoriedad token a token.
Hay un matiz importante para el código heredado. Gemini 2.5 Pro y Gemini 2.5 Flash siguen activos, sin fecha de cierre anunciada en la página de deprecaciones consultada. La referencia general de generación todavía describe temperature, topP, topK y seed para los modelos que admiten esos campos. Por eso, un payload que funciona en Gemini 2.5 puede necesitar perder parámetros cuando se migra a Gemini 3.6 o 3.7.
Esta convivencia explica por qué ejemplos antiguos encontrados en búsquedas todavía pueden parecer correctos. Pueden ser correctos para otra generación de modelo o para un endpoint heredado, pero incorrectos para la línea 3.x actual. Al migrar, siga la página del modelo de destino y la guía de migración, no solo un ejemplo genérico del SDK.
Qué significan en la práctica "aceptado", "restringido" y
"descontinuado" Aceptado significa que el modelo documenta el parámetro como parte normal de la solicitud y que cambiar su valor es una operación prevista. Restringido significa que el campo existe, pero solo funciona en determinadas combinaciones, como temperature y top_p en GPT-5.2 con reasoning effort en none. Descontinuado significa que el proveedor quiere que deje de depender del parámetro; en Claude Sonnet 5, los valores no predeterminados generan un error, y en los Gemini 3.x actuales la orientación es eliminar los campos.
Existe además un cuarto estado que suele confundir las integraciones: aceptado solo por compatibilidad. Un valor predeterminado puede tolerarse para no romper payloads antiguos, pero sin ofrecer control real. Cuando ocurre eso, dejar el campo en el JSON es peor que eliminarlo, porque transmite la impresión de que su aplicación está gobernando un comportamiento que el modelo ya controla internamente.
Cómo controlar la variabilidad ahora
El primer cambio es separar tres problemas que antes se cargaban a la cuenta de temperature: profundidad de razonamiento, formato de la respuesta y diversidad semántica. Son problemas distintos y necesitan controles distintos.
Fije el modelo, la versión y la ruta de API
Si mide consistencia, registre el ID exacto del modelo y el endpoint. Cuando el proveedor ofrezca snapshot o versión fija, úselo en la prueba. OpenAI documenta snapshots como forma de mantener una versión específica del modelo. Anthropic informa que los IDs de Claude a partir de la generación 4.6 identifican versiones fijas durante la vida de ese ID. Evite comparar una ejecución de hoy con otra realizada semanas después usando un alias que puede apuntar a un comportamiento actualizado sin registrar el cambio.
Use el control de reasoning o thinking para lo que realmente hace
En OpenAI, reasoning.effort modifica la profundidad de razonamiento de los modelos que admiten ese mecanismo. En Claude, effort es la señal recomendada para ajustar el trabajo total y la profundidad de thinking en los modelos actuales. En Gemini 3.x, thinking_level controla la intensidad relativa del razonamiento.
Estos parámetros son más útiles para decidir costo, latencia y capacidad que para producir "la misma frase cada vez". Si la tarea es una clasificación simple, reducir el esfuerzo puede disminuir caminos innecesarios. Si la tarea es un análisis complejo, reducirlo demasiado puede aumentar los errores. La elección debe surgir de la evaluación, no de una equivalencia imaginaria con temperature.
Bloquee la estructura de la salida
Si su problema es "cada respuesta llega en un formato diferente", structured outputs suele ser un control más fuerte que sampling. OpenAI, Claude y Gemini ofrecen mecanismos actuales para restringir la salida a un schema. Esto no garantiza que el contenido semántico sea idéntico, pero reduce la variación de claves, tipos, orden lógico y formato de datos.
Para extracción, clasificación e integración con sistemas, este cambio es especialmente importante. En lugar de intentar obtener JSON estable solo bajando temperature, declare el schema y valide el resultado.
Especifique criterios, no solo estilo
Los prompts consistentes describen lo que debe permanecer invariable. Defina alcance, formato, campos obligatorios, condiciones de parada, cómo tratar la ausencia de información y qué decisiones están permitidas. Si el modelo debe elegir entre categorías, proporcione las categorías. Si debe devolver una conclusión y dos evidencias, dígalo. Si debe evitar inferencias, defina cómo representar la información ausente.
Un prompt con criterios comprobables reduce la libertad donde estorba sin intentar eliminar toda la flexibilidad del modelo.
Controle herramientas y contexto
En agentes, buena parte de la variación no nace del sampling. Nace de resultados de búsqueda distintos, orden de herramientas, datos que cambiaron, historial de conversación, caché, llamadas paralelas y decisiones intermedias. Si compara dos configuraciones, mantenga constantes las herramientas, el contexto y los datos de entrada o registre las diferencias.
Esto también explica por qué temperature = 0 nunca fue una garantía completa de reproducibilidad. La propia Anthropic observa que temperature 0 no vuelve el resultado totalmente determinista en los
modelos en los que el parámetro todavía existía. En sistemas con herramientas y razonamiento, hay aún más fuentes de variación además de la elección local de tokens.
Use seed solo cuando el modelo y el endpoint realmente ofrezcan ese recurso
La documentación de Google todavía describe seed en superficies que admiten ese campo y señala que la salida puede volverse más reproducible, pero no absolutamente determinista. Seed es útil para pruebas cuando está disponible, pero no es un estándar portátil entre OpenAI, Claude y Gemini y no sustituye el versionado, el control de contexto y la evaluación repetida.
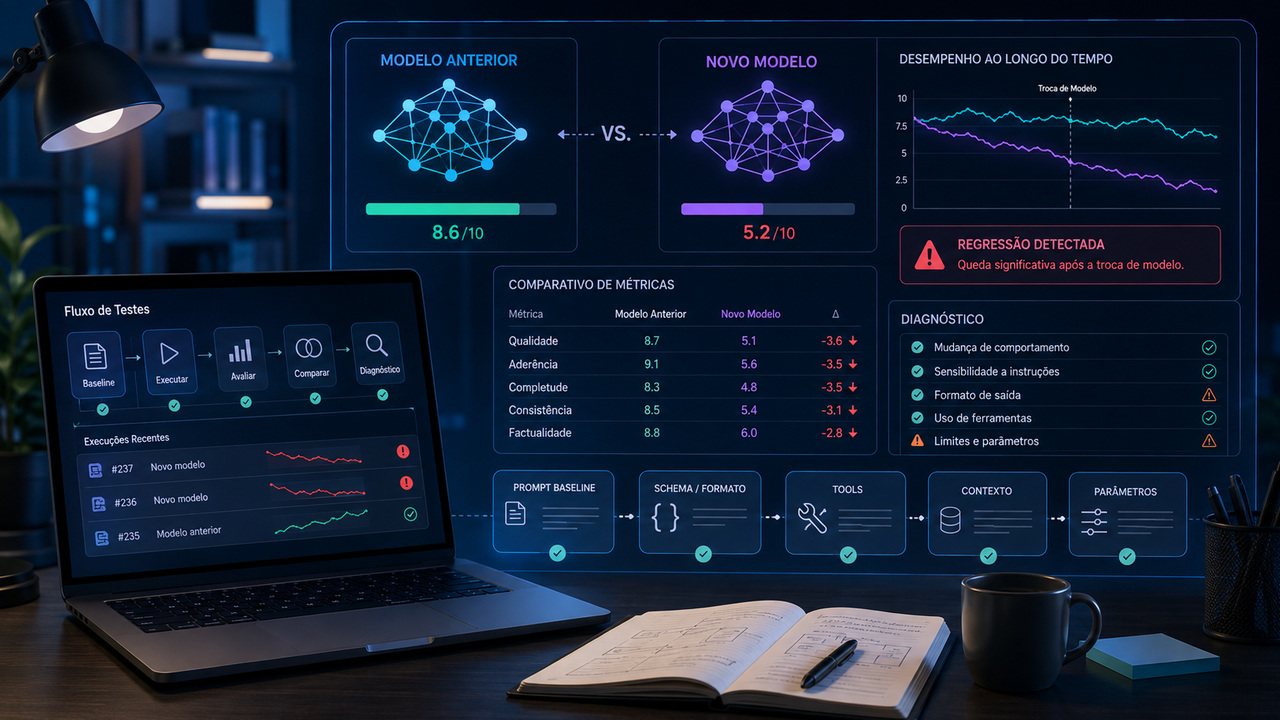
Una prueba reproducible para saber si su configuración realmente se volvió más consistente
La forma más segura de decidir entre parámetros es medir el comportamiento de su propia tarea. La prueba siguiente no depende de creer que un valor "bajo" es automáticamente mejor.
Defina un caso de prueba cerrado
Elija una tarea representativa y mantenga fija la entrada. Un buen ejemplo es pedir la clasificación de un texto en una de cinco categorías, con una justificación breve y salida estructurada. Registre el prompt de sistema, el prompt del usuario, el contexto, las herramientas disponibles, el schema, el límite de tokens, el modelo, el endpoint y los controles de reasoning o thinking.
Ejecute una línea base repetida
Ejecute la misma configuración al menos veinte veces. Guarde la respuesta bruta, el uso de tokens, la latencia, las llamadas a herramientas y cualquier error de API. Si existe un seed documentado para ese modelo, registre también el valor utilizado.
La métrica principal no tiene que ser "texto idéntico". Para clasificación, mida la tasa de concordancia de la categoría. Para extracción, mida la validez del schema y la igualdad de los campos. Para texto libre, evalúe la presencia de la información obligatoria, la longitud y las divergencias semánticas relevantes.
Cambie una variable por vez
Cambie solo un elemento: reasoning effort, effort, thinking level, modelo, prompt o structured output. No cambie el modelo y el prompt al mismo tiempo. Si la API todavía ofrece temperature o top_p en ese modelo, pruebe uno por vez, siguiendo la recomendación del proveedor de no ajustar ambos simultáneamente sin necesidad.
Después repita las ejecuciones y compare. El objetivo es descubrir qué configuración ofrece la mejor combinación de acierto, consistencia, latencia y costo para su caso, no encontrar un número mágico.
Trate el error de parámetro como resultado de la prueba
En 2026, un 400 causado por temperature, top_p o top_k es información útil: muestra que su configuración está acoplada a una generación de modelo distinta. Su prueba de compatibilidad debe fallar pronto en el despliegue cuando un campo deja de ser aceptado, en lugar de conservar silenciosamente un parámetro sin efecto.
Por qué "temperature = 0" se volvió una recomendación incompleta
La frase sigue siendo útil en modelos que realmente exponen temperature y cuando el objetivo es reducir la diversidad del muestreo. El error es convertirla en sinónimo de determinismo, calidad o consistencia operativa.
El determinismo depende de más cosas: versión del modelo, infraestructura, contexto, herramientas,
datos recuperados, reasoning, formato de salida y posibles actualizaciones del backend. Además, los proveedores actuales están desplazando el control de comportamiento hacia parámetros que no existen en la antigua receta de sampling.
En un modelo moderno, la mejor configuración puede ser no enviar temperature, usar reasoning o thinking en el nivel adecuado, exigir structured output, limitar la salida y ejecutar evals. En otro modelo, temperature todavía puede ser legítimo. La decisión ahora comienza por la compatibilidad documentada del modelo, no por el valor numérico del parámetro.
Regla de migración para no romper su aplicación
Al cambiar de modelo, preserve primero el prompt y el caso de prueba; después, revise el payload contra la documentación específica del destino. Elimine parámetros descontinuados, fije explícitamente el nuevo control de reasoning o thinking cuando eso afecte costo y comportamiento, mantenga el mismo schema de salida y ejecute la suite de evaluación antes de ajustar el texto del prompt.
En OpenAI, no suponga que un campo disponible en la Responses API funciona en todos los GPT con cualquier reasoning effort. En el Claude actual, retire temperature, top_p y top_k de los modelos nuevos y trabaje con effort, prompting y structured outputs. En Gemini 3.x, siga la migración a thinking_level y elimine los tres sampling controls clásicos. Si permanece en Gemini 2.5 o en un modelo sin reasoning más antiguo, documente esa dependencia para que la próxima migración no sea una sorpresa.
El control moderno es por contrato, no por superstición de parámetros
Temperature, top_p y top_k no desaparecieron de la teoría de generación, pero perdieron el estatus de knobs universales de producto. La práctica de 2026 es más específica: confirme qué acepta el modelo, use el control de reasoning o thinking apropiado, imponga estructura cuando la salida deba ser predecible y mida repetidamente la tarea real.
Si necesita consistencia, la pregunta más útil dejó de ser "¿qué temperature debo usar?" y pasó a ser "¿qué combinación de modelo, versión, razonamiento, formato, contexto y prueba mantiene el comportamiento dentro de la variación que mi producto tolera?". Esa pregunta sigue siendo válida incluso cuando el proveedor decide eliminar el próximo parámetro de la API.