La frase "pensar paso a paso" se ha convertido en uno de los atajos más famosos de la ingeniería rápida. En 2022, los estudios de Chain of Thought demostraron que inducir modelos grandes para producir pasos intermedios podría mejorar las tareas de razonamiento aritmético, lógico y simbólico. El efecto fue tan llamativo que la expresión acabó siendo tratada como una especie de botón de inteligencia universal.
En 2026, es necesario revisar este hábito. Los principales proveedores ofrecen ahora modelos que ya realizan razonamiento interno antes de responder y, en muchos casos, también exponen sus propios controles para decidir cuánto esfuerzo computacional utilizar. La consecuencia práctica es importante: escribir un guión "pensado" detallado cuando se le solicita ya no es el mejor punto de partida para muchas tareas.
Esto no significa que la descomposición, verificación o explicación hayan perdido valor. Significa que ahora deben usarse por el motivo correcto. La indicación debe indicar claramente qué es necesario resolver, qué limitaciones importan, qué evidencia se necesita y cómo se debe presentar la respuesta. La cantidad de razonamiento, cuando la API lo permite, se convierte en un control independiente.
“Pensar paso a paso” no está muerto; rol cambiado
La clásica Cadena de Pensamiento nació en una generación de modelos diferente a la actual. El trabajo de Jason Wei y sus coautores demostró que los ejemplos con pasos intermedios podrían mejorar el rendimiento de modelos grandes en problemas que requerían múltiples inferencias. Poco después, Takeshi Kojima y sus coautores popularizaron Zero-shot-CoT observando mejoras en varios puntos de referencia simplemente añadiendo una instrucción equivalente a "pensemos paso a paso".
Estos resultados fueron reales dentro de las condiciones estudiadas, pero no crearon una ley permanente de motivación. Mostraron cómo se podía inducir a ciertos modelos de esa época a utilizar mejor su capacidad latente. Hoy en día, parte de este comportamiento se ha incorporado al proceso de inferir modelos de razonamiento.
Así que la pregunta útil en 2026 no es “¿Funciona o no la CoT?” La pregunta es: “¿Qué parte del
El problema debe permanecer en el mensaje, ¿qué parte debe estar en el control de razonamiento/pensamiento de la API y qué parte debe aparecerle al usuario?
Qué ha cambiado en los modelos de razonamiento
Una forma práctica de pensar en las indicaciones actuales es separar tres capas que solían estar mezcladas.
La primera capa es la especificación de la tarea. Incluye objetivo, contexto, limitaciones, datos disponibles, criterios de éxito y formato de salida. Esta capa sigue siendo responsabilidad del aviso. Cuanto más ambigua sea la tarea, más importante es hacerla explícita.
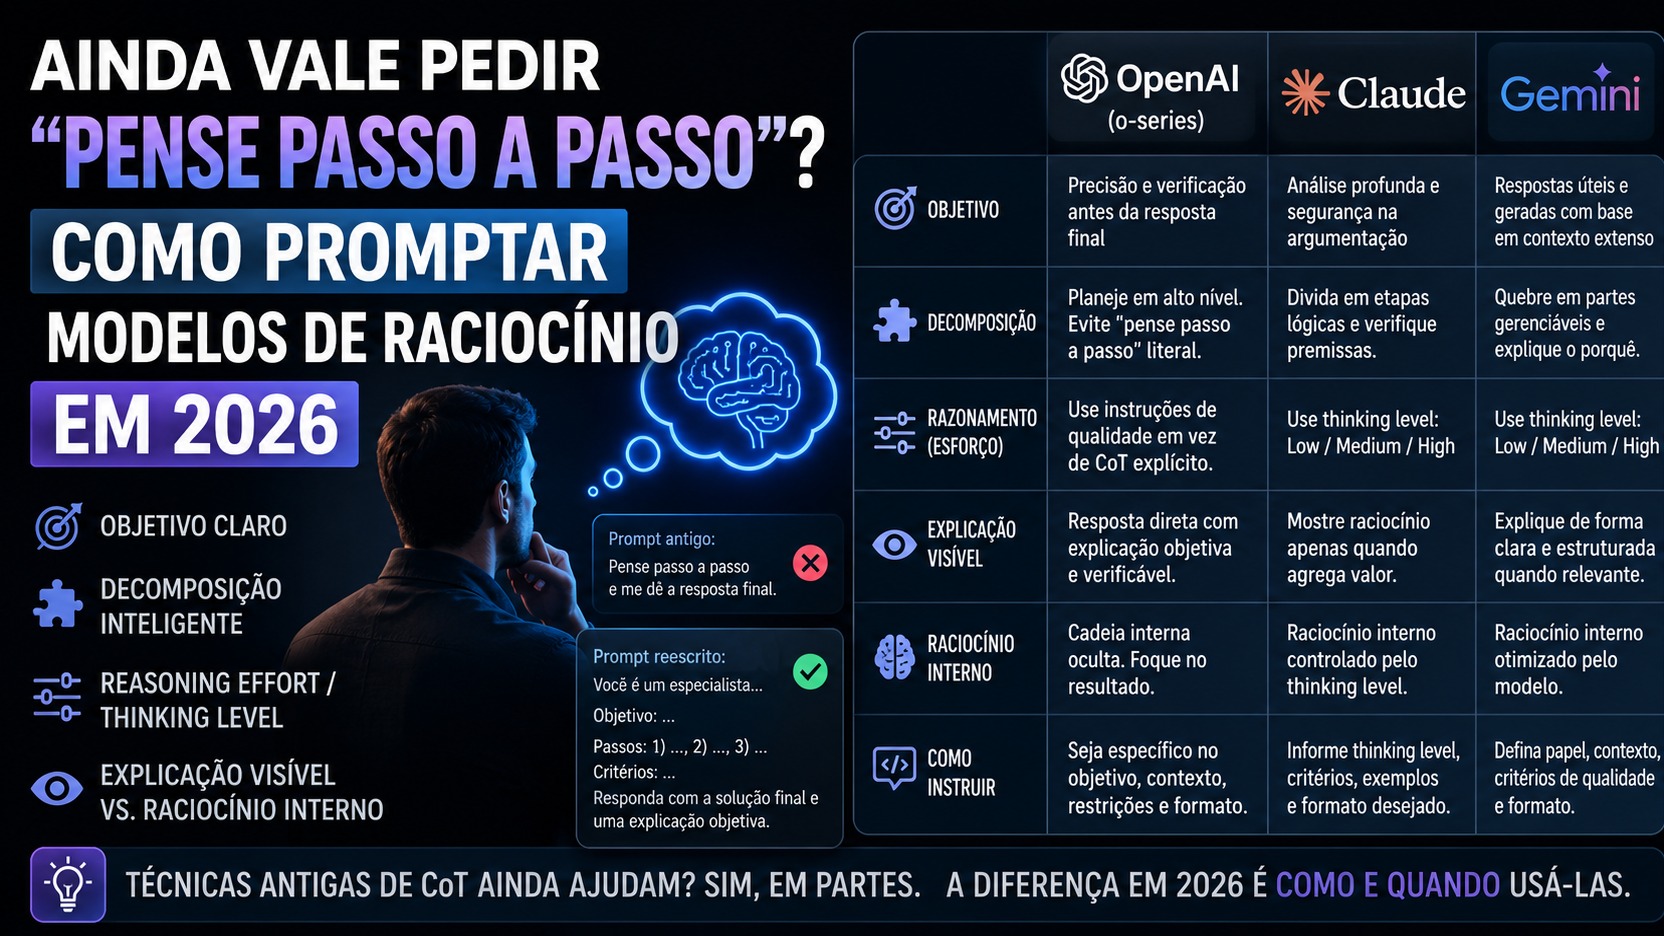
La segunda capa es el razonamiento de asignación. En varias API actuales, esto se puede controlar mediante parámetros como el esfuerzo de razonamiento, el esfuerzo o el nivel de pensamiento. Este control determina cuánto trabajo interno puede dedicar el modelo antes o durante la producción de la respuesta. Reemplaza, en parte, el viejo impulso de intentar “forzar” la profundidad repitiendo instrucciones como “pensar más”, “reflexionar” o “revisar varias veces”.
La tercera capa es la explicación visible. Una buena explicación no tiene por qué ser una transcripción de un razonamiento interno.. Para la mayoría de los productos, es más útil solicitar una justificación verificable: supuestos utilizados, cálculos esenciales, evidencia, limitaciones, criterios de decisión y conclusión. Esto produce resultados auditables sin depender de una cadena interna completa.
Esta separación resuelve una confusión recurrente. "Quiero que el modelo razone mejor" y "Quiero que el usuario comprenda por qué la respuesta tiene sentido" son objetivos diferentes. El primero puede ser manejado por el modelo y la API; el segundo debe especificarse en la salida.
Matriz práctica: OpenAI, Claude y Gemini
Los tres ecosistemas se han movido en la misma dirección general (más razonamiento interno y más controles de inferencia), pero no utilizan la misma interfaz. Copiar los mismos mensajes y parámetros entre proveedores es una estrategia frágil.
OpenAI: objetivo y criterios en aviso, esfuerzo en API
La guía oficial de OpenAI para modelos de razonamiento es sencilla: indicaciones simples y claras tienden a funcionar mejor, y las instrucciones para "pensar paso a paso" o "explicar su razonamiento" son innecesarias para esta familia. La documentación también recomienda definir específicamente el objetivo final y las limitaciones que caracterizan una respuesta exitosa.
En los modelos actuales de la familia GPT-5.6, la API ofrece razonamiento.esfuerzo con niveles que pueden incluir ninguno, bajo, medio, alto, xalto y máximo, según el modelo. La idea no es seleccionar siempre el valor más alto. La recomendación práctica es probar el esfuerzo más bajo que aún mantiene la calidad requerida en su carga de trabajo y avanzar cuando las evaluaciones representativas muestren una ganancia real.
Esto cambia la función del mensaje. En lugar de escribir “pensar detenidamente, considerar alternativas, verificar todo y solo entonces responder”, es más eficiente decir lo que se debe cumplir: “identificar los riesgos que podrían causar la pérdida de datos, estimar el impacto y la probabilidad, proponer mitigaciones y priorizar los cinco más importantes”. Al modelo se le asigna un objetivo verificable; el esfuerzo de razonamiento está en el parámetro apropiado.
Cuando sea necesario mostrarle al usuario cómo se apoyó la conclusión, solicite una explicación objetiva, evidencia relevante o un resumen del razonamiento disponible. No trate la cadena interna completa como un requisito del producto.
Claude: el pensamiento adaptativo y el esfuerzo reemplazan los viejos andamios
En el Claude de hoy, el cambio es igualmente claro. Claude Sonnet 5 opera con pensamiento adaptativo de forma predeterminada y el parámetro de esfuerzo controla el equilibrio entre inteligencia, tokens, costo y latencia. En modelos recientes, Anthropic recomienda aumentar el esfuerzo cuando una tarea compleja requiere un razonamiento superficial, en lugar de intentar compensar con un gran guión de instrucciones.
La propia documentación de indicaciones de Anthropic sugiere preferir una orientación general a pasos demasiado prescriptivos. Un mensaje como “pensar detenidamente en el problema” puede ser más útil que un plan humano rígido de seis o diez pasos, porque el modelo puede generar una mejor estrategia que la secuencia escrita por el mensaje.
Esto no hace que las instrucciones del proceso sean inútiles. Siguen siendo importantes cuando el proceso es parte de la tarea.. Si hay un orden operativo que debe respetarse, una aprobación antes de una acción, una fuente que debe consultarse o un punto de control de validación, describa estos pasos. Lo que ha perdido valor es utilizar un pseudoalgoritmo para razonar sólo para intentar hacer que el modelo sea “más inteligente”.
Todavía hay una diferencia de versión que merece atención. Las configuraciones antiguas de Claude utilizaban el pensamiento con tokens de presupuesto en algunos modelos. En modelos recientes, Anthropic ha migrado al pensamiento y esfuerzo adaptativos. Por lo tanto, las indicaciones y el código de 2024 o 2025 pueden contener una técnica o parámetro que ya no representa las mejores prácticas actuales.
Géminis: el nivel de pensamiento es el control principal para la serie 3
En Gemini, los modelos de las series 3 y 2.5 utilizan el pensamiento de proceso, pero los controles varían según la generación. En la serie Gemini 3, el parámetro think_level controla la profundidad máxima relativa del razonamiento. Los niveles disponibles dependen del modelo y pueden incluir mínimo, bajo, medio y alto. La documentación también recomienda pensar menos en tareas simples y aumentar el nivel en programación compleja, matemáticas o problemas de planificación de varios pasos.
La guía de la serie Gemini 3 es especialmente explícita en cuanto a las indicaciones: las instrucciones directas y concisas tienden a funcionar mejor, mientras que las técnicas de ingeniería de indicaciones muy detalladas o complejas heredadas de modelos más antiguos pueden inducir a un análisis excesivo. Para las migraciones, Google recomienda probar indicaciones simplificadas y utilizar el seguimiento de pensamientos en lugar de depender de una cadena de pensamiento textual.
En la serie Gemini 2.5, think_budget todavía aparece como mecanismo de control en ciertos modelos. Por lo tanto, "Gemini" no debe tratarse como una API uniforme. Antes de reutilizar un mensaje, confirme si el modelo funciona con presupuesto, nivel o comportamiento dinámico y qué valores admite realmente.
Géminis también separa el pensamiento interno de la presentación. La API puede proporcionar resúmenes de ideas cuando se configura para hacerlo, mientras que la respuesta final sigue siendo un artefacto distintivo. Nuevamente, la regla útil es pedirle al modelo una explicación fácil de usar, no asumir que la cadena interna completa es la mejor forma de justificación.
Cuatro indicaciones antiguas reescritas para 2026
El clásico “pensar paso a paso”
Antiguo mensaje: "Resuelve este problema. Piensa paso a paso y solo entonces da la respuesta".
Versión actual: "Resuelva este problema. Considere todas las restricciones dadas, verifique que la conclusión sea coherente con los datos y proporcione la respuesta final con una justificación breve y verificable".
La nueva versión no intenta describir cómo debería pensar el modelo. Describe lo que significa una respuesta aceptable. En un modelo de razonamiento, esto suele ser una mejor señal.
“Muestra todo tu razonamiento”
Mensaje anterior: "Muestre todo su razonamiento interno, sin omitir ningún paso".
Versión actual: “Da la conclusión y explica los elementos necesarios para verificarla: premisas relevantes, cálculo esencial, evidencia utilizada y cualquier incertidumbre que pueda cambiar la decisión”.
Este intercambio mejora el contrato de salida. El lector recibe material para comprobar la respuesta, sin transformar el proceso interno del modelo en un requisito.
“Revisar, repensar y verificar tres veces”
Antiguo mensaje: "Haga el análisis, revise todo, reconsidere la solución y verifique tres veces antes de responder".
Versión actual: “Criterios de éxito: no omitir dependencias, detectar inconsistencias entre datos, señalar información insuficiente y no establecer una conclusión que no pueda respaldarse”.
En modelos que ya realizan autoevaluación o verificación interna, repetir los comandos de revisión solo puede aumentar el costo y la latencia. Los criterios objetivos le permiten medir si la respuesta fue aprobada o no.
Una estricta hoja de ruta de diez pasos
Antiguo mensaje: "Primero identifique el problema, luego enumere las hipótesis, luego genere tres opciones, luego critique cada opción, luego elija una..."
Versión actual: "Objetivo: elegir la alternativa más adecuada. Considerar costo, riesgo, reversibilidad e impacto. Comparar opciones relevantes, descartar aquellas que violen las restricciones y entregar la recomendación con los criterios que determinaron la elección."
La hoja de ruta detallada todavía tiene sentido si cada paso produce un artefacto que otra parte del sistema necesita consumir. Si no existe tal requisito, deje que el modelo elija la estrategia interna y describa solo los criterios de decisión.
Cuando descomponer sigue siendo la técnica correcta
La desaparición del CoT explícito como truco universal no reduce el valor de la descomposición del flujo de trabajo. De hecho, esta distinción se ha vuelto más importante.
Dividir una tarea en llamadas separadas sigue siendo útil cuando es necesario inspeccionar un paso antes del siguiente, cuando se llaman diferentes herramientas en diferentes momentos, cuando hay aprobación humana, cuando es necesario almacenar el resultado intermedio o cuando se debe aislar una falla sin rehacer todo el proceso.
También tiene sentido descomponerse cuando el sistema necesita aplicar diferentes modelos a diferentes partes del trabajo. Un modelo podría extraer datos, otro evaluar evidencia y un tercero escribir el resultado final. Aquí, la cadena existe en la arquitectura de la aplicación, no como un intento de hacer visible el razonamiento interno de una única llamada.
El error común es confundir estas dos cosas. "Realizar estos tres pasos porque mi canalización depende de ellos" es una instrucción operativa legítima. "Siga estos diez pasos porque imagino que esta es la mejor manera de pensar" es una hipótesis que debe probarse, no asumirse.
Cómo elegir el esfuerzo de razonamiento o el nivel de pensamiento
La regla más segura es tratar el esfuerzo como un parámetro de desempeño, no como un sello de calidad. Pensar más puede mejorar las tareas difíciles, pero también aumenta los tokens, el costo y el tiempo de respuesta. En tareas simples, un nivel alto puede desperdiciar recursos sin obtener ganancias mensurables.
Comience con una configuración intermedia o la predeterminada recomendada por el modelo. Luego, realiza la misma batería de tareas en un nivel inferior y en un nivel superior. Compare la corrección, la integridad, el cumplimiento de las restricciones, el uso correcto de las herramientas, la latencia y el costo. El mejor nivel es el más bajo que cumple consistentemente con sus criterios de calidad.
Esta evaluación debe utilizar ejemplos reales del producto. Un benchmark matemático no necesariamente predice el comportamiento en atención al cliente, análisis de documentos, extracción estructurada o automatización con herramientas. El parámetro debe calibrarse en la carga de trabajo que realmente entra en producción.
También es importante probar la prontitud y el esfuerzo por separado. Si cambia el texto del mensaje y el nivel de pensamiento al mismo tiempo, es difícil saber qué cambio causó la ganancia o la regresión. En las migraciones de modelos, conserve una línea de base, cambie una variable a la vez y registre el efecto.
La explicación visible no es una cadena de pensamiento
Existe una razón adicional para abandonar el requisito de "mostrar todo el razonamiento": una buena interfaz rara vez lo necesita.
En un análisis financiero, el usuario quiere saber qué números se utilizaron, qué fórmula se aplicó y qué hipótesis cambian el resultado. En una revisión de código, desea encontrar la línea problemática, el impacto y la solución sugerida. En una decisión de compra, se necesitan criterios, compensaciones y límites. En la investigación, lo que necesitas son fuentes, métodos y grado de confianza.
Estos elementos son verificables y procesables. Se pueden solicitar explícitamente en el mensaje y evaluarse mediante pruebas. Por otro lado, una transcripción extensa del razonamiento puede ser larga, difícil de auditar y no siempre es la mejor interfaz para justificar una conclusión.
Por lo tanto, el patrón recomendado es especificar las evidencias que deben aparecer. Pregunte “citar los datos utilizados”, “mostrar el cálculo esencial”, “explicar los dos criterios que más pesaron”, “señalar la incertidumbre dominante” o “decir qué haría cambiar la conclusión”. Esto produce una transparencia útil sin convertir el razonamiento interno en un producto.
Lo que todavía vale la pena aprender de la clásica Cadena de Pensamiento
El antiguo CoT continúa enseñando dos ideas importantes. La primera es que las tareas complejas se benefician de la estructura. La segunda es que los modelos pueden responder mejor cuando reciben señales claras de que una conclusión requiere múltiples relaciones y no sólo una recuperación superficial.
Lo que ha cambiado es la forma de aplicar estas ideas. En modelos sin características de razonamiento moderno, en modelos más pequeños o en tareas específicas, los ejemplos con razonamiento intermedio aún pueden ayudar y deben evaluarse empíricamente. Sin embargo, en los modelos de razonamiento actuales, el punto de partida más sólido es un mensaje orientado a resultados, combinado con el control del esfuerzo que ofrece la API.
Si una tarea falla, evita agregar automáticamente más frases como “piensa mejor”, “ten mucho cuidado” o “hazlo paso a paso”. Primero pregunte qué información faltaba en el contrato. ¿Estaba claro el objetivo? ¿Las restricciones fueron explícitas? ¿Sabía el modelo lo que significaba el éxito? ¿El formato de salida permitió comprobar el resultado? ¿El esfuerzo fue adecuado a la complejidad? ¿Hubo algún paso que realmente debería separarse en el flujo de trabajo?
Esta secuencia de diagnóstico a menudo produce indicaciones que son más portátiles entre proveedores y más fáciles de mantener en todos los cambios de modelo.
La regla general para 2026
Para los modelos de razonamiento, trate “pensar paso a paso” como una técnica histórica útil, no como una frase obligatoria. Comience con el objetivo, el contexto, las limitaciones, los criterios de éxito y el formato de salida. Utilice el esfuerzo de razonamiento, el esfuerzo o el nivel de pensamiento cuando el proveedor ofrezca este control. Prescriba pasos sólo cuando sean parte del proceso que debe realizarse o auditarse.
Y cuando sea necesario explicar la respuesta, solicite una justificación verificable en lugar de una cadena interna completa. La ingeniería rápida en 2026 se preocupa menos por enseñar al modelo a pensar como imaginaba y más por definir con precisión qué necesita resolver, cuánto esfuerzo debe dedicar y qué evidencia debe aparecer en la respuesta.