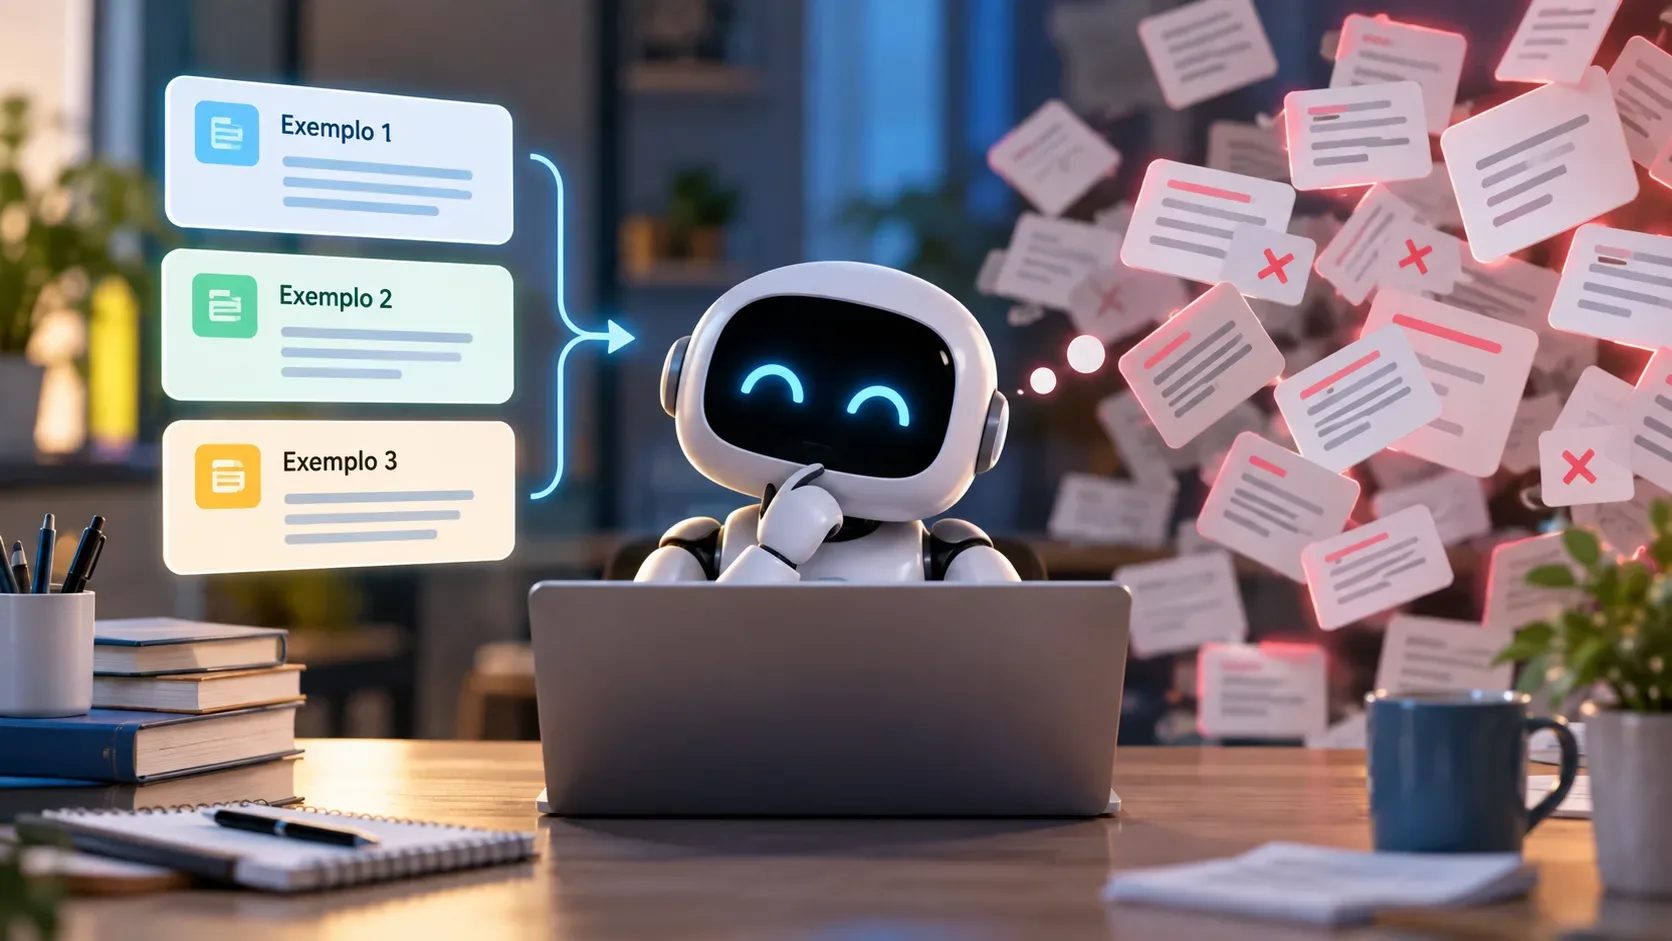
Empieza sin ejemplos y añade demostraciones few-shot solo cuando una prueba muestre que corrigen un error concreto. Zero-shot es una instrucción sin demostraciones de entrada y salida; few-shot añade algunos pares de ejemplo para hacer visible el patrón esperado. La diferencia resulta especialmente útil cuando la tarea exige etiquetas, estilo o decisiones límite difíciles de explicar en una sola frase. Los ejemplos no garantizan aciertos: también consumen tokens y pueden llevar al modelo a copiar rasgos irrelevantes.
Zero-shot y few-shot: ¿qué cambia en el prompt?
En zero-shot describes la tarea, las reglas, el formato y la entrada que se debe procesar. En few-shot mantienes esas instrucciones y añades demostraciones de cómo se deberían responder entradas anteriores. La guía de prompting de OpenAI describe few-shot como la inclusión de algunos ejemplos de entrada y salida y recomienda que sean diversos. Las recomendaciones de Anthropic también destacan relevancia, variedad y separación clara entre instrucciones y ejemplos.
La prueba no consiste en decidir qué nombre suena más avanzado, sino en comprobar si los ejemplos enseñan algo que la instrucción todavía no comunica. Si el modelo ya entrega el formato y la decisión esperados, alargar el prompt puede no compensar.
Cuándo los ejemplos aportan información útil
- Un formato difícil de describir: mostrar una salida corta y otra larga puede delimitar la estructura o el nivel de detalle, siempre que las reglas también sean explícitas.
- Casos ambiguos: un ejemplo límite muestra cómo aplicar la regla cuando hay señales contradictorias.
- Una convención propia del equipo: los ejemplos pueden mostrar etiquetas internas, orden de campos o un estilo editorial que el modelo no puede adivinar.
- Errores recurrentes detectados: un contraejemplo puede corregir una generalización inadecuada observada durante la evaluación.
En tareas sencillas, una definición precisa y un formato de salida explícito suelen ser un punto de partida más breve. Si resulta imprescindible un contrato JSON estricto, considera también las salidas estructuradas con esquema cuando estén disponibles: los ejemplos visuales no sustituyen la validación del formato ni garantizan por sí solos el cumplimiento de un esquema.
Una prueba con los mismos cuatro casos
Considera la clasificación de comentarios sobre una compra. Las opciones son positivo, negativo, mixto y sin valoración. Define positivo como solo elogio; negativo como solo queja; mixto como elogio y queja; y sin valoración como relato de un hecho sin juicio. En ambos prompts, pide solo una etiqueta y ninguna explicación.
Versión zero-shot
Instrucción: «Clasifica el comentario como positivo, negativo, mixto o sin valoración según las definiciones anteriores. Responde únicamente con la etiqueta. Comentario: [entrada]». No se añade ninguna demostración.
Versión few-shot
Mantén la misma instrucción y añade cuatro pares de demostración antes de la nueva entrada:
- «Atención excelente». → positivo.
- «El soporte no resolvió mi problema». → negativo.
- «Me gustó la calidad, pero el envío fue lento». → mixto.
- «Pedido registrado a las 14 h». → sin valoración.
Después aplica ambas versiones al conjunto de prueba siguiente. La columna de referencia indica la etiqueta esperada según la regla; no representa un resultado medido de un modelo.
| Entrada reservada para la prueba | Etiqueta de referencia | Qué comprueba |
|---|---|---|
| «Llegó pronto y funciona bien». | positivo | Elogio sin queja |
| «Llegó roto». | negativo | Queja sin elogio |
| «Funciona bien, pero llegó tarde». | mixto | Dos señales en una entrada |
| «Lo compré el martes». | sin valoración | Hecho sin juicio |
La función del contraejemplo
Si el modelo empieza a clasificar como mixta cualquier frase que contenga «pero», añade la regla o un caso correctivo: «La atención fue mala, pero el problema siguió sin resolverse». → negativo. Son dos hechos negativos, no un elogio y una queja. El contraejemplo comprueba la regla semántica, no la presencia de una palabra. Debe probarse con casos nuevos en vez de tomarse como prueba de una mejora universal.
Cómo comparar la calidad y el coste por separado
- Separa las demostraciones del conjunto de evaluación. No cuentes como aciertos de la prueba los ejemplos que ya aparecen en el prompt.
- Mantén constantes el modelo, las instrucciones, la configuración y las entradas; cambia solo los ejemplos.
- Compara una versión zero-shot, una few-shot breve y, si hay una hipótesis clara, otra con contraejemplo.
- Comprueba la corrección de las etiquetas, el cumplimiento del formato y el rendimiento en casos límite. Repite las ejecuciones si las respuestas varían.
- Registra tokens de entrada, tokens de salida, latencia y coste total por llamada. Observa los promedios y los tipos de error, no solo un resultado favorable.
La guía de evaluación de OpenAI recomienda medir el comportamiento con criterios y datos de prueba. En este ejemplo, las etiquetas son una clave de respuestas propuesta; solo una ejecución real permitiría saber si los ejemplos mejoran, empeoran o no cambian el resultado.
Cuándo los ejemplos solo consumen contexto
Cada demostración añade texto al prompt y, por tanto, puede aumentar los tokens de entrada. Ocupa parte de la ventana de contexto que podría utilizarse para documentos, historial o la propia pregunta. Los ejemplos redundantes, largos o alejados de la tarea aportan menos valor como demostraciones. También pueden enseñar patrones accidentales: por ejemplo, si todos los elogios de los ejemplos son cortos, el modelo puede confundir longitud con sentimiento.
No existe una cantidad ideal universal de ejemplos para todos los modelos y tareas. Añade ejemplos para probar una hipótesis observable, elimina los que no cambien el comportamiento y comprueba el efecto en el conjunto reservado. En sistemas con llamadas repetidas, la caché de prompts puede reducir el precio de partes reutilizadas en determinadas condiciones; eso no hace que los ejemplos desaparezcan de la ventana de contexto ni elimina la necesidad de medir el uso y el coste reales.
Una regla práctica para decidir
Usa zero-shot como línea de base cuando las reglas sean claras y el resultado ya pueda validarse. Prueba few-shot cuando haya un error constante de formato, interpretación de etiquetas o manejo de excepciones. Elige ejemplos representativos y variados, sepáralos de la nueva entrada y mantén explícita la instrucción. Conserva la versión más corta que cumpla los criterios de calidad en tu conjunto de prueba. Es una decisión de ingeniería basada en evidencia local, no una promesa de que más ejemplos siempre produzcan mejores respuestas.