Categoría

Pruebas y comparaciones

Evaluaciones reproducibles por tarea, costo, velocidad, precisión y facilidad de uso.

20artículos
Mesa de pesquisa com notebook, lupa sobre um documento, robô de IA e livros identificados como fonte, edição, DOI e afirmação.
Pruebas y comparaciones26/09/20265 min de lectura

Cómo comprobar si un asistente de IA inventó una referencia: protocolo de verificación

Un protocolo práctico para comprobar si una referencia citada por IA existe, si el DOI corresponde a la obra correcta, si la edición es la adecuada y si la fuente realmente respald...

Leer artículo

Mulher em ambiente doméstico conversa com robô humanoide sentado diante dela, representando interação entre IA e apoio emocional.
Pruebas y comparaciones24/09/20267 min de lectura

MentalHealthBench: qué mide la nueva evaluación de IA y qué límites permanecen

El benchmark abierto evalúa respuestas de IA en 1.215 conversaciones sintéticas sobre salud mental. Conozca su metodología, rubricas, perfiles y límites.

Leer artículo
Uma esfera dourada identificada como GPT-6 Sol e uma esfera azul identificada como GPT-6 Luna aparecem em lados opostos de uma balança, com moedas e calculadora em primeiro plano.
Pruebas y comparaciones23/09/20266 min de lectura

GPT-6 Sol o Luna en la API: precios por millón de tokens y cómo elegir

Compara los precios de GPT-6 Sol y Luna en la API, revisa un ejemplo de costo y entiende cuándo tiene más sentido cada modelo.

Leer artículo
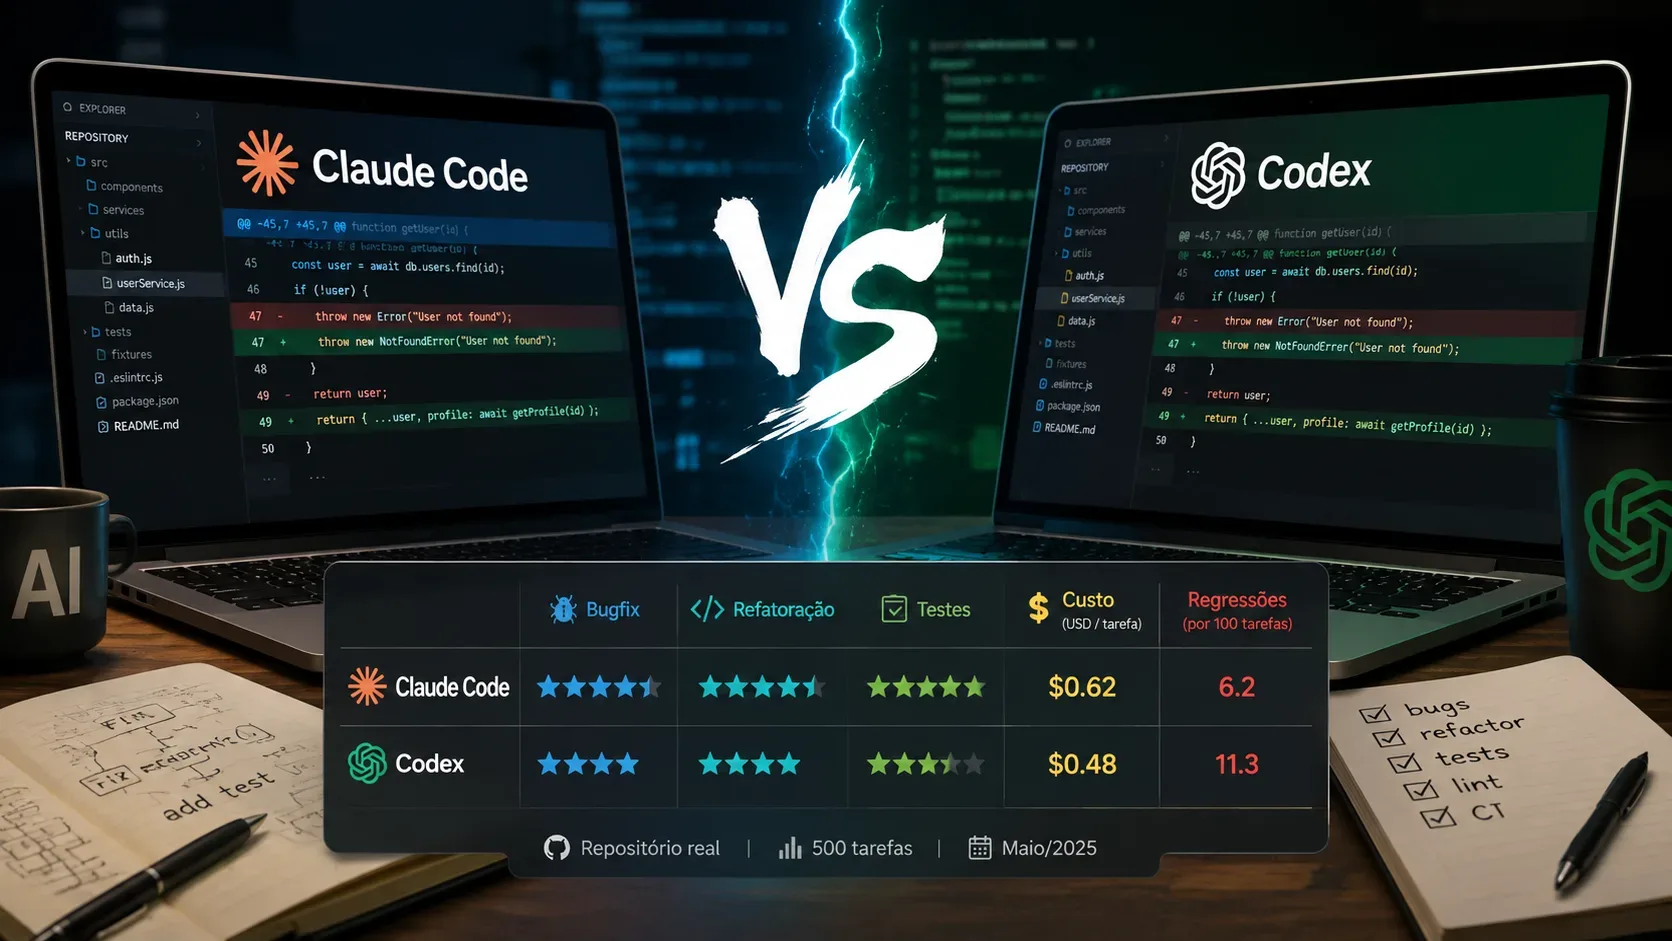
Dois notebooks lado a lado exibem diffs de código de Claude Code e Codex, com um painel comparativo de métricas ao centro.
Pruebas y comparaciones01/09/20268 min de lectura

Claude Code vs Codex: ¿cuál modifica un repositorio con menos regresiones?

Los benchmarks de 2026 muestran una disputa ajustada: Claude Code lidera en calidad agregada, Codex gana en coste y velocidad, pero las regresiones deben medirse en tu propio repos...

Leer artículo
Dois apresentadores diante de microfones e câmeras em composição dividida, conectados por ondas de áudio em verde, amarelo e azul.
Pruebas y comparaciones01/09/20267 min de lectura

Veo 3.1 o Kling 3.0: ¿cuál es mejor para video con audio y diálogo en portugués?

Para portugués brasileño nativo, Veo 3.1 es la primera opción que conviene probar; Kling 3.0 gana fuerza cuando aportas una voz en portugués preparada para lip-sync.

Leer artículo
Pesquisadora diante de três áreas visuais com artigos científicos, rede de citações e símbolo de verificação.
Pruebas y comparaciones31/08/20269 min de lectura

Elicit, Consensus o Scite: ¿cuál encuentra los artículos correctos y ayuda a verificar citas?

Elicit, Consensus y Scite resuelven etapas distintas: búsqueda y cribado, síntesis de evidencia y auditoría del contexto de las citas.

Leer artículo
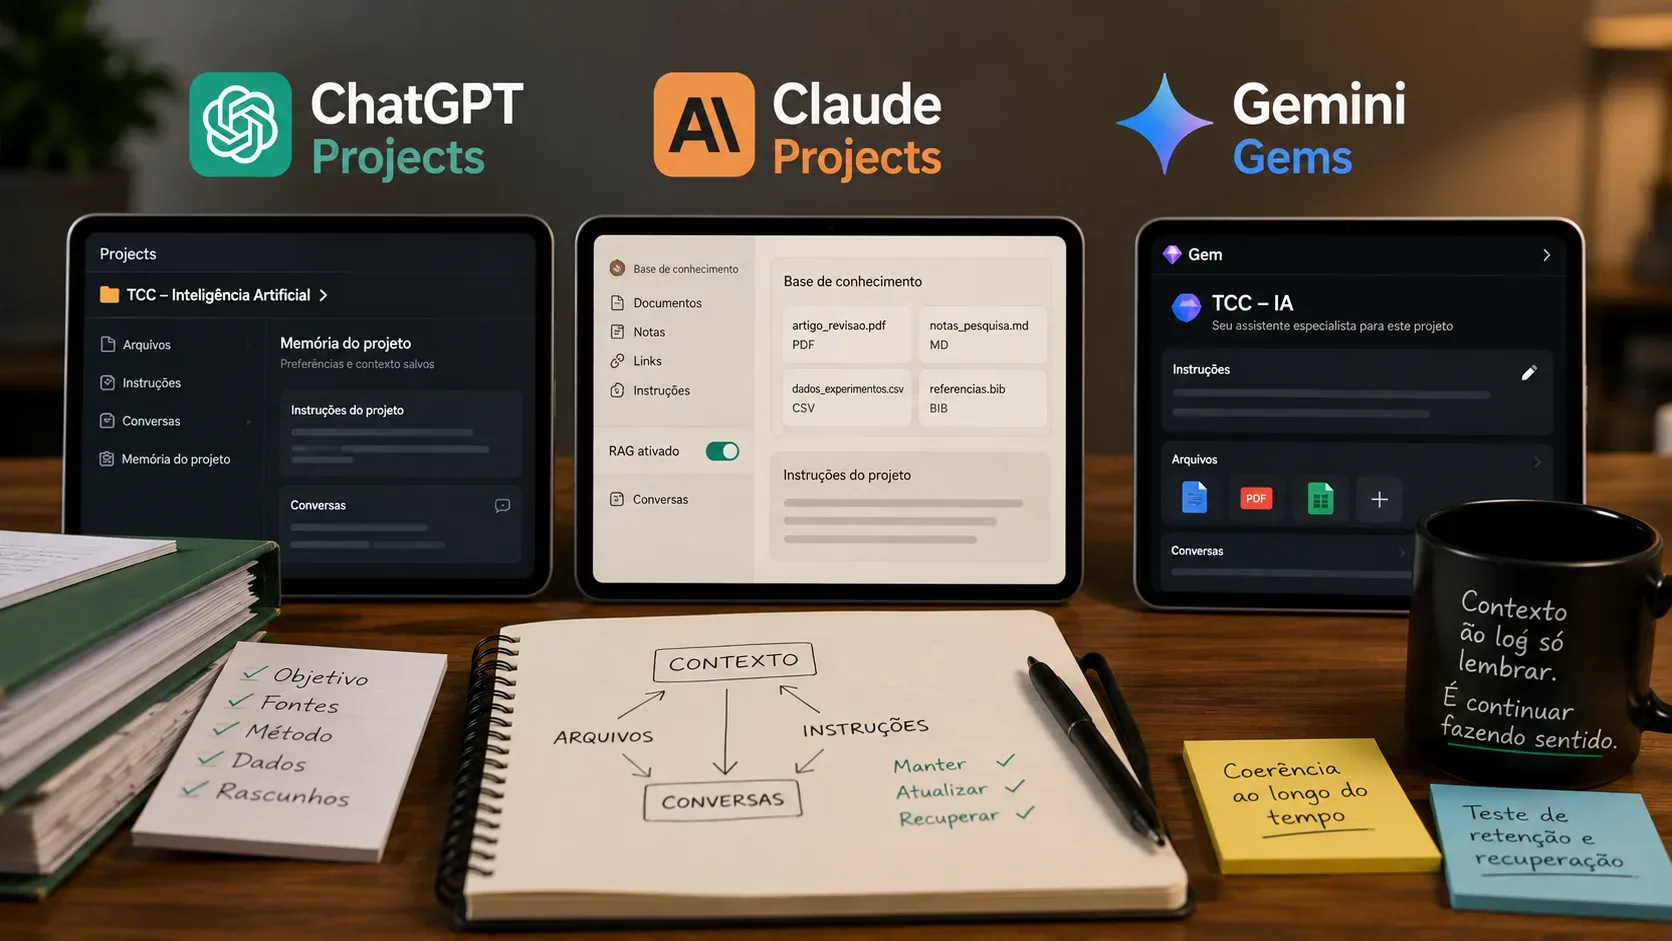
Três tablets lado a lado representam ChatGPT Projects, Claude Projects e Gemini Gems, com arquivos, instruções e anotações sobre contexto em uma mesa de trabalho.
Pruebas y comparaciones31/08/20268 min de lectura

ChatGPT Projects, Claude Projects o Gemini Gems: ¿cuál mantiene mejor el contexto de un trabajo largo?

Comparación centrada en continuidad entre chats, actualización de información, conflictos de instrucciones y aislamiento de contexto, con un protocolo reproducible para probar los ...

Leer artículo
Mulher ao centro com jaqueta vermelha entre duas versões editadas da mesma foto, uma preservada e outra com alterações colaterais destacadas.
Pruebas y comparaciones31/08/20268 min de lectura

ChatGPT o Gemini: ¿cuál edita una foto sin cambiar lo que no pediste? Benchmark de fidelidad en 2026

Comparación de fidelidad en edición de fotos: rostro, texto, objetos, encuadre, selección local y cambios colaterales en ChatGPT y Gemini.

Leer artículo
Ilustração editorial com painéis de DeepL, Google Tradutor, ChatGPT e Gemini ao redor de um quadro de benchmark PT-BR para inglês, com critérios de fidelidade, naturalidade e checagem de erros.
Pruebas y comparaciones30/08/202610 min de lectura

DeepL, Google Traductor, ChatGPT o Gemini: ¿cuál traduce mejor de PT-BR al inglés en 2026?

La evidencia actual no señala un campeón universal: los LLM manejan mejor el contexto y los modismos, mientras los traductores dedicados ganan en previsibilidad y control.

Leer artículo
Painel futurista de benchmark com três modelos de IA comparando texto em português, acentos, cedilha, moeda e legibilidade, com exemplos e pontuações ilustrativas.
Pruebas y comparaciones28/08/202610 min de lectura

¿Qué IA escribe mejor texto dentro de imágenes en portugués? ChatGPT Images 2.0, Nano Banana 2 e Ideogram 4.0

ChatGPT Images 2.0, Nano Banana 2 e Ideogram 4.0 prometen mejor texto en imágenes, pero un ganador en PT-BR exige pruebas controladas de acentos, moneda, puntuación y legibilidad.

Leer artículo
Notebook em uma mesa mostra Gemini, NotebookLM, Pergunte ao YouTube e Eightify, ao lado de um cartaz sobre benchmark PT-BR e um caderno com critérios de avaliação.
Pruebas y comparaciones27/08/202610 min de lectura

¿Qué IA resume mejor videos de YouTube en portugués? Gemini, NotebookLM, Pergunte ao YouTube y Eightify comparados

NotebookLM es el más sólido para rastrear lo que provino de la transcripción; Eightify facilita la navegación por timestamps. Gemini y Pergunte ao YouTube ganan en flexibilidad, pe...

Leer artículo
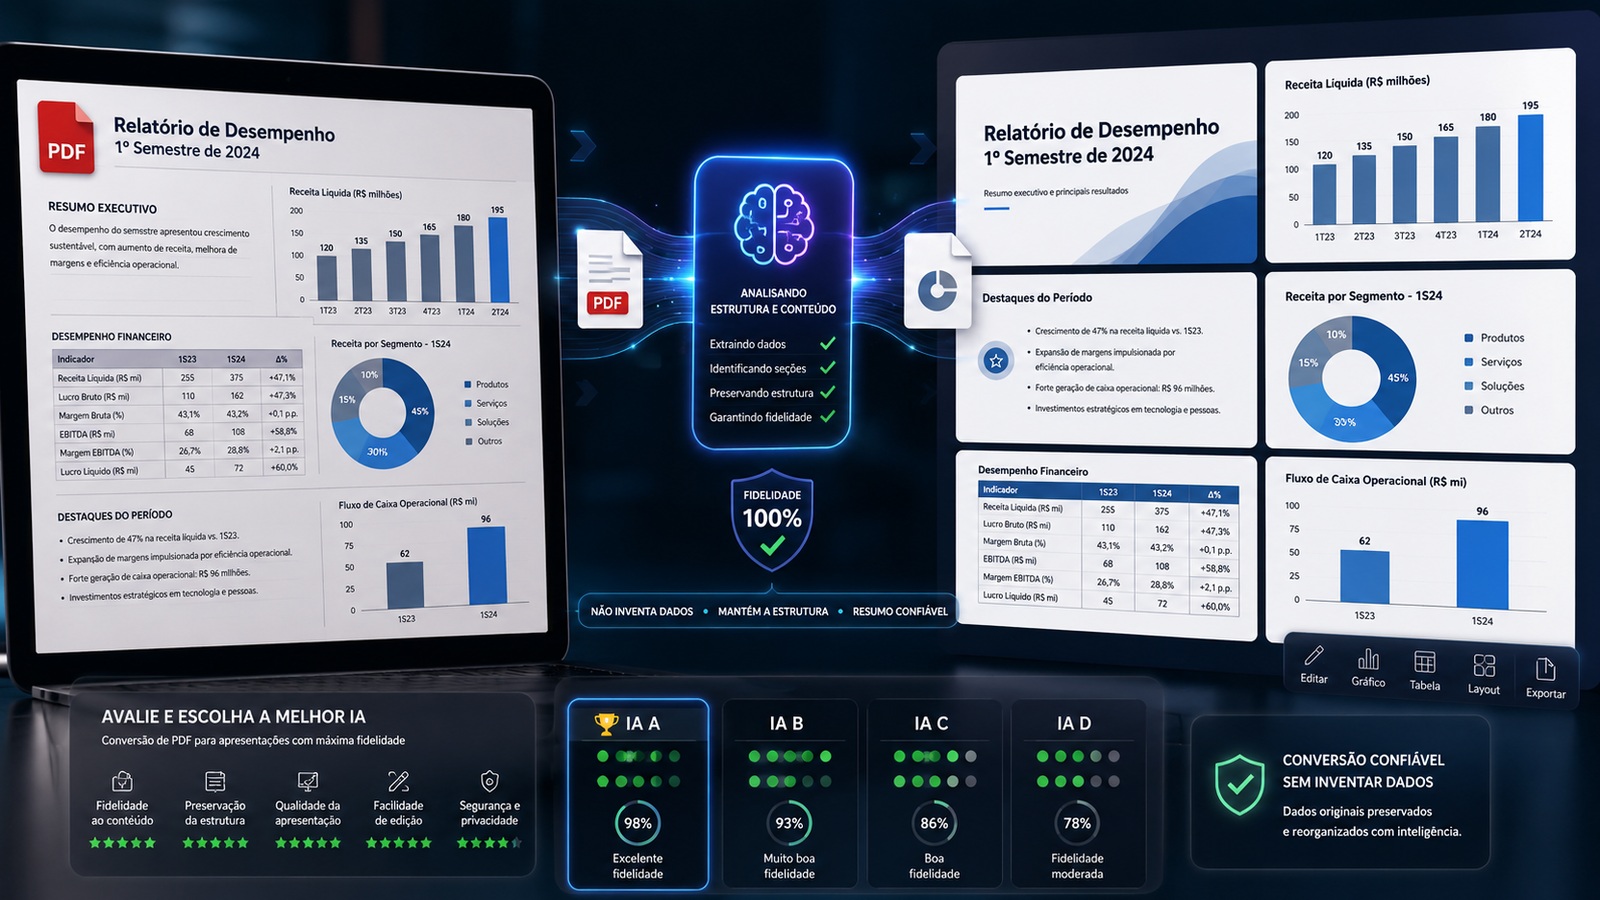
Ilustração digital mostra um PDF com gráficos à esquerda, um módulo de IA no centro e uma apresentação editável à direita, com painéis de comparação de fidelidade e preservação de dados.
Pruebas y comparaciones26/08/202614 min de lectura

¿Qué IA transforma PDF en presentaciones sin inventar datos? Gamma, Plus AI, Adobe y 2Slides en un benchmark PT-BR

Gamma, Plus AI, Adobe Acrobat/Express y 2Slides siguen estrategias diferentes para convertir PDFs en diapositivas. La elección cambia según fidelidad, trazabilidad y edición.

Leer artículo