Categoria

Testes e Comparações

Avaliações reproduzíveis por tarefa, custo, velocidade, precisão e facilidade de uso.

20artigos
Mesa de pesquisa com notebook, lupa sobre um documento, robô de IA e livros identificados como fonte, edição, DOI e afirmação.
Testes e Comparações26/09/20265 min de leitura

Como testar se um assistente de IA inventou uma referência: protocolo de checagem

Um protocolo prático para verificar se uma referência citada por IA existe, se o DOI corresponde à obra certa, se a edição está correta e se a fonte realmente sustenta a afirmação.

Ler artigo

Mulher em ambiente doméstico conversa com robô humanoide sentado diante dela, representando interação entre IA e apoio emocional.
Testes e Comparações24/09/20267 min de leitura

MentalHealthBench: o que a nova avaliação de IA mede e quais limites permanecem

O benchmark aberto avalia respostas de IA em 1.215 conversas sintéticas sobre saúde mental. Entenda metodologia, rubricas, perfis avaliados e limites.

Ler artigo
Uma esfera dourada identificada como GPT-6 Sol e uma esfera azul identificada como GPT-6 Luna aparecem em lados opostos de uma balança, com moedas e calculadora em primeiro plano.
Testes e Comparações23/09/20266 min de leitura

GPT-6 Sol ou Luna na API: preços por milhão de tokens e como escolher

Compare os preços do GPT-6 Sol e Luna na API, veja um exemplo de custo e entenda quando cada modelo faz mais sentido.

Ler artigo
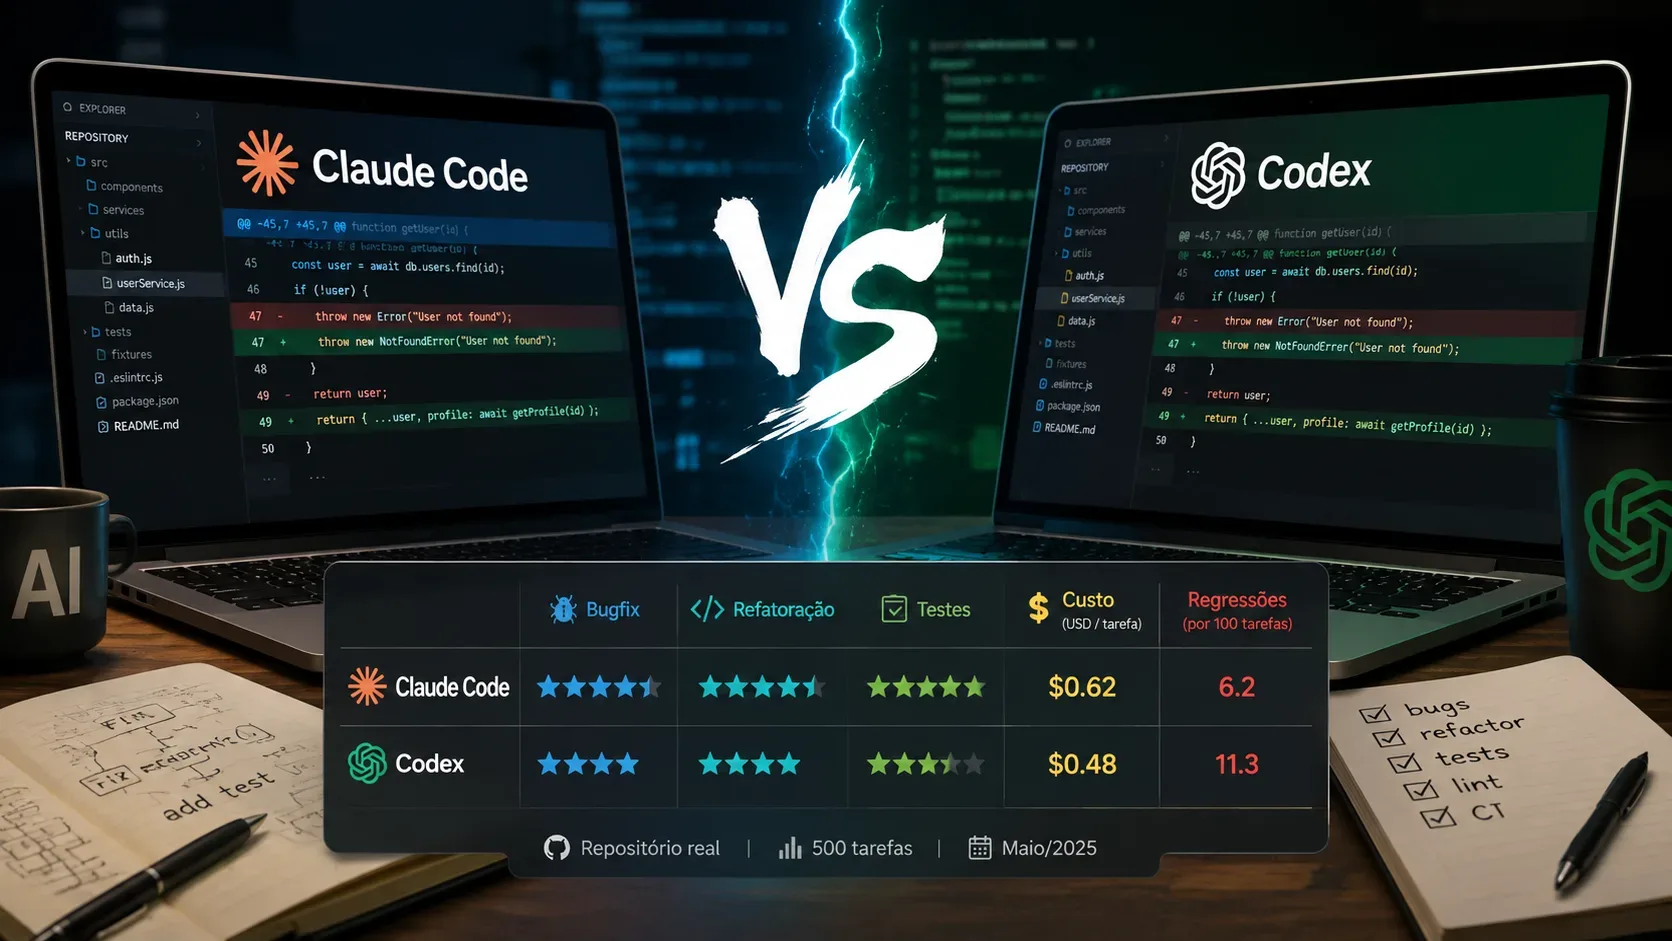
Dois notebooks lado a lado exibem diffs de código de Claude Code e Codex, com um painel comparativo de métricas ao centro.
Testes e Comparações01/09/20268 min de leitura

Claude Code ou Codex: qual altera um repositório com menos regressões?

Benchmarks de 2026 mostram uma disputa apertada: Claude Code lidera em qualidade agregada, Codex ganha em custo e velocidade, mas regressões exigem teste no seu próprio repositório...

Ler artigo
Dois apresentadores diante de microfones e câmeras em composição dividida, conectados por ondas de áudio em verde, amarelo e azul.
Testes e Comparações01/09/20267 min de leitura

Veo 3.1 ou Kling 3.0: qual é melhor para vídeo com áudio e diálogo em português?

Para PT-BR nativo, o Veo 3.1 é a primeira opção a testar; o Kling 3.0 ganha força quando você leva uma voz em português pronta para o lip-sync.

Ler artigo
Pesquisadora diante de três áreas visuais com artigos científicos, rede de citações e símbolo de verificação.
Testes e Comparações31/08/20269 min de leitura

Elicit, Consensus ou Scite: qual encontra os artigos certos e ajuda a verificar citações?

Elicit, Consensus e Scite resolvem etapas diferentes da pesquisa: busca e triagem, síntese da evidência e auditoria do contexto das citações.

Ler artigo
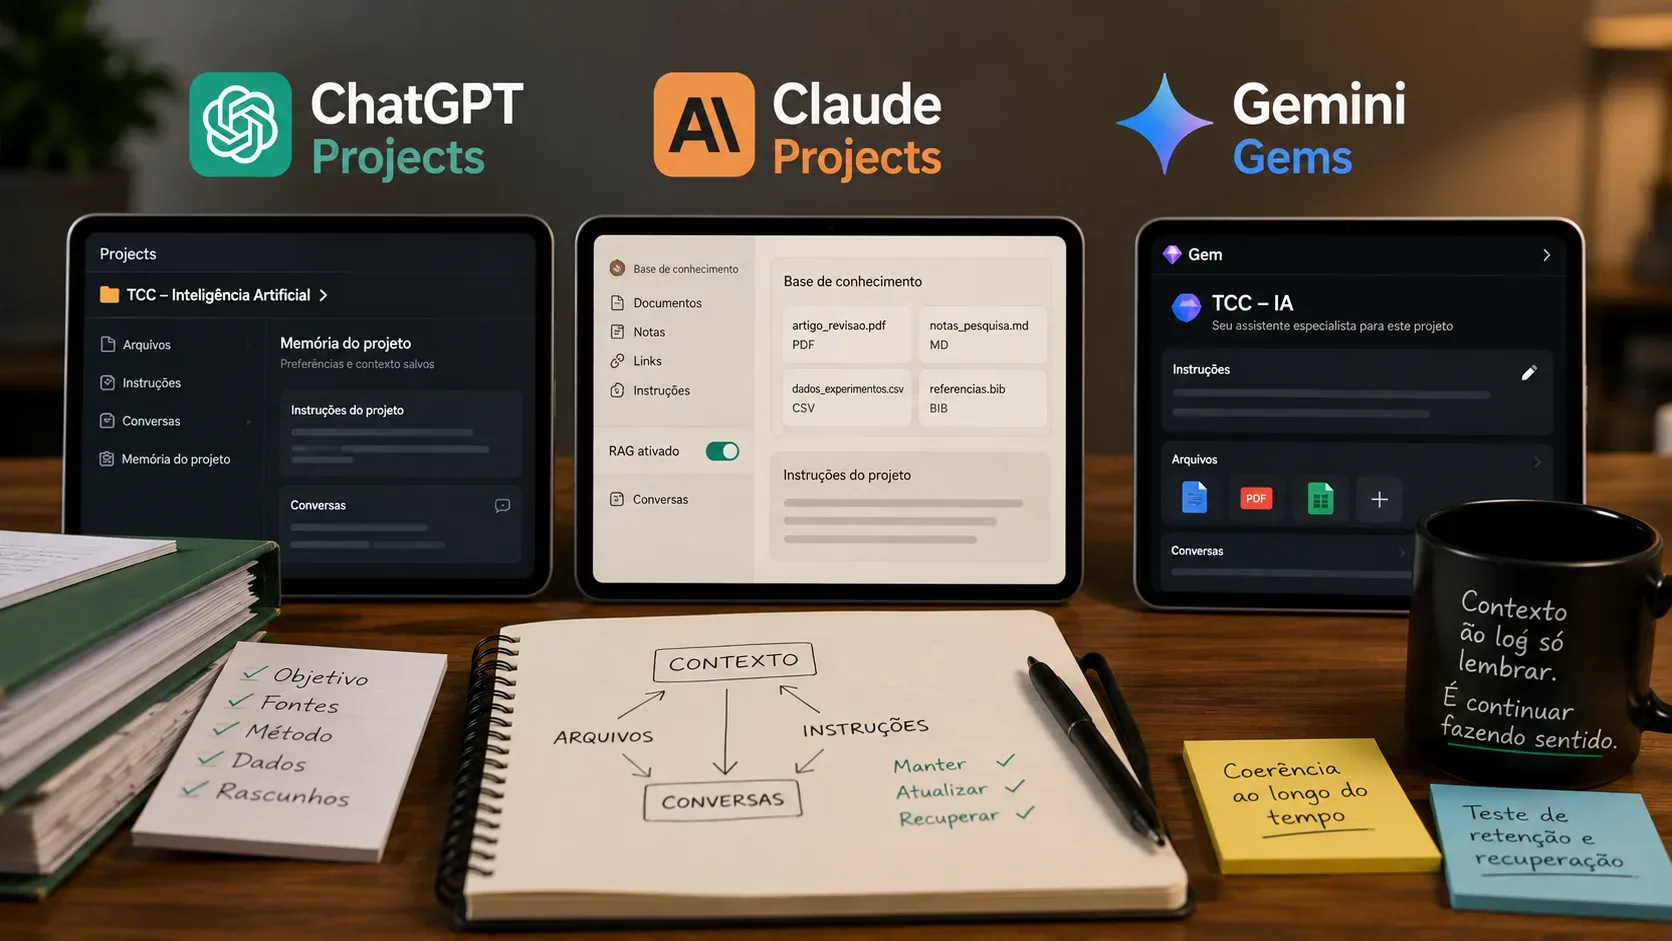
Três tablets lado a lado representam ChatGPT Projects, Claude Projects e Gemini Gems, com arquivos, instruções e anotações sobre contexto em uma mesa de trabalho.
Testes e Comparações31/08/20268 min de leitura

ChatGPT Projects, Claude Projects ou Gemini Gems: qual mantém melhor o contexto de um trabalho longo?

Comparação focada em continuidade entre chats, atualização de informações, conflitos de instruções e isolamento de contexto — com um protocolo reproduzível para testar os três.

Ler artigo
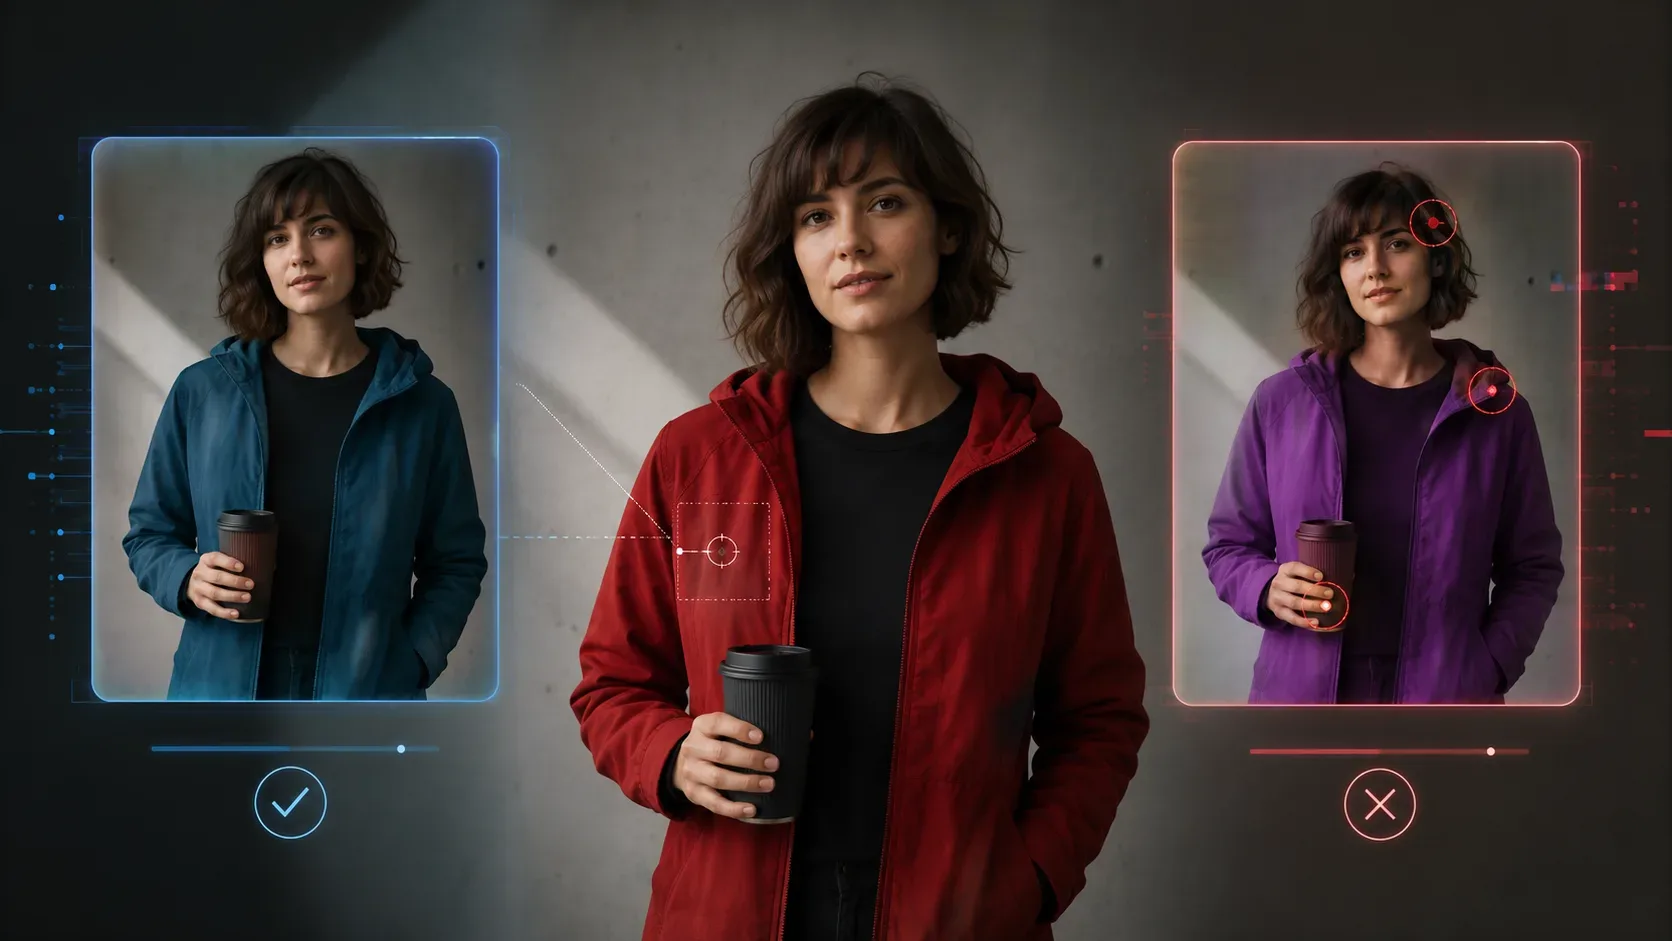
Mulher ao centro com jaqueta vermelha entre duas versões editadas da mesma foto, uma preservada e outra com alterações colaterais destacadas.
Testes e Comparações31/08/20268 min de leitura

ChatGPT ou Gemini: qual edita uma foto sem mudar o que você não pediu? Benchmark de fidelidade em 2026

Comparação de fidelidade na edição de fotos: rosto, texto, objetos, enquadramento, seleção local e alterações colaterais no ChatGPT e no Gemini.

Ler artigo
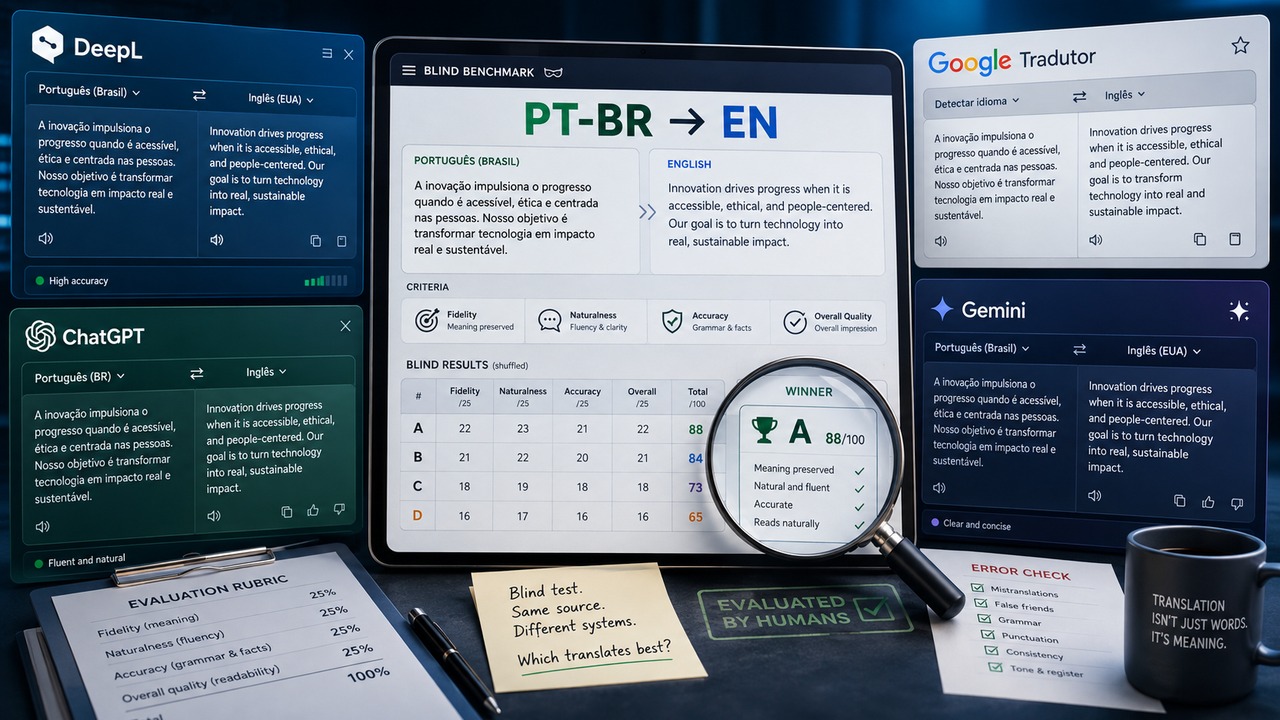
Ilustração editorial com painéis de DeepL, Google Tradutor, ChatGPT e Gemini ao redor de um quadro de benchmark PT-BR para inglês, com critérios de fidelidade, naturalidade e checagem de erros.
Testes e Comparações30/08/20269 min de leitura

DeepL, Google Tradutor, ChatGPT ou Gemini: qual traduz melhor PT-BR para inglês em 2026?

A evidência atual não aponta um campeão universal: LLMs lidam melhor com contexto e idiomatismo, enquanto tradutores dedicados ganham em previsibilidade e controle.

Ler artigo
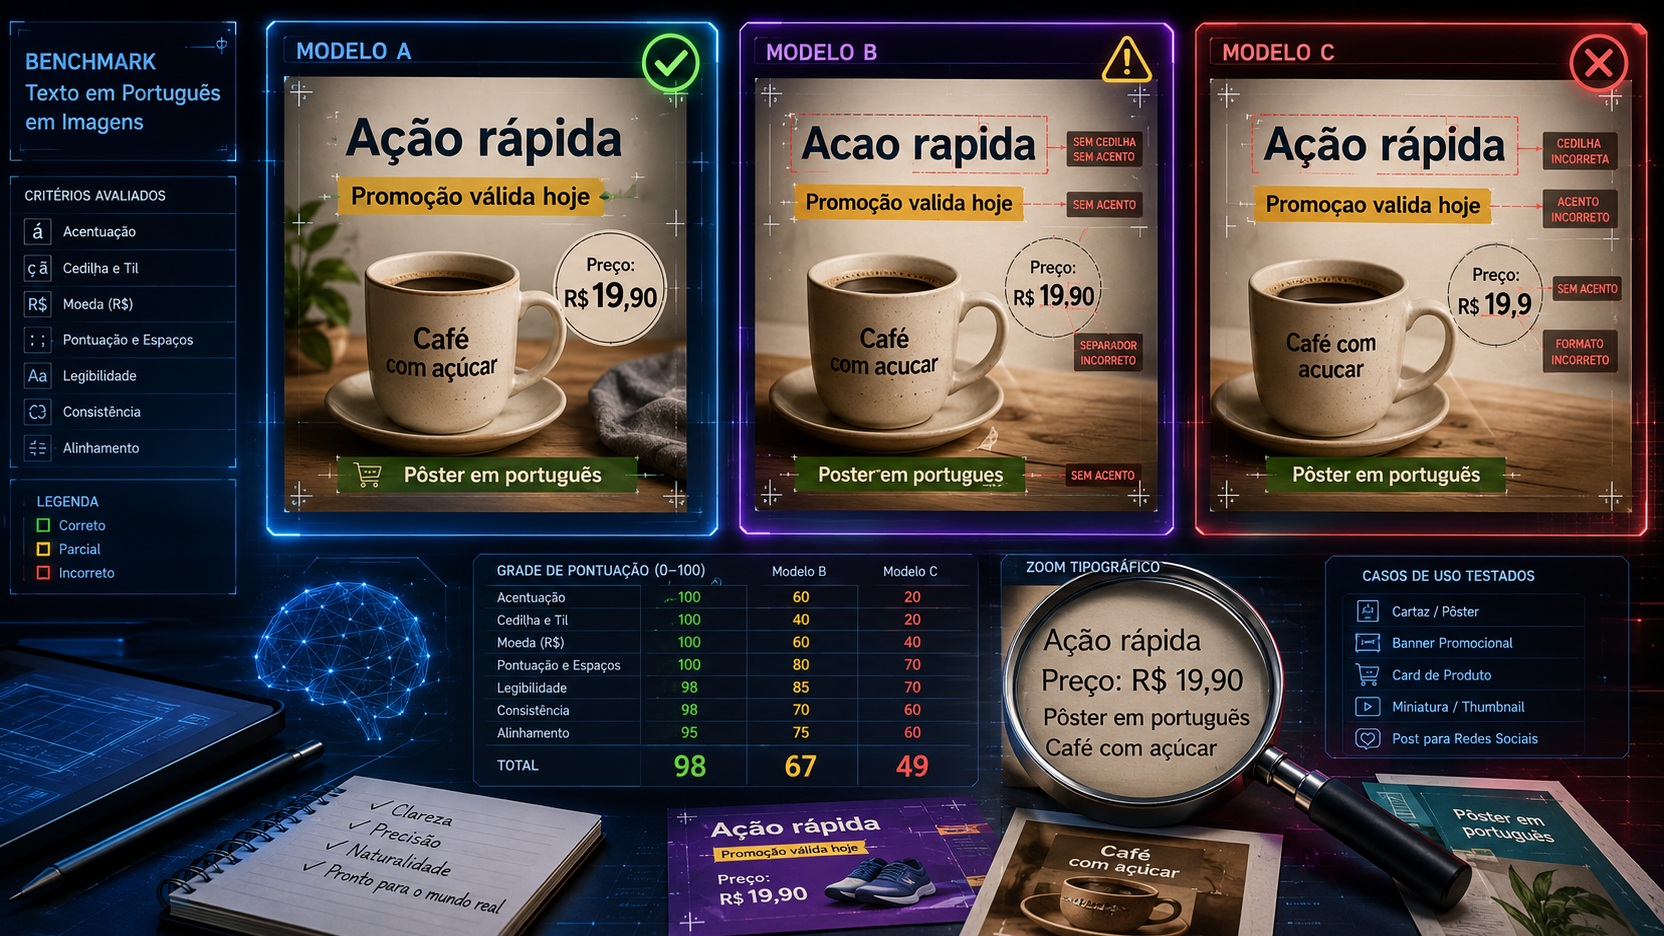
Painel futurista de benchmark com três modelos de IA comparando texto em português, acentos, cedilha, moeda e legibilidade, com exemplos e pontuações ilustrativas.
Testes e Comparações28/08/20269 min de leitura

Qual IA escreve melhor texto em imagens em português? ChatGPT Images 2.0, Nano Banana 2 e Ideogram 4.0

ChatGPT Images 2.0, Nano Banana 2 e Ideogram 4.0 prometem texto melhor em imagens, mas um vencedor em PT-BR exige teste controlado de acentos, moeda, pontuação e legibilidade.

Ler artigo
Notebook em uma mesa mostra Gemini, NotebookLM, Pergunte ao YouTube e Eightify, ao lado de um cartaz sobre benchmark PT-BR e um caderno com critérios de avaliação.
Testes e Comparações27/08/202610 min de leitura

Qual IA resume melhor vídeos do YouTube em português? Gemini, NotebookLM, Pergunte ao YouTube e Eightify comparados

NotebookLM é o mais forte para rastrear o que veio da transcrição; Eightify facilita a navegação por timestamps. Gemini e Pergunte ao YouTube ganham em flexibilidade, mas exigem ch...

Ler artigo
Ilustração digital mostra um PDF com gráficos à esquerda, um módulo de IA no centro e uma apresentação editável à direita, com painéis de comparação de fidelidade e preservação de dados.
Testes e Comparações26/08/202614 min de leitura

Qual IA transforma PDF em apresentação sem inventar dados? Gamma, Plus AI, Adobe e 2Slides em um benchmark PT-BR

Gamma, Plus AI, Adobe Acrobat/Express e 2Slides seguem estratégias diferentes para transformar PDFs em slides. A escolha muda conforme fidelidade, rastreabilidade e edição.

Ler artigo