A frase “pense passo a passo” virou um dos atalhos mais famosos da engenharia de prompts. Em 2022, estudos de Chain of Thought mostraram que induzir modelos grandes a produzir etapas intermediárias podia melhorar tarefas de aritmética, lógica e raciocínio simbólico. O efeito foi tão marcante que a expressão acabou sendo tratada como uma espécie de botão universal de inteligência.
Em 2026, esse hábito precisa ser revisto. Os principais provedores passaram a oferecer modelos que já fazem raciocínio interno antes de responder e, em muitos casos, também expõem controles próprios para decidir quanto esforço computacional usar. A consequência prática é importante: escrever um roteiro detalhado de “pensamento” no prompt deixou de ser o melhor ponto de partida para várias tarefas.
Isso não significa que decomposição, verificação ou explicação perderam valor. Significa que elas agora precisam ser usadas pelo motivo certo. O prompt deve dizer com clareza o que precisa ser resolvido, quais restrições importam, que evidências são necessárias e como a resposta deve ser apresentada. A quantidade de raciocínio, quando a API permite, passa a ser um controle separado.
“Pense passo a passo” não morreu; mudou de função
O Chain of Thought clássico nasceu em uma geração de modelos diferente da atual. O trabalho de Jason Wei e coautores mostrou que exemplos com etapas intermediárias podiam melhorar o desempenho de modelos grandes em problemas que exigiam várias inferências. Pouco depois, Takeshi Kojima e coautores popularizaram o Zero-shot-CoT ao observar ganhos em vários benchmarks simplesmente acrescentando uma instrução equivalente a “vamos pensar passo a passo”.
Esses resultados eram reais dentro das condições estudadas, mas não criaram uma lei permanente de prompting. Eles mostravam como determinados modelos daquela época podiam ser induzidos a usar melhor sua capacidade latente. Hoje, parte desse comportamento foi incorporada ao próprio processo de inferência de modelos de raciocínio.
Por isso, a pergunta útil em 2026 não é “CoT funciona ou não?”. A pergunta é: “Qual parte do
problema deve ficar no prompt, qual parte deve ficar no controle de reasoning/thinking da API e qual parte precisa aparecer para o usuário?”.
O que mudou nos modelos de raciocínio
Uma forma prática de pensar no prompting atual é separar três camadas que antes costumavam ser misturadas.
A primeira camada é a especificação da tarefa. Ela inclui objetivo, contexto, restrições, dados disponíveis, critérios de sucesso e formato de saída. Essa camada continua sendo responsabilidade do prompt. Quanto mais ambígua for a tarefa, mais importante é torná-la explícita.
A segunda camada é a alocação de raciocínio. Em várias APIs atuais, isso pode ser controlado por parâmetros como reasoning effort, effort ou thinking level. Esse controle determina quanto trabalho interno o modelo pode dedicar antes ou durante a produção da resposta. Ele substitui, em parte, o antigo impulso de tentar “forçar” profundidade repetindo instruções como “pense mais”, “reflita” ou “revise várias vezes”.
A terceira camada é a explicação visível. Uma boa explicação não precisa ser a transcrição do raciocínio interno. Para a maioria dos produtos, é mais útil pedir uma justificativa verificável: premissas usadas, cálculo essencial, evidências, limitações, critérios de decisão e conclusão. Isso produz uma saída auditável sem depender de uma cadeia interna completa.
Essa separação resolve uma confusão recorrente. “Quero que o modelo raciocine melhor” e “quero que o usuário entenda por que a resposta faz sentido” são objetivos diferentes. O primeiro pode ser tratado pelo modelo e pela API; o segundo precisa ser especificado na saída.
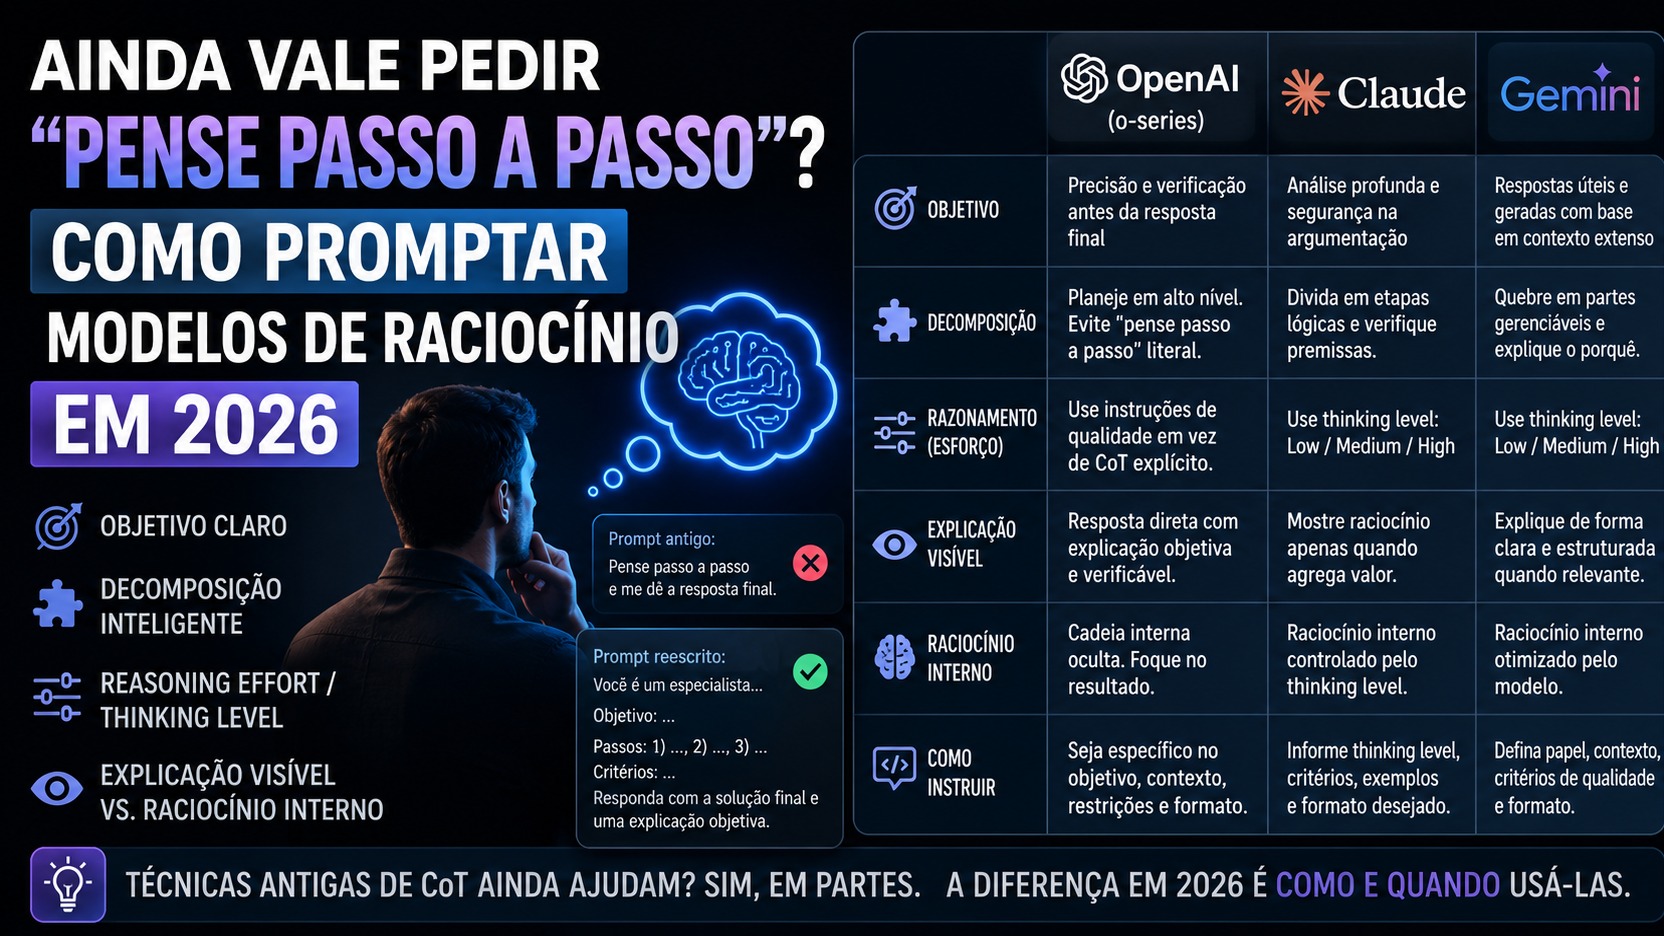
Matriz prática: OpenAI, Claude e Gemini
Os três ecossistemas caminharam para a mesma direção geral - mais raciocínio interno e mais controles de inferência -, mas não usam a mesma interface. Copiar o mesmo prompt e os mesmos parâmetros entre provedores é uma estratégia frágil.
OpenAI: objetivo e critérios no prompt, esforço na API
A orientação oficial da OpenAI para modelos de raciocínio é direta: prompts simples e claros tendem a funcionar melhor, e instruções para “pensar passo a passo” ou “explicar seu raciocínio” são desnecessárias para essa família. A documentação também recomenda definir de forma específica o objetivo final e as restrições que caracterizam uma resposta bem-sucedida.
Nos modelos atuais da família GPT-5.6, a API oferece reasoning.effort com níveis que podem incluir none, low, medium, high, xhigh e max, dependendo do modelo. A ideia não é selecionar sempre o maior valor. A recomendação prática é testar o menor esforço que ainda mantém a qualidade exigida no seu workload e subir quando avaliações representativas mostrarem ganho real.
Isso muda a função do prompt. Em vez de escrever “pense muito, considere alternativas, verifique tudo e só depois responda”, é mais eficiente dizer o que precisa ser entregue: “identifique os riscos que podem causar perda de dados, estime impacto e probabilidade, proponha mitigação e priorize os cinco mais importantes”. O modelo recebe um alvo verificável; o esforço de raciocínio fica no parâmetro apropriado.
Quando for necessário mostrar ao usuário como a conclusão foi sustentada, peça uma explicação objetiva, as evidências relevantes ou um resumo do raciocínio disponível. Não trate a cadeia interna completa como requisito de produto.
Claude: adaptive thinking e effort substituem scaffolds antigos
No Claude atual, a mudança é igualmente clara. Claude Sonnet 5 opera com adaptive thinking por padrão, e o parâmetro de effort controla o equilíbrio entre inteligência, tokens, custo e latência. Nos modelos recentes, a Anthropic recomenda subir o effort quando uma tarefa complexa estiver recebendo raciocínio superficial, em vez de tentar compensar com um grande roteiro de instruções.
A própria documentação de prompting da Anthropic sugere preferir orientações gerais a etapas excessivamente prescritivas. Um pedido como “pense cuidadosamente sobre o problema” pode ser mais útil do que um plano humano rígido de seis ou dez passos, porque o modelo pode encontrar uma estratégia melhor do que a sequência escrita pelo autor do prompt.
Isso não torna instruções de processo inúteis. Elas continuam importantes quando o processo é parte da tarefa. Se há uma ordem operacional que precisa ser respeitada, uma aprovação antes de uma ação, uma fonte que deve ser consultada ou um checkpoint de validação, descreva essas etapas. O que perdeu valor é usar um pseudoalgoritmo de raciocínio apenas para tentar deixar o modelo “mais inteligente”.
Há ainda uma diferença de versão que merece atenção. Configurações antigas de Claude usavam thinking com budget_tokens em alguns modelos. Nos modelos recentes, a Anthropic migrou para adaptive thinking e effort. Prompts e código de 2024 ou 2025 podem, portanto, carregar uma técnica ou um parâmetro que já não representa a melhor prática atual.
Gemini: thinking level é o controle principal da série 3
No Gemini, os modelos das séries 3 e 2.5 usam processo de thinking, mas os controles variam por geração. Na série Gemini 3, o parâmetro thinking_level controla a profundidade máxima relativa do raciocínio. Os níveis disponíveis dependem do modelo e podem incluir minimal, low, medium e high. A documentação também orienta usar menos thinking em tarefas simples e aumentar o nível em problemas complexos de programação, matemática ou planejamento multietapa.
O guia da série Gemini 3 é especialmente explícito sobre prompting: instruções diretas e concisas tendem a funcionar melhor, enquanto técnicas de prompt engineering muito verbosas ou complexas, herdadas de modelos antigos, podem induzir análise excessiva. Para migrações, o Google recomenda experimentar prompts simplificados e usar o controle de thinking em vez de depender de Chain of Thought textual.
Na série Gemini 2.5, thinking_budget ainda aparece como mecanismo de controle em determinados modelos. Por isso, “Gemini” não deve ser tratado como uma API uniforme. Antes de reutilizar um prompt, confirme se o modelo trabalha com budget, level ou comportamento dinâmico e quais valores ele realmente suporta.
O Gemini também separa pensamento interno de apresentação. A API pode fornecer resumos de thought quando configurada para isso, enquanto a resposta final continua sendo um artefato distinto. Novamente, a regra útil é pedir ao modelo uma explicação adequada ao usuário, não pressupor que a cadeia interna completa seja a melhor forma de justificativa.
Quatro prompts antigos reescritos para 2026
O clássico “pense passo a passo”
Prompt antigo: “Resolva este problema. Pense passo a passo e só depois dê a resposta.”
Versão atual: “Resolva este problema. Considere todas as restrições fornecidas, verifique se a conclusão é consistente com os dados e entregue a resposta final com uma justificativa curta e verificável.”
A versão nova não tenta descrever como o modelo deve pensar. Ela descreve o que significa uma resposta aceitável. Em um reasoning model, esse geralmente é um sinal melhor.
“Mostre todo o seu raciocínio”
Prompt antigo: “Mostre todo o seu raciocínio interno, sem pular nenhuma etapa.”
Versão atual: “Dê a conclusão e explique os elementos necessários para verificá-la: premissas relevantes, cálculo essencial, evidências usadas e qualquer incerteza que possa mudar a decisão.”
Essa troca melhora o contrato de saída. O leitor recebe material para checar a resposta, sem transformar o processo interno do modelo em requisito.
“Revise, repense e confira três vezes”
Prompt antigo: “Faça a análise, revise tudo, repense a solução e confira três vezes antes de responder.”
Versão atual: “Critérios de sucesso: não omitir dependências, detectar inconsistências entre os dados, sinalizar informação insuficiente e não afirmar uma conclusão que não possa ser sustentada.”
Em modelos que já fazem autoavaliação ou verificação interna, repetir comandos de revisão pode apenas aumentar custo e latência. Critérios objetivos permitem medir se a resposta passou ou falhou.
Um roteiro rígido de dez etapas
Prompt antigo: “Primeiro identifique o problema, depois liste hipóteses, depois gere três opções, depois critique cada opção, depois escolha uma...”
Versão atual: “Objetivo: escolher a alternativa mais adequada. Considere custo, risco, reversibilidade e impacto. Compare as opções relevantes, descarte as que violarem restrições e entregue a recomendação com os critérios que determinaram a escolha.”
O roteiro detalhado ainda faz sentido se cada etapa produzir um artefato que outra parte do sistema precisa consumir. Se não há esse requisito, deixe o modelo escolher a estratégia interna e descreva apenas os critérios de decisão.
Quando decompor ainda é a técnica certa
A queda do CoT explícito como truque universal não reduz o valor da decomposição de workflow. Na verdade, essa distinção ficou mais importante.
Dividir uma tarefa em chamadas separadas continua sendo útil quando uma etapa precisa ser inspecionada antes da próxima, quando ferramentas diferentes são acionadas em momentos distintos, quando há aprovação humana, quando o resultado intermediário precisa ser armazenado ou quando uma falha deve ser isolada sem refazer todo o processo.
Também faz sentido decompor quando o sistema precisa aplicar modelos diferentes a partes diferentes do trabalho. Um modelo pode extrair dados, outro avaliar evidências e um terceiro redigir a saída final. Aqui, a cadeia existe na arquitetura da aplicação, não como uma tentativa de tornar visível o raciocínio interno de uma única chamada.
O erro comum é confundir essas duas coisas. “Execute estas três etapas porque o meu pipeline depende delas” é uma instrução operacional legítima. “Execute estas dez etapas porque imagino que essa seja a melhor maneira de pensar” é uma hipótese de prompting que precisa ser testada, não presumida.
Como escolher reasoning effort ou thinking level
A regra mais segura é tratar esforço como um parâmetro de desempenho, não como um selo de qualidade. Mais thinking pode melhorar tarefas difíceis, mas também aumenta tokens, custo e tempo até a resposta. Em tarefas simples, um nível alto pode gastar recursos sem ganho mensurável.
Comece com uma configuração intermediária ou com o padrão recomendado pelo modelo. Depois, execute a mesma bateria de tarefas em um nível abaixo e em um nível acima. Compare acerto, completude, aderência às restrições, uso correto de ferramentas, latência e custo. O melhor nível é o menor que atende de forma consistente ao seu critério de qualidade.
Essa avaliação precisa usar exemplos reais do produto. Um benchmark de matemática não prevê necessariamente o comportamento em atendimento, análise documental, extração estruturada ou automação com tools. O parâmetro deve ser calibrado no workload que realmente vai para produção.
Também é importante testar prompt e esforço separadamente. Se você muda o texto do prompt e o thinking level ao mesmo tempo, fica difícil saber qual alteração causou o ganho ou a regressão. Em migrações de modelo, preserve uma baseline, troque uma variável de cada vez e registre o efeito.
Explicação visível não é Chain of Thought
Há um motivo adicional para abandonar a exigência de “mostrar todo o raciocínio”: uma boa interface raramente precisa disso.
Em uma análise financeira, o usuário quer saber quais números foram usados, qual fórmula foi aplicada e quais hipóteses alteram o resultado. Em uma revisão de código, quer a linha problemática, o impacto e a correção sugerida. Em uma decisão de compra, quer critérios, trade-offs e limites. Em pesquisa, quer fontes, método e grau de confiança.
Esses elementos são verificáveis e acionáveis. Eles podem ser pedidos explicitamente no prompt e avaliados por testes. Uma transcrição extensa de raciocínio, por outro lado, pode ser longa, difícil de auditar e nem sempre corresponde à melhor interface para justificar uma conclusão.
Por isso, o padrão recomendado é especificar a evidência que deve aparecer. Peça “cite os dados usados”, “mostre o cálculo essencial”, “explique os dois critérios que mais pesaram”, “aponte a incerteza dominante” ou “diga o que faria a conclusão mudar”. Isso produz transparência útil sem transformar o raciocínio interno em produto.
O que ainda vale aprender do Chain of Thought clássico
O CoT antigo continua ensinando duas ideias importantes. A primeira é que tarefas complexas se beneficiam de estrutura. A segunda é que modelos podem responder melhor quando recebem sinais claros de que uma conclusão exige múltiplas relações e não apenas recuperação superficial.
O que mudou é a forma de aplicar essas ideias. Em modelos sem recursos modernos de reasoning, em modelos menores ou em tarefas específicas, exemplos com raciocínio intermediário ainda podem ajudar e devem ser avaliados empiricamente. Nos reasoning models atuais, porém, o ponto de partida mais robusto é um prompt orientado ao resultado, combinado com o controle de esforço que a API oferece.
Se uma tarefa falhar, evite adicionar automaticamente mais frases como “pense melhor”, “seja muito cuidadoso” ou “faça passo a passo”. Primeiro pergunte qual informação faltou no contrato. O objetivo estava claro? As restrições estavam explícitas? O modelo sabia o que significava sucesso? O formato de saída permitia verificar o resultado? O effort estava adequado à complexidade? Havia uma etapa que deveria ser realmente separada no workflow?
Essa sequência de diagnóstico costuma produzir prompts mais portáveis entre provedores e mais fáceis de manter ao longo das mudanças de modelo.
A regra prática para 2026
Para modelos de raciocínio, trate “pense passo a passo” como uma técnica histórica útil, não como uma frase obrigatória. Comece pelo objetivo, contexto, restrições, critérios de sucesso e formato de saída. Use reasoning effort, effort ou thinking level quando o provedor oferecer esse controle. Prescreva etapas apenas quando elas fizerem parte do processo que precisa ser executado ou auditado.
E, quando a resposta precisar ser explicada, peça uma justificativa verificável em vez de uma cadeia interna completa. A engenharia de prompts em 2026 está menos preocupada em ensinar o modelo a pensar como você imaginou e mais preocupada em definir com precisão o que ele precisa resolver, quanto esforço deve gastar e qual evidência precisa aparecer na resposta.