El almacenamiento en caché de mensajes funciona mejor cuando trata el comienzo del mensaje como una interfaz estable, no como un documento que se puede volver a ensamblar con cada llamada. La idea central es simple: si varias solicitudes comienzan con un prefijo reutilizable, el proveedor puede reutilizar el trabajo ya realizado en el procesamiento de ese segmento. Si algo cambia demasiado pronto, el tramo común se reduce y parte del beneficio desaparece.
Esto explica un comportamiento que a menudo parece contradictorio. Dos mensajes pueden ser prácticamente iguales para una persona y aun así no aprovechar el mismo caché. El mecanismo no pregunta si los textos tienen el mismo significado. Trabaja con la estructura realmente enviada al modelo, respetando reglas de prefijos, límites mínimos, puntos de caché, vida útil y disponibilidad definidas por cada proveedor.
Qué se reutiliza realmente el almacenamiento en caché de avisos
Antes de generar la respuesta, el modelo necesita procesar el contexto de entrada. En este paso, llamado prerrelleno, el sistema calcula las representaciones internas utilizadas por el mecanismo de atención. Los servicios de almacenamiento en caché rápidos convierten parte de este trabajo en un recurso reutilizable entre llamadas que comparten un prefijo compatible.
Esto es diferente de la memoria de la aplicación. La caché no reemplaza la base de datos, el historial persistente, el RAG, el estado de la sesión ni la memoria del agente. Usted sigue siendo responsable de enviar o hacer referencia al contenido requerido para la tarea. La ganancia proviene de evitar el procesamiento repetido de una pieza que el proveedor ya ha visto y puede reconocer como reutilizable.
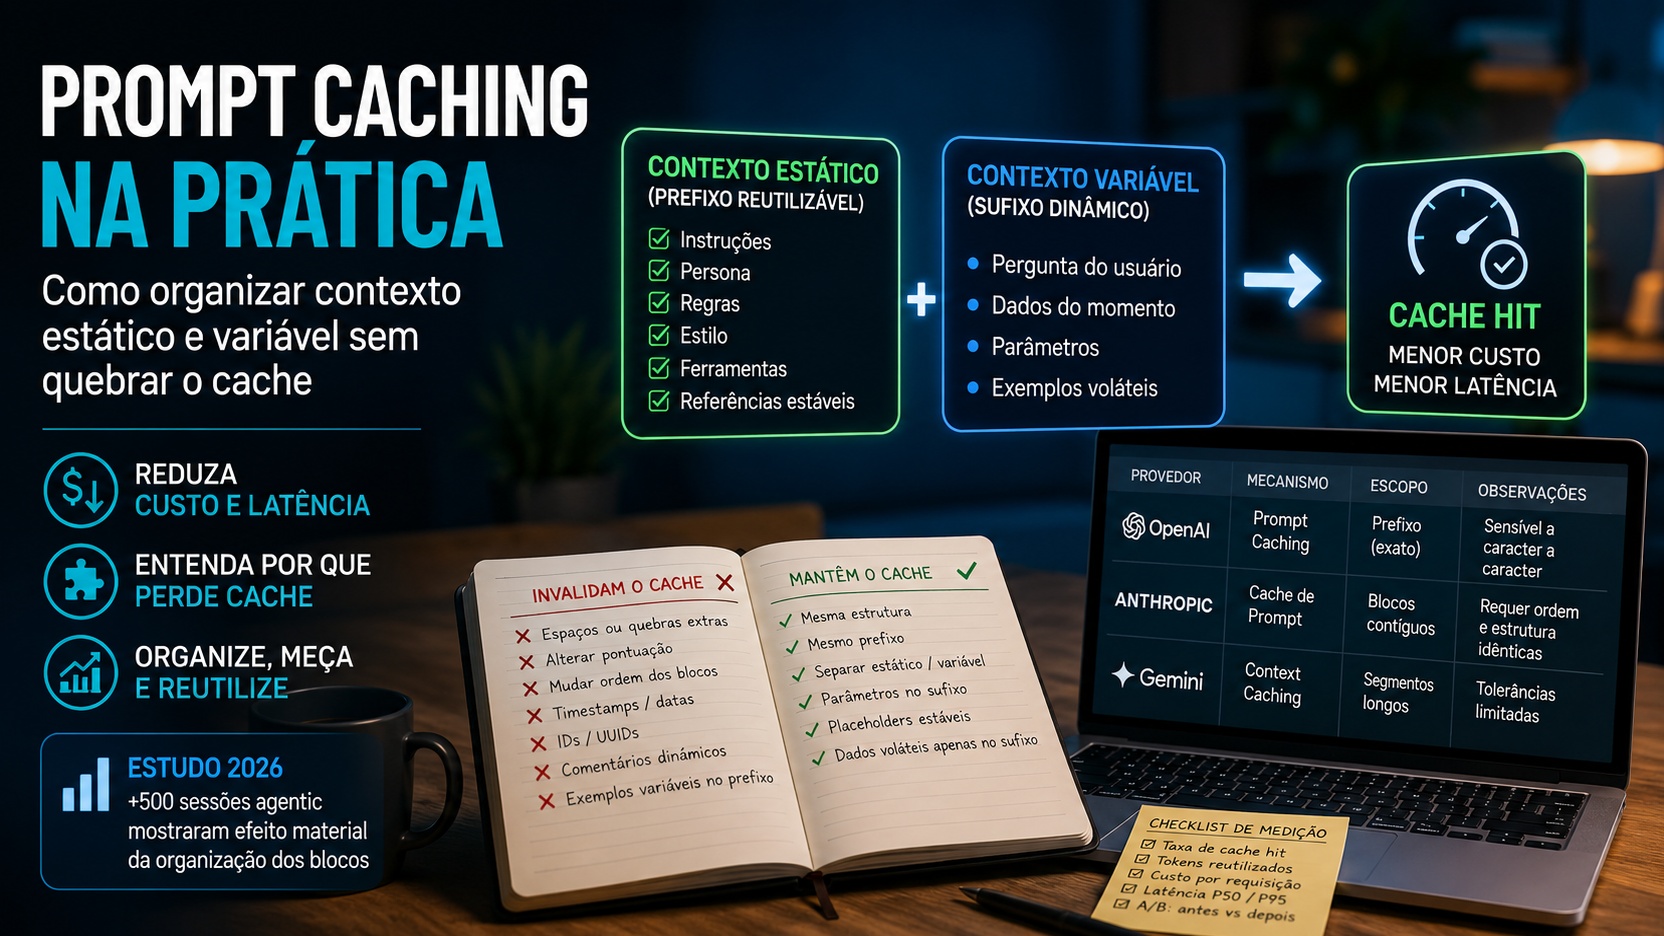
En la práctica, piense en un mensaje como dos regiones. El primero contiene lo que cambia poco: instrucciones del sistema, políticas, ejemplos, definiciones de herramientas, esquemas y referencias estables. El segundo se centra en lo que cambia con cada ejecución: pregunta del usuario, identificadores, marca de tiempo, datos recuperados en ese momento, resultados de la herramienta y parámetros específicos.
solicitud.
Cuanto antes aparezca la parte variable, más pequeño tiende a ser el prefijo que se puede reutilizar. Cuanto más estable y largo sea el prefijo inicial, mayor será la oportunidad de almacenamiento en caché, siempre que supere el umbral mínimo y se mantenga dentro de las reglas del proveedor.
La regla general: primero el prefijo estático, después los datos variables
La organización más sólida comienza con el contenido que realmente comparten varias solicitudes. Al principio pertenecen las instrucciones permanentes, las reglas comerciales, los formatos de salida, los ejemplos estables de algunas tomas, las descripciones de herramientas y el material de referencia reutilizado. El contenido por usuario o por ejecución debe ir más allá del límite reutilizable.
Esta frontera no tiene por qué ser un concepto abstracto. En las API que ofrecen puntos de interrupción explícitos, se puede marcar directamente. En los mecanismos automáticos, aún puedes estructurar el mensaje para que el prefijo repetido sea idéntico y lo suficientemente largo antes de que comience a variar.
También vale la pena separar los datos operativos que no necesitan estar en contexto. Un ID de solicitud utilizado solo para registros, por ejemplo, no debe ocupar una posición en el prefijo estático si la API ofrece metadatos para este propósito. Lo mismo ocurre con las marcas de tiempo colocadas en el mensaje por conveniencia pero sin ninguna función real en la respuesta.
Antes y después: el mismo agente con diferentes estructuras
Antes: solicitar cambios antes de llegar a la parte reutilizable
Imagine un agente que ensambla cada llamada en este orden: marca de tiempo actual, ID de solicitud, perfil de usuario, lista de herramientas habilitadas en ese momento, instrucciones generales, ejemplos y, finalmente, la pregunta. El sistema puede incluso repetir casi todo el texto, pero los primeros bloques cambian con cada ejecución. La similitud visual es alta; el prefijo reutilizable no.
Si la aplicación aún serializa los esquemas de herramientas en un orden diferente entre llamadas, el problema aumenta. Cambiar el orden de las herramientas, propiedades o bloques dentro de la región almacenable en caché puede generar un prefijo diferente incluso cuando la intención es la misma.
Después: el prefijo es deliberadamente estable
Una versión más compatible con el caché comienza con instrucciones estables del sistema, políticas, herramientas en orden determinista, esquemas, ejemplos y contexto de referencia que realmente se repiten. Luego viene el borde rizado. Sólo entonces ingresan el perfil específico del usuario, la pregunta, los ID, la marca de tiempo y los datos recuperados en esa ejecución.
El cambio parece sólo editorial, pero es arquitectónico. No pregunta "¿este mensaje es similar al anterior?" y continúa preguntando "¿cuál es el prefijo idéntico más grande que vale la pena reutilizar?". Esta segunda pregunta se acerca mucho más a la forma en que se documentan los mecanismos.
Lo que rompe el caché sin que parezca un gran cambio
Pequeños cambios dentro del prefijo
En OpenAI, la documentación actual requiere una coincidencia exacta de prefijos para los aciertos de caché. Por lo tanto, los cambios en el contenido, el orden, las imágenes, las herramientas o los esquemas antes del límite relevante pueden reducir la reutilización. Los espacios, saltos de línea y puntuación también pueden importar cuando cambian la tokenización de la sección que debería permanecer estable.
En Claude, el caché se calcula en función del prefijo formado por herramientas, sistema y mensajes hasta el punto de interrupción. La propia documentación advierte que los cambios a bloques anteriores al punto de caché
producir otro hash. También recomienda mantener estable el orden de las claves en los bloques de uso de herramientas, porque la serialización no determinista puede interrumpir la reutilización.
La lección es no congelar toda la aplicación. Está haciendo que la pieza que esperas reutilizar sea determinista.
Herramientas y esquemas que cambian según la solicitud
Las definiciones de herramientas tienden a ser grandes y, por lo tanto, parecen candidatas naturales para el almacenamiento en caché. El problema surge cuando la aplicación crea una lista diferente para cada llamada. Agregar, eliminar, reordenar o reescribir descripciones de herramientas dentro del prefijo puede reducir las visitas.
Una alternativa es mantener estable la definición base y controlar la disponibilidad a través de mecanismos específicos de API cuando existan. En OpenAI, por ejemplo, la documentación recomienda dejar la matriz de herramientas sin cambios y usar Authorized_tools cuando sea compatible, en lugar de reconstruir la lista solo para restringir el subconjunto disponible.
Historia reescrita en lugar de simplemente ampliada
En conversaciones largas, una estrategia de almacenamiento en caché simple es preservar el historial anterior y solo agregar mensajes nuevos. Cuando la aplicación reescribe mensajes antiguos, reordena eventos, cambia resúmenes o comprime secciones anteriores, el prefijo también cambia.
La compresión aún puede ser una buena decisión para reducir el contexto total. El punto es que tiene un costo de oportunidad: un contexto más pequeño puede ser más barato, pero la reescritura puede restablecer una región que estaba siendo reutilizada. La decisión correcta depende de medir ambos y no asumir que menos tokens enviados siempre significan un menor costo efectivo.
TTL, límite mínimo y disponibilidad
No todas las pérdidas de caché son consecuencia de un cambio en el mensaje. Los proveedores imponen tamaños y vidas mínimos. Algunos mecanismos también son de mejor esfuerzo: el contenido puede seguir siendo idéntico y, aun así, no hay ninguna entrada disponible en la infraestructura que responda a esa llamada.
Por lo tanto, “el mensaje es el mismo” no es suficiente como diagnóstico. Necesita saber si el prefijo ha alcanzado el mínimo, si la entrada aún está activa, si hubo una escritura previa en el punto correcto y si la API informó que los tokens realmente se leyeron del caché.
OpenAI, Claude y Gemini: misma idea, diferentes controles
Los tres ecosistemas convergen en la importancia del contenido común al principio, pero no exponen exactamente la misma interfaz. Tratar a todos como si tuvieran la misma política tiende a generar configuraciones frágiles.
AI abierta
La documentación de OpenAI describe el almacenamiento en caché automático de solicitudes elegibles y enfatiza que los aciertos de caché dependen de prefijos exactos. Para GPT-5.6 y familias posteriores, el mínimo almacenable en caché es 1024 tokens y la API también ofrece puntos de interrupción explícitos además del modo implícito.
En estos modelos más nuevos, un punto de interrupción marca el final del prefijo reutilizable. El contenido posterior podrá variar sin invalidar el prefijo anterior. La documentación también recomienda utilizar una Prompt_cache_key consistente para mejorar la coincidencia entre llamadas relacionadas. Para medir los resultados, cached_tokens muestra la lectura del caché; En GPT-5.6 y versiones posteriores, cache_write_tokens le ayuda a ver cuándo la aplicación escribe demasiado y reutiliza muy poco.
Los modelos anteriores mantienen un comportamiento automático con límites mínimos que varían según el modelo. La implicación práctica es no codificar una única regla de tamaño para toda la flota sin comprobar el modelo realmente utilizado.
Claude
En Claude, el desarrollador puede usar cache_control en modo automático o colocar puntos de interrupción explícitos en bloques individuales. El prefijo sigue al orden herramientas, sistema y mensajes. La documentación recomienda colocar contenido estático al principio y marcar el final de la región que permanece idéntica entre llamadas.
El TTL predeterminado es de cinco minutos, con una opción de una hora según otra estructura de precios. Los tamaños mínimos también varían según el modelo. Para diagnosticar, la respuesta separa los tokens de creación y lectura de caché, lo que le permite distinguir una llamada que escribió una entrada de una que realmente la reutilizó.
Un detalle importante es que Claude realiza una búsqueda en bloque cuando busca entradas escritas anteriormente, pero esto no transforma el contenido inestable en contenido estable. Si el punto de interrupción se coloca en un bloque que cambia con cada solicitud y no hay una entrada anterior adecuada, la aplicación continuará creando nuevos prefijos en lugar de reutilizar lo previsto.
Géminis
En Gemini, el almacenamiento en caché implícito está habilitado de forma predeterminada en Gemini 2.5 y modelos posteriores. La documentación recomienda colocar contenido común de gran tamaño al principio y enviar solicitudes con prefijos similares en un intervalo corto.. Los límites mínimos dependen del modelo: en la documentación consultada en agosto de 2026, los modelos Gemini 2.5 enumeran un mínimo de 2048 tokens, mientras que varias familias 3.x enumeran 4096.
GenerateContent también ofrece almacenamiento en caché explícito en el que la aplicación crea un objeto de caché y hace referencia a él en llamadas posteriores. En este modo, el TTL predeterminado es una hora si no está configurado, y el costo considera tanto los tokens almacenados en caché como el tiempo de almacenamiento. La API de Interacciones solo documenta el almacenamiento en caché implícito.
Para la operación, esto significa que “Gemini tiene caché” no responde qué caché se está utilizando. Debe distinguir el mecanismo automático del objeto de caché explícito y medir los tokens reportados como reutilizados en los metadatos de uso.
Lo que añade el estudio de 2026 a las pruebas de producción
La preimpresión Don't Break the Cache, de Elias Lumer y sus coautores, evaluó el almacenamiento en caché de avisos en más de 500 sesiones de agentes en DeepResearch Bench, con avisos del sistema para 10 mil tokens, que cubren OpenAI, Anthropic y Google. El estudio comparó el almacenamiento en caché de contexto completo, el almacenamiento en caché de solo avisos del sistema y una estrategia que excluía los resultados dinámicos de las herramientas.
El resultado más útil no es un único porcentaje, sino la diferencia entre estrategias. Los autores encontraron reducciones de costos del 41% al 80% en los modelos evaluados y demostraron que las mejoras en la latencia varían más según el proveedor y la configuración. En una de las condiciones, el ingenuo caché de contexto completo en realidad empeoró el tiempo hasta el primer token, porque el contenido dinámico generaba trabajo de escritura sin reutilización proporcional.
La conclusión operativa converge con la arquitectura de prefijo estático: controlar el límite de la caché era más consistente que intentar almacenarlo todo. En el conjunto de estudio principal, el almacenamiento en caché de solo aviso del sistema apareció como una estrategia especialmente estable entre costo y latencia, aunque la mejor configuración absoluta varió según el modelo.
Este tipo de punto de referencia no reemplaza su propia medición. El propio artículo destaca que TTFT sufre variaciones en carga, región e infraestructura. Lo que proporciona es una fuerte hipótesis de ingeniería para probar: antes de aumentar el TTL o intentar almacenar en caché más bloques, elimine el contenido volátil de la región reutilizable.
Cómo medir si la reorganización realmente funcionó
Tasa de solicitudes de aciertos de caché
Cuente cuántas llamadas devuelven algún volumen de tokens leídos del caché. Esta métrica ayuda a detectar regresiones repentinas, pero por sí sola no informa la magnitud del beneficio. Un acierto de unos pocos tokens y un acierto de decenas de miles aparecen igualmente como una "solicitud en caché".
Proporción de tokens reutilizados
Realice un seguimiento de cuántos tokens de entrada se leyeron del caché en relación con el volumen de entrada que podría reutilizarse. Esta es una métrica más cercana al efecto económico del diseño del prefijo. Si la tasa de solicitudes de visitas es alta pero la proporción de tokens reutilizados es baja, la frontera puede ser demasiado temprana.
Relación entre escritura y lectura
Cuando la API expone tokens de creación o escritura, compárelos con tokens de lectura. Una aplicación que escribe repetidamente en caché y apenas la lee está pagando el costo de mantenimiento sin capturar el beneficio esperado. Este patrón suele indicar un punto de interrupción mal posicionado, TTL incompatible con la cadencia o contenido variable dentro de la región escrita.
Coste efectivo por solicitud
Utilice el precio del modelo realmente contratado y separe la entrada normal, la escritura en caché, la lectura en caché y la salida cuando el proveedor haga esta distinción. No se limite a comparar el "total de tokens", porque un token leído del caché puede tener un precio diferente al de un token procesado desde cero.
TTFT en p50 y p95
El almacenamiento en caché de mensajes afecta principalmente al procesamiento de entrada, por lo que el tiempo hasta el primer token es una métrica más sensible que la duración total cuando la salida es larga. Mida al menos la mediana y la cola. Una mejora de p50 acompañada de una fuerte regresión de p95 puede ser mala para una aplicación interactiva.
A/B antes y después con la misma carga
Compare el marco antiguo y el nuevo utilizando el mismo conjunto de solicitudes, modelo, región y patrón de simultaneidad. Realice llamadas de preparación cuando sea necesario, separe la primera escritura de las lecturas posteriores y no mezcle cambios rápidos con cambios de modelo en el mismo experimento.
Una lista de verificación arquitectónica que evita la mayoría de errores de caché
Antes de culpar al proveedor, compruebe si el prefijo realmente permanece estable entre solicitudes. Las instrucciones, ejemplos, herramientas y esquemas deben tener una serialización determinista. Los datos por usuario, los ID de solicitud, las marcas de tiempo y los resultados de la herramienta deben aparecer después de la parte reutilizable siempre que la semántica lo permita.
Confirma también el umbral mínimo del modelo y el TTL del motor utilizado. Luego valide la telemetría de la propia API: tokens de caché leídos, tokens escritos cuando estén disponibles, costo y TTFT. Si el sistema solo registra el total de tokens, es difícil distinguir un problema de almacenamiento en caché de un simple cambio en el tamaño del contexto.
Finalmente, trate el caché como una optimización, no como un requisito funcional. Un error de caché no debería cambiar la respuesta correcta ni interrumpir el flujo del agente. El sistema debe funcionar sin almacenamiento en caché y ser más económico o más rápido cuando se reutiliza.
El objetivo no es torcerlo todo; es preservar lo que realmente se repite
El almacenamiento en caché rápido recompensa la arquitectura predecible. El mejor prefijo no es el más largo posible, sino el fragmento más largo que sea al mismo tiempo estable, reutilizado con frecuencia y compatible con el modelo y las reglas API.
Cuando el coste o la latencia empeoran, la primera investigación debe ser estructural: ¿dónde aparecen los primeros datos variables? ¿Están cambiando las herramientas y los esquemas? ¿Se reescribe la historia antigua? ¿El punto de interrupción está después del bloque derecho? ¿TTL cubre la cadencia real? ¿La telemetría muestra lectura o simplemente escritura nueva?
Organizar primero el contexto estático y luego el contexto variable convierte estas preguntas en decisiones mensurables. En lugar de esperar que el caché funcione, diseña el mensaje para que genere un prefijo reutilizable y pueda demostrar, con sus propios datos de uso, si la optimización está dando sus frutos.