La elección entre RAG y contexto largo no debe comenzar con la pregunta "¿cuántos tokens caben en el modelo?". La ventana de contexto define cuánto material se puede enviar a la vez, pero no decide por sí sola qué arquitectura es la más adecuada. El formato del corpus, la frecuencia de actualización, el tipo de pregunta, la necesidad de rastrear las fuentes, la repetición de consultas y el costo por llamada cambian la respuesta.
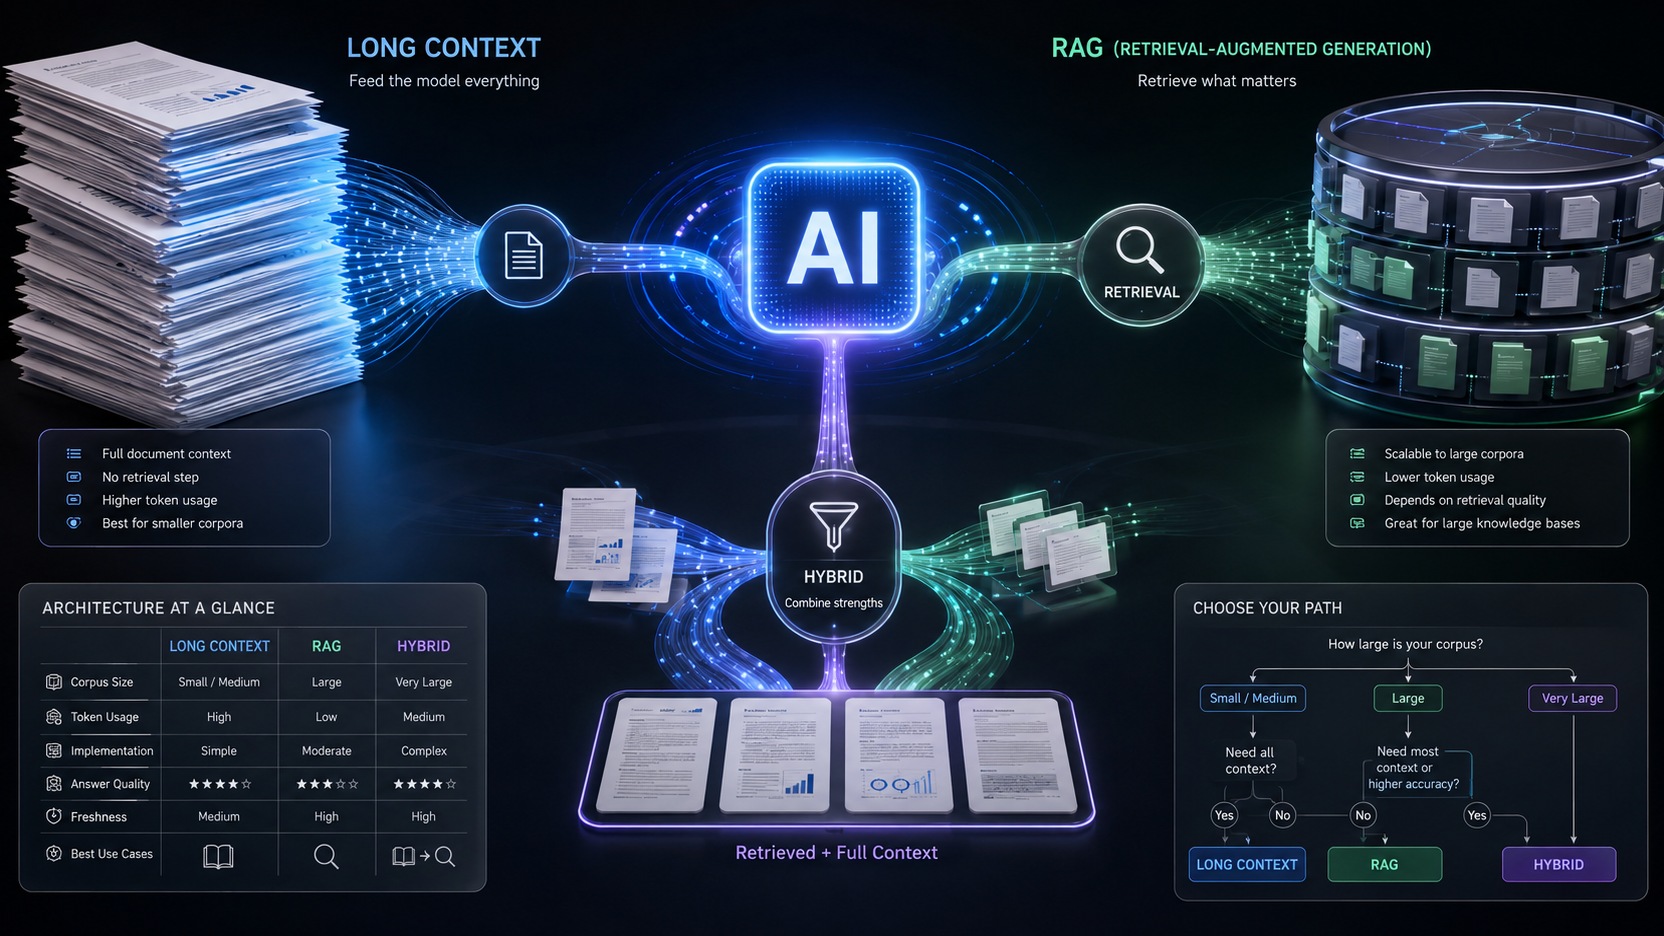
La regla general es la siguiente: el contexto largo tiende a ser más atractivo cuando el conjunto de documentos es limitado, coherente y debe leerse en su conjunto; RAG tiende a ganar cuando la base es extensa, crece o cambia con frecuencia y cada pregunta depende de una pequeña fracción de ella; El híbrido surge cuando algunas preguntas requieren una visión global y otras requieren una recuperación selectiva, o cuando desea utilizar la búsqueda para reducir el universo y aun así darle al modelo documentos completos para razonar.
Lo importante es tratar esto como una decisión comprobable. En lugar de declarar a RAG "obsoleto" porque un modelo acepta cientos de miles o millones de tokens, compare las tres estrategias con las mismas preguntas, los mismos documentos y métricas que representan su uso real.
El contexto largo no es solo "RAG sin banco de vectores"
En el contexto largo, usted coloca directamente todos los documentos relevantes, o una parte suficientemente grande de ellos, en el mensaje y le pide al modelo que trabaje en ese material. La documentación actual de Gemini describe modelos con ventanas de 1 millón de tokens o más y presenta usos como sintetizar grandes conjuntos de texto y hacer preguntas y respuestas sobre material extenso. Esto viabiliza un camino que, años atrás, necesariamente requeriría filtrado o recuperación externa.
La ventaja arquitectónica es la simplicidad. No hay ningún paso de fragmentación, generación de incrustaciones, indexación, búsqueda, reclasificación o lógica para decidir qué fragmentos se incluyen en la llamada. Las relaciones que abarcan varias páginas o documentos también permanecen disponibles para el modelo sin depender de que un recuperador haya seleccionado todas las piezas necesarias.
Pero “cabe en la ventana” no significa “es gratis, rápido e infalible”. La larga guía de contexto de Google recomienda evitar tokens innecesarios, señala que las entradas más grandes tienden a aumentar el tiempo hasta el primer token y destaca que las tareas con múltiples elementos relevantes distribuidos en el contexto pueden tener un comportamiento menos consistente que las pruebas simples para encontrar una sola pieza de información.
Por este motivo, el contexto largo resulta especialmente interesante cuando la pregunta requiere una visión global. Resumir un dossier, comparar argumentos distribuidos en varios capítulos, detectar contradicciones entre documentos o interpretar un conjunto que tiene sentido como unidad son tareas en las que cortar el material antes de la inferencia puede eliminar relaciones importantes.
RAG es una arquitectura de selección, no solo una solución para ventanas pequeñas
RAG, para generación con recuperación aumentada, agrega un paso de recuperación antes de la generación. En una implementación típica, el corpus se divide, indexa y consulta; los extractos considerados más relevantes para la pregunta entran en el contexto del modelo. La arquitectura reduce la cantidad de material procesado en cada llamada y permite trabajar con bases de datos mucho más grandes de lo que sería razonable enviar completo.
Esta selección sigue siendo útil incluso cuando el modelo tiene una ventana enorme. La documentación de Anthropic para aplicaciones de soporte, por ejemplo, advierte que colocar grandes cantidades de contexto estático y dinámico en cada solicitud puede aumentar el costo, la latencia y el riesgo de alcanzar límites, y recomienda RAG cuando la recuperación selectiva mejora la eficiencia y la capacidad de respuesta.
El precio de esta eficiencia es la dependencia de la recuperación. Si no se recupera el fragmento correcto, el generador no podrá utilizarlo. Si un hecho depende de dos fragmentos separados y sólo se recupera uno, la respuesta puede parecer plausible y aun así estar incompleta. Si la fragmentación rompe una definición en el punto equivocado, si el índice no está actualizado o si la búsqueda semántica no captura un identificador exacto, el problema ocurre antes de que el modelo comience a responder.
La propia Anthropic publicó un enfoque de “recuperación contextual” para reducir estos defectos, combinando contexto adicional en fragmentos, incrustaciones, búsqueda léxica y reclasificación. El detalle es revelador: RAG no es un algoritmo único. Es una cadena de decisiones de recuperación que debe diseñarse y evaluarse.
La ruta híbrida evita un binario falso
Hay al menos dos formas comunes de combinar estrategias. La primera es recuperar un conjunto más pequeño de documentos y, en lugar de enviar solo fragmentos pequeños, enviar documentos completos o fragmentos grandes al modelo para preservar las relaciones locales. La segunda es crear un enrutador: las preguntas específicas pasan por RAG, mientras que las preguntas globales reciben un contexto mucho más amplio.
Un estudio de 2024 realizado por Li y sus colegas comparó modelos RAG y de contexto largo en varios conjuntos de datos. En los puntos de referencia utilizados por los autores, el contexto largo tuvo un mejor rendimiento promedio cuando había recursos suficientes, mientras que RAG mantuvo una ventaja de costos. El trabajo propuso un método de enrutamiento entre las dos opciones para reducir costos sin perder gran parte del rendimiento del contexto largo.
Otra preimpresión, publicada en 2025 por Li y sus colaboradores, encontró una imagen aún menos binaria: el contexto largo fue generalmente mejor en las tareas de preguntas y respuestas evaluadas por los autores, pero RAG mostró ventajas en ciertos escenarios de diálogo y preguntas generales; Las estrategias de recuperación basadas en resúmenes también se aproximaron al contexto largo en algunas pruebas. Estos resultados no producen una regla universal. Reforzan que el tipo de tarea y el diseño de recuperación son tan importantes como el tamaño de la ventana.
Matriz de decisión: tamaño y coherencia del corpus
Cuando tenga un solo documento, un pequeño conjunto de documentos estrechamente relacionados o un paquete que deba interpretarse como una unidad, comience con pruebas de contexto largas. Es posible que no se pague el costo de construir y mantener una capa de recuperación, y la selección previa puede eliminar precisamente la información que conecta partes distantes del material.
Cuando el corpus ya es demasiado grande para enviarlo cómodamente, crece continuamente o contiene miles de elementos independientes, RAG se vuelve más natural. La pregunta del usuario normalmente requiere algunos documentos, no toda la colección.
Entre estos extremos, el híbrido suele ser la opción más flexible. La recuperación reduce el universo de búsqueda y el contexto largo funciona en un conjunto final más rico. En lugar de recuperar cinco párrafos aislados, por ejemplo, el sistema puede recuperar los tres documentos más relevantes y entregar versiones completas o secciones ampliadas de ellos al modelo.
Matriz de decisión: corpus estático o actualizado frecuentemente
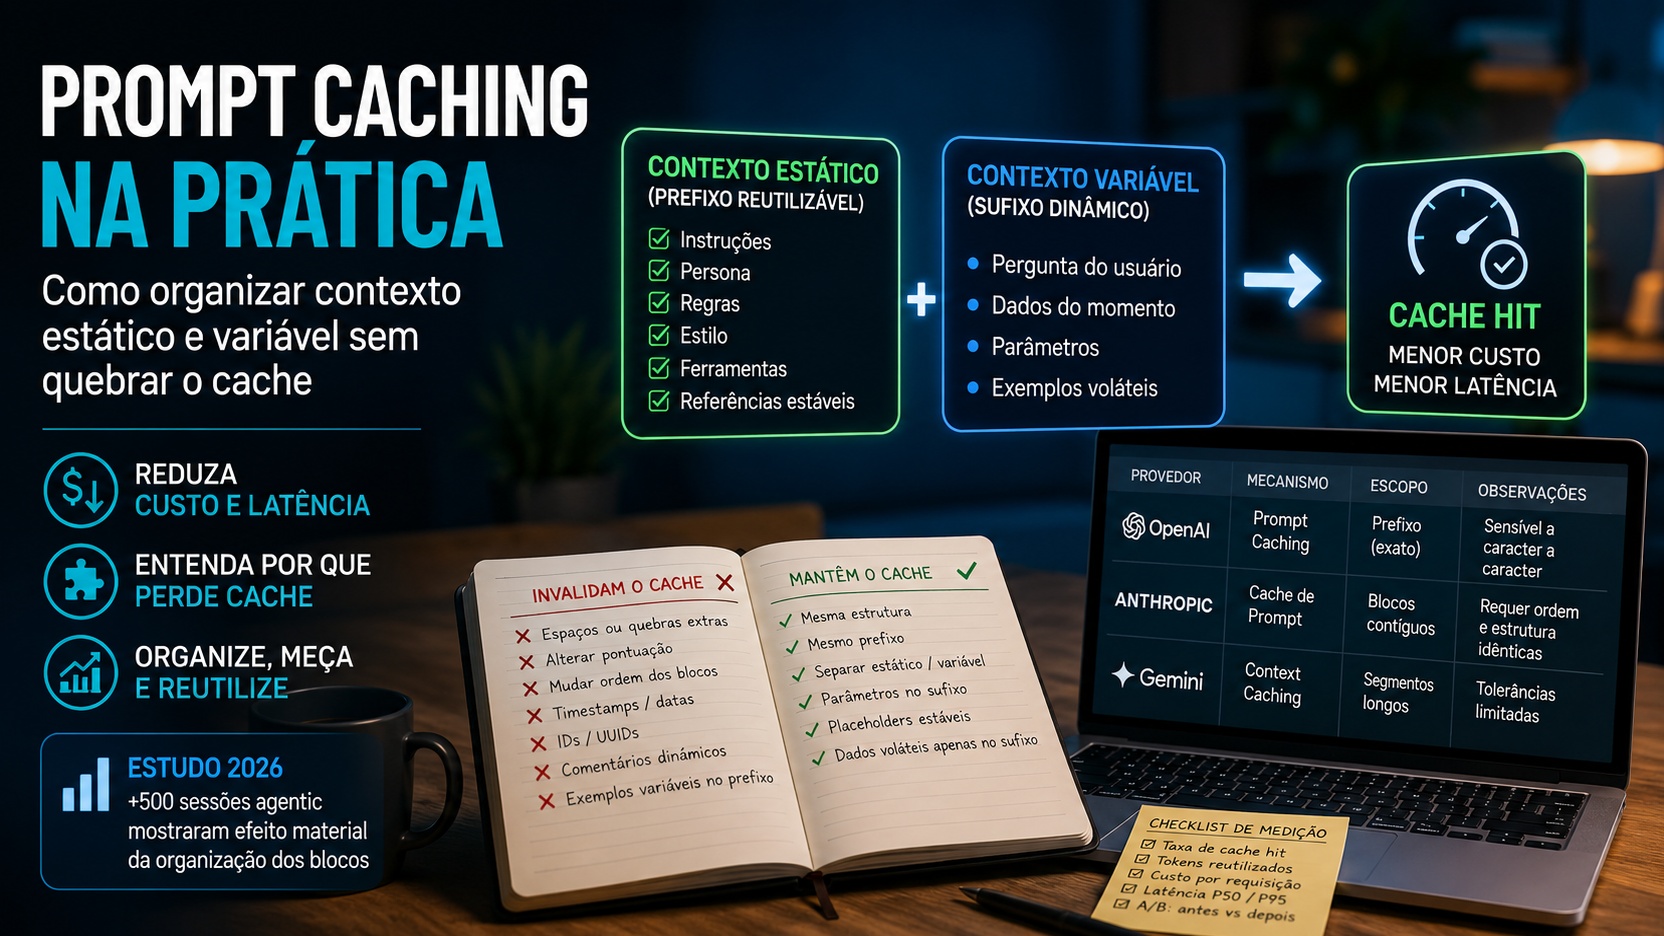
Un corpus estático favorece el contexto largo más de lo que parece, especialmente cuando la misma información se consulta repetidamente. Los mecanismos de almacenamiento en caché cambian la economía de esta elección. Gemini ofrece almacenamiento en caché de contexto para reutilizar tokens de entrada, y Anthropic también documenta el almacenamiento en caché de avisos para reutilizar prefijos estables y reducir el costo y la latencia en tareas repetitivas.
Si los documentos cambian poco y las preguntas se repiten, vale la pena probar el contexto largo con caché antes de asumir que RAG será más barato. El detalle crítico es medir el patrón real de reutilización: un caché solo ayuda cuando el material permanece lo suficientemente estable y las llamadas pueden reutilizar la parte común.
Sobre una base que cambia todo el tiempo, la lógica se invierte. Los productos, políticas, tickets, noticias internas, catálogos y registros operativos pueden requerir una actualización continua. Actualizar un índice de recuperación o consultar una fuente activa suele ser más eficiente que reconstruir un contexto gigante con cada cambio. Para datos verdaderamente en tiempo real, las herramientas de consulta del sistema fuente pueden ser más adecuadas que las incrustaciones estáticas.
Matriz de decisión: pregunta global o búsqueda específica
Las preguntas globales sitúan la decisión en un contexto amplio. “¿Cuáles son las principales divergencias entre estos informes?”, “resumir la evolución del argumento a lo largo del documento” y “¿qué premisas aparecen repetidamente a lo largo del conjunto?” requieren una visión amplia. Un RAG muy agresivo puede devolver solo fragmentos que ya parecen responder a la consulta y ocultar el resto del patrón.
Las preguntas particulares alientan a RAG. “¿Cuál es la política de reembolso del plan X?”, “¿en qué documento aparece el código Y?” o "¿cuál es la fecha límite asociada con esta regla?" tienden a depender de una pequeña parte de la colección. Enviar todo puede agregar costos y latencia sin mejorar la respuesta.
La prueba más útil es separar las preguntas reales en estos dos grupos y observar la proporción. Si casi todo es búsqueda puntual, RAG probablemente será el camino principal. Si la mayor parte requiere una lectura transversal, el contexto extenso merece más peso. Si ambos tipos son frecuentes, un enrutador híbrido puede evitar que todas las consultas paguen en el peor de los casos.
Matriz de decisión: citaciones y trazabilidad
Necesitar una fuente no significa automáticamente "usar RAG". Las API actuales también pueden proporcionar citas cuando los documentos se envían directamente. La documentación antrópica, por ejemplo, permite citas en documentos proporcionados al modelo y también en los resultados de búsqueda utilizados por las aplicaciones RAG.
La diferencia está en la arquitectura de procedencia. En RAG, cada resultado recuperado puede llevar un identificador, título y origen incluso antes de la generación, lo que facilita la auditoría de lo que entró en el contexto. En un contexto largo, es necesario preservar la identidad y la segmentación de los documentos para que la respuesta pueda apuntar correctamente a la fuente.
Si la cita es un requisito del producto, pruebe dos cosas por separado: si la respuesta es correcta y si la fuente indicada realmente respalda la afirmación.. Una arquitectura puede obtener el contenido correcto y la atribución incorrecta, o recuperar la fuente correcta y aun así formular una conclusión excesiva.
Matriz de decisión: coste, latencia y repetición de consultas
RAG tiende a reducir los tokens de entrada por llamada porque solo envía una fracción del corpus. Esta ventaja aumenta cuando la base de datos es enorme y cada pregunta utiliza pocos extractos. En
a cambio, usted paga por la infraestructura de ingesta, las incorporaciones, el almacenamiento, la búsqueda, la reclasificación y el mantenimiento.
El contexto largo elimina parte de esta infraestructura, pero cada llamada puede contener mucha más información. Si se consulta repetidamente el mismo corpus, el almacenamiento en caché puede reducir en gran medida esta diferencia. Si cada usuario trae un corpus diferente y hace una sola pregunta, puede que no haya tiempo para amortizar el caché.
La latencia también debe medirse de un extremo a otro. RAG agrega un paso de búsqueda, pero puede disminuir el tamaño del mensaje. El contexto largo elimina la búsqueda, pero las indicaciones más largas suelen aumentar el tiempo de procesamiento. La arquitectura más rápida no es obvia sin medir toda la cadena en su entorno.
Matriz de decisiones: mantener la recuperación
RAG traslada parte de la complejidad del modelo al sistema de información. Debe decidir cómo desglosar los documentos, qué metadatos conservar, qué modelo de incrustación utilizar, si habrá búsqueda léxica junto con semántica, cuántos resultados recuperar, si habrá reclasificación y cómo evaluar la recuperación.
Este mantenimiento es justificable cuando la base de datos es grande, está viva y es reutilizada por muchas consultas. En un conjunto pequeño y estable, puede haber complejidad sin retorno.
El contexto largo reduce esta capa, pero no elimina la ingeniería. Aún necesita controlar el orden de los documentos, las instrucciones, los formatos, el caché, los límites, los costos y las evaluaciones de precisión en toda la ventana. El error común es comparar un RAG de producción, lleno de componentes visibles, con un aviso largo tratado como si no tuviera funcionamiento ni fallas.
Cómo probar las tres arquitecturas con tu propio corpus
Reúna una serie de preguntas representativas antes de elegir. Incluye preguntas específicas con respuesta localizada, preguntas que requieren combinar dos o más fuentes, preguntas globales sobre el conjunto y casos en los que la respuesta correcta es decir que la información no está en los documentos. Si el corpus cambia, incluya también preguntas sobre el contenido recientemente actualizado.
Ejecute el mismo conjunto en tres variantes. Primero, envíe la mayor cantidad de contexto relevante directamente. En el segundo, use RAG con su configuración de recuperación. En el tercero, utilice una versión híbrida, como recuperar documentos candidatos y luego proporcionar al modelo un contexto más amplio de esos candidatos, o enrutar la consulta entre RAG y contexto largo.
Evalúe por separado la calidad de la respuesta, la cobertura de la evidencia, la precisión de las citas, la tasa de recuperación de la fuente correcta, la latencia, los tokens procesados y el costo. También registre fallas operativas: consulta que no encontró el documento correcto, caché que no se reutilizó, documento nuevo que no ingresó al índice o mensaje que excedió un límite.
Realice el examen en un volumen suficiente para representar la distribución de las preguntas. Un punto de referencia compuesto únicamente de búsquedas específicas favorecerá a RAG; un punto de referencia compuesto únicamente de síntesis globales favorecerá el contexto a largo plazo. La matriz sólo es útil si refleja el tráfico que realmente recibirá la aplicación.
Señales de que elegiste un contexto largo demasiado pronto
La primera señal es pagar repetidamente por miles de tokens que casi nunca influyen en la respuesta. La segunda es que la latencia crece a medida que crece el corpus, incluso cuando las preguntas siguen siendo locales. El tercero es darse cuenta de que la mayoría de las consultas siempre son
se concentra en una pequeña región de la base.
Aparece otra señal cuando la actualización se convierte en un problema operativo. Si un documento cambia y necesita volver a ensamblar o enviar un paquete grande para casi todas las consultas, una capa de recuperación puede brindar una mejor granularidad a la actualización.
Señales de que elegiste RAG demasiado pronto
Si los usuarios hacen preguntas transversales y la respuesta depende de relaciones que cruzan muchos documentos, un recuperador muy selectivo puede eliminar contextos importantes. Si el equipo dedica más tiempo a ajustar la fragmentación, la top-k y la reclasificación que a resolver el problema del producto, tal vez el corpus aún sea lo suficientemente pequeño como para un enfoque directo.
También es una advertencia cuando el error dominante no está en la generación, sino en “no apareció la fuente correcta”. En este caso, aumentar el modelo no necesariamente resuelve el problema; es necesario mejorar la recuperación o ampliar el contexto entregado después de la misma.
Cuando el híbrido deja de ser sofisticación y se convierte en la opción más sencilla
Híbrido vale la pena cuando hay un límite claro entre consultas locales baratas y consultas raras pero globales. Un enrutador puede mantener la mayoría de las consultas en RAG y escalar a un contexto largo cuando la consulta requiere una síntesis amplia.
También tiene sentido cuando la recuperación puede encontrar qué documentos importan, pero los fragmentos pequeños pierden relaciones internas. En este diseño, RAG selecciona documentos y el contexto largo preserva la estructura dentro del conjunto recuperado.
La desventaja es operativa: ahora tienes dos rutas para observar, evaluar y depurar. Por lo tanto, el híbrido no debería adoptarse sólo porque parezca técnicamente completo. Debería resolver una diferencia real entre los tipos de consultas.
La ventana de contexto es un límite técnico, no una estrategia de producto
Las ventanas de 1 millón de tokens o más han cambiado el punto de partida arquitectónico. Permitieron enviar volúmenes que anteriormente requerían una capa de recuperación. Pero no han eliminado las razones económicas, operativas e informativas para seleccionar el contexto.
RAG tampoco debe mantenerse por costumbre. Si todo el corpus es pequeño, estable y necesita ser leído en conjunto, una pila de incrustaciones, bancos de vectores y reordenadores pueden crear más lugares donde se pierda la información.
La decisión más defendible es medir tres cosas: cuánto del corpus realmente necesita cada pregunta, cuánto cambia ese corpus y cuántas veces se consultará el mismo material. Luego, pruebe el contexto largo, RAG y una alternativa híbrida con preguntas reales. La arquitectura adecuada es aquella que ofrece suficiente calidad y trazabilidad dentro del costo, la latencia y el mantenimiento que el producto puede soportar.