Categoria

Testes e Comparações

Avaliações reproduzíveis por tarefa, custo, velocidade, precisão e facilidade de uso.

20artigos
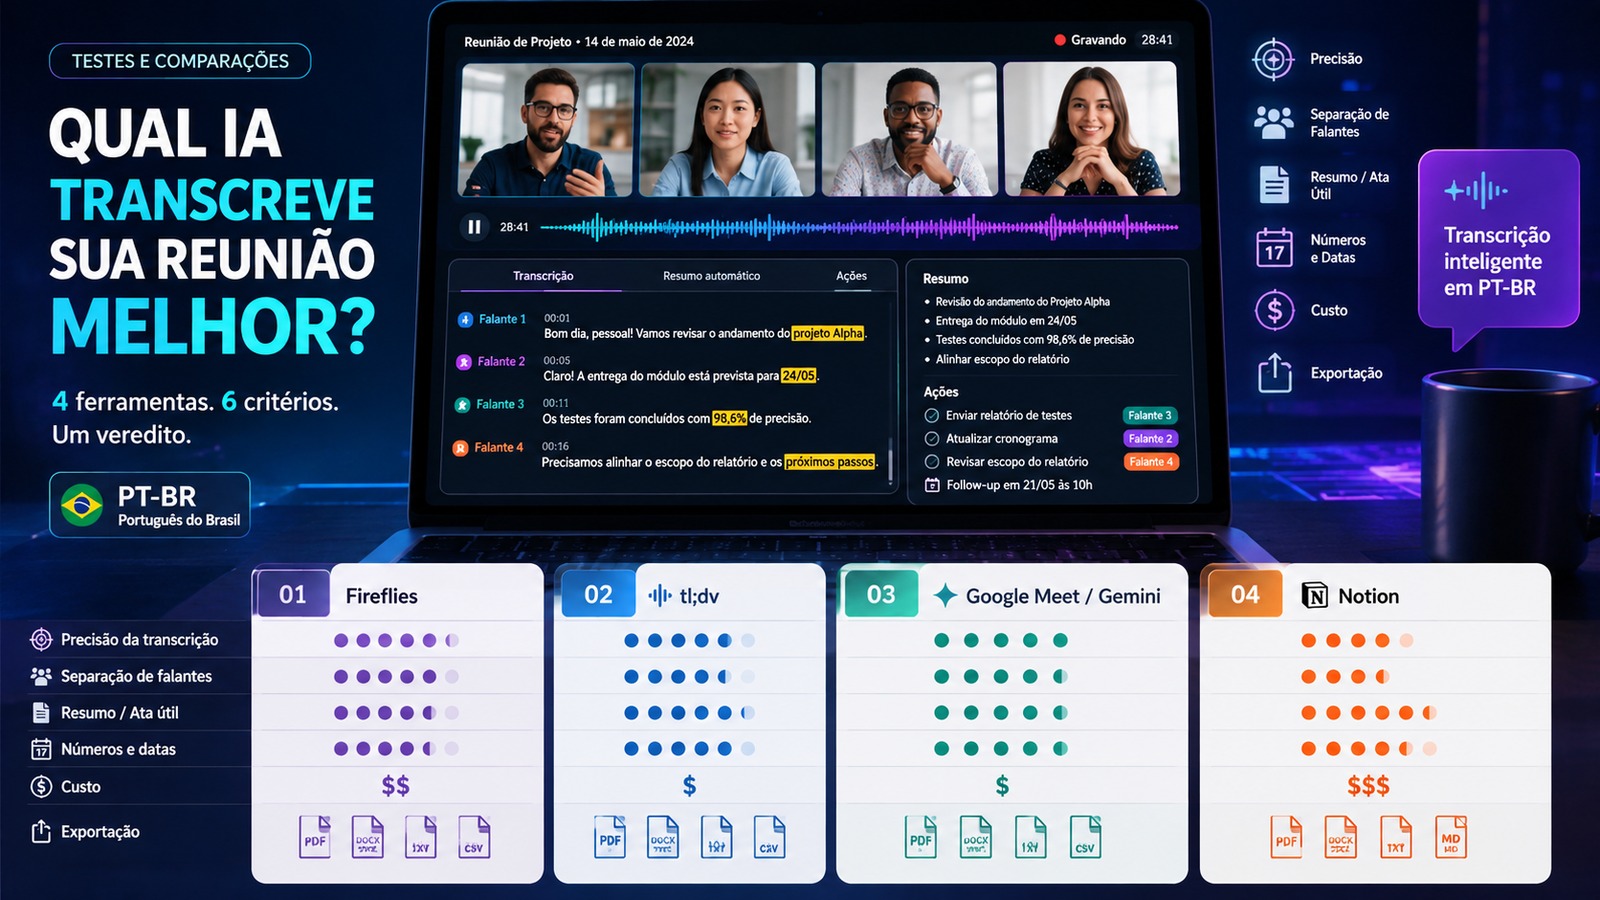
Montagem editorial com notebook exibindo reunião em vídeo, transcrição em português e quadro comparativo de Fireflies, tl;dv, Google Meet/Gemini e Notion.
Testes e Comparações19/08/202610 min de leitura

Qual IA transcreve melhor reuniões em português? Benchmark PT-BR de Fireflies, tl;dv, Google Meet/Gemini e Notion

A comparação útil em PT-BR exige gabarito humano: veja o que as quatro ferramentas suportam hoje e como medir precisão, falantes, atas, custo e exportação.

Ler artigo
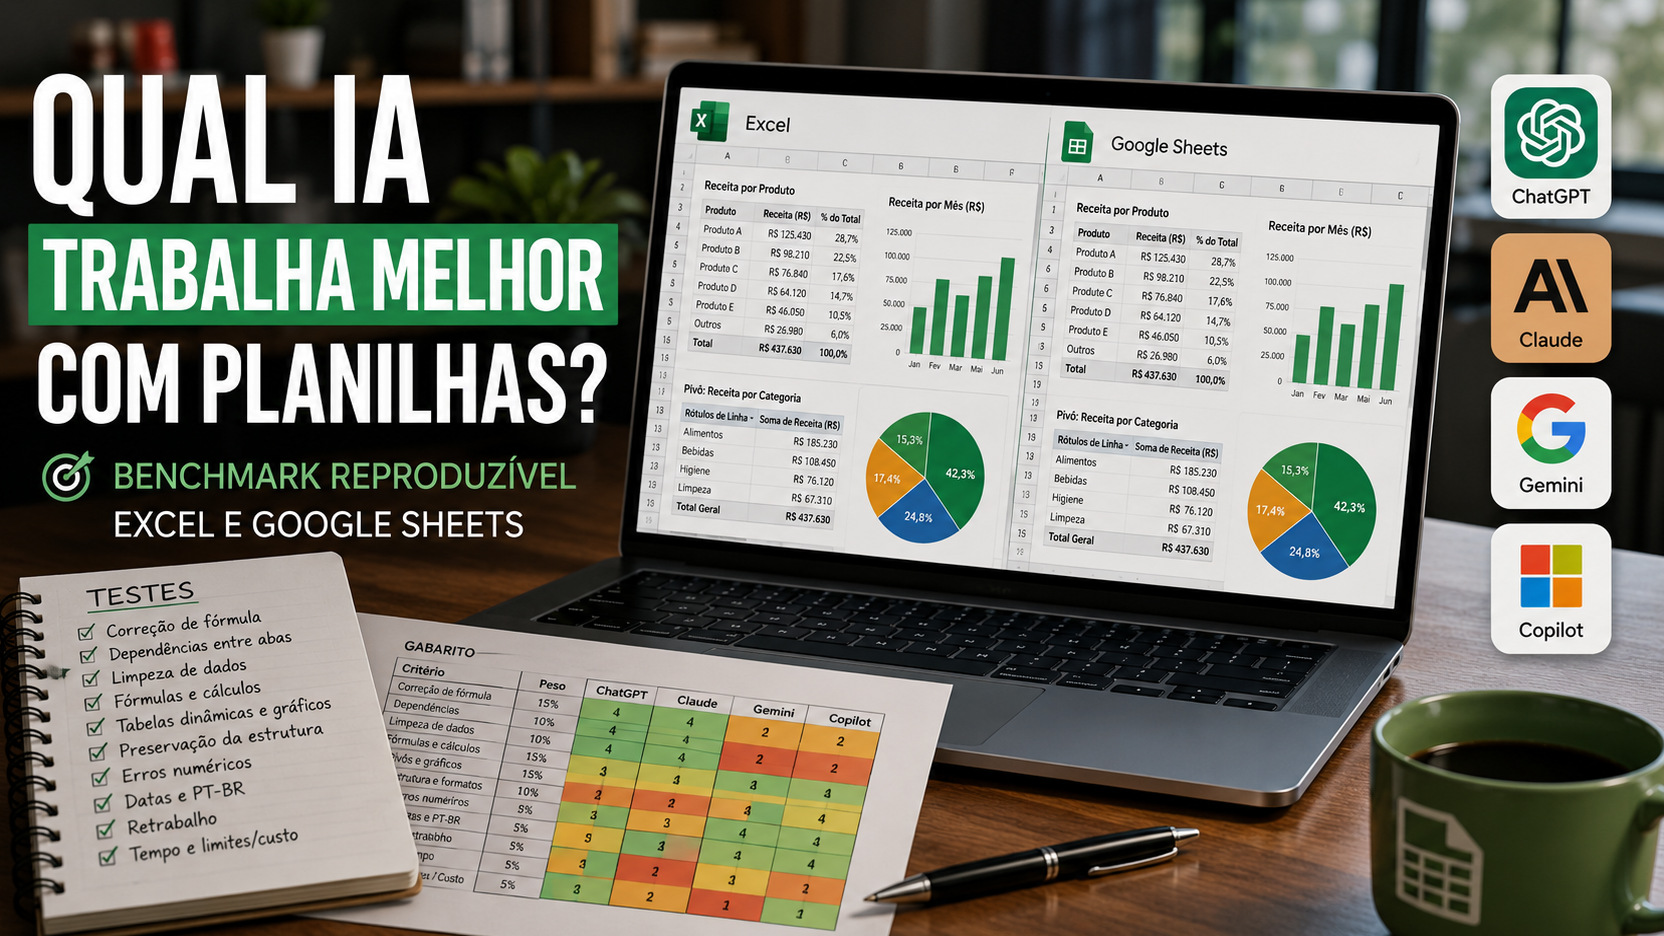
Notebook aberto em uma mesa exibindo planilhas no Excel e Google Sheets, com gráficos e tabelas; ao lado, caderno de testes, gabarito e ícones de ChatGPT, Claude, Gemini e Copilot.
Testes e Comparações18/08/20269 min de leitura

Qual IA trabalha melhor com planilhas? Como comparar ChatGPT, Claude, Gemini e Copilot em um benchmark reproduzível

Um teste justo de IA para planilhas precisa medir erros, preservação de fórmulas e estrutura, retrabalho e contexto do Excel/Sheets, não só recursos declarados.

Ler artigo
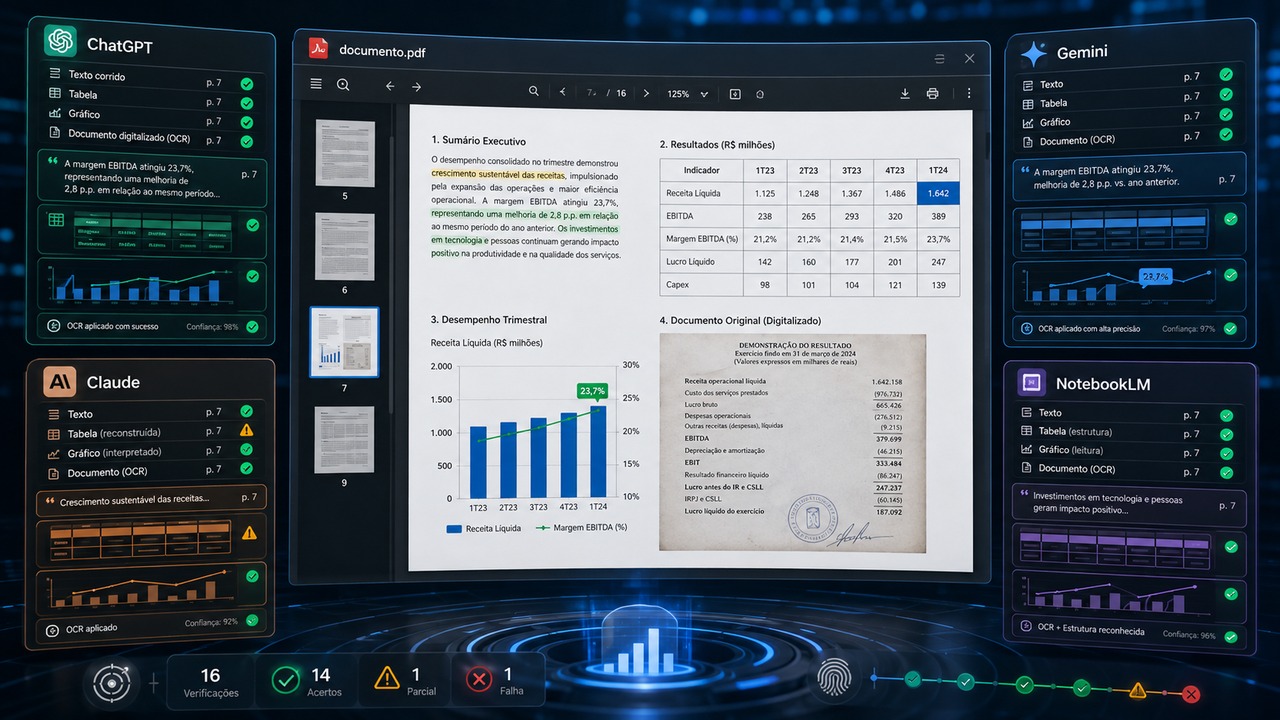
Painel comparativo em fundo escuro com um PDF central exibindo texto, tabela, gráfico e página digitalizada, cercado por quadros de ChatGPT, Claude, Gemini e NotebookLM com indicadores de acerto e OCR.
Testes e Comparações17/08/202611 min de leitura

Qual IA analisa melhor PDFs? Como testar ChatGPT, Claude, Gemini e NotebookLM com um benchmark reproduzível

Um método comparável para testar texto, tabelas, gráficos e páginas escaneadas, medir alucinações e descobrir onde cada ferramenta realmente falha.

Ler artigo
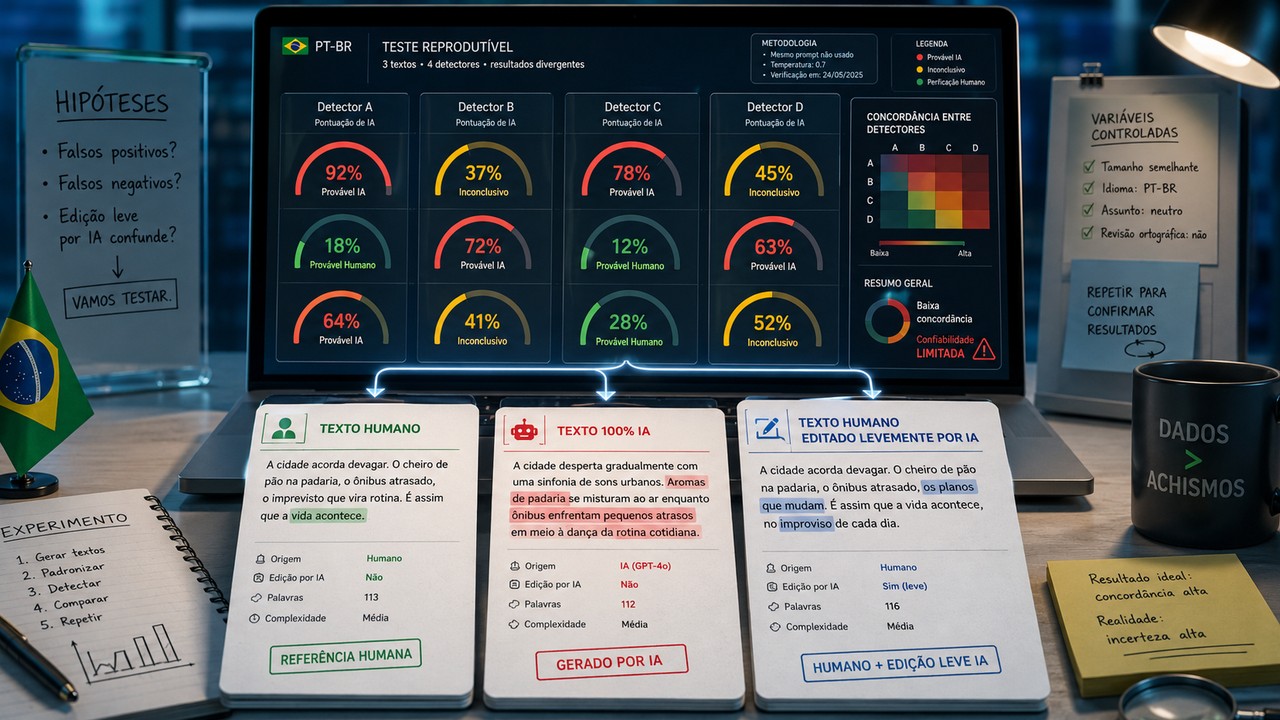
Mesa de teste com notebook exibindo pontuações divergentes de quatro detectores de IA para textos em PT-BR: humano, gerado por IA e humano editado por IA.
Testes e Comparações16/08/202612 min de leitura

Detector de IA funciona em português? O que um teste reproduzível em PT-BR precisa medir

GPTZero, Copyleaks e Winston declaram suporte a português; Turnitin não aceita PT-BR no relatório de IA. Entenda por que o score não prova autoria e como testar erros.

Ler artigo
Relatórios de pesquisa de quatro assistentes de IA comparados por cobertura, suporte e qualidade das citações.
Testes e Comparações09/08/202610 min de leitura

Deep Research sob auditoria: ChatGPT, Claude, Gemini e Perplexity sustentam o que citam?

Citações não garantem evidência. Veja o que estudos recentes mostram sobre ChatGPT, Claude, Gemini e Perplexity e como auditar pesquisas com IA.

Ler artigo
Agente de IA diante de várias ferramentas digitais, com uma chamada destacada e um fluxo de recuperação após erro.
Testes e Comparações08/08/20268 min de leitura

Tool calling sob pressão: qual modelo escolhe melhor a ferramenta e se recupera de erros?

Comparação atual de tool calling mostra quem lidera em fluxos reais, como os modelos lidam com falhas e quais testes fazer antes de levar um agente à produção.

Ler artigo
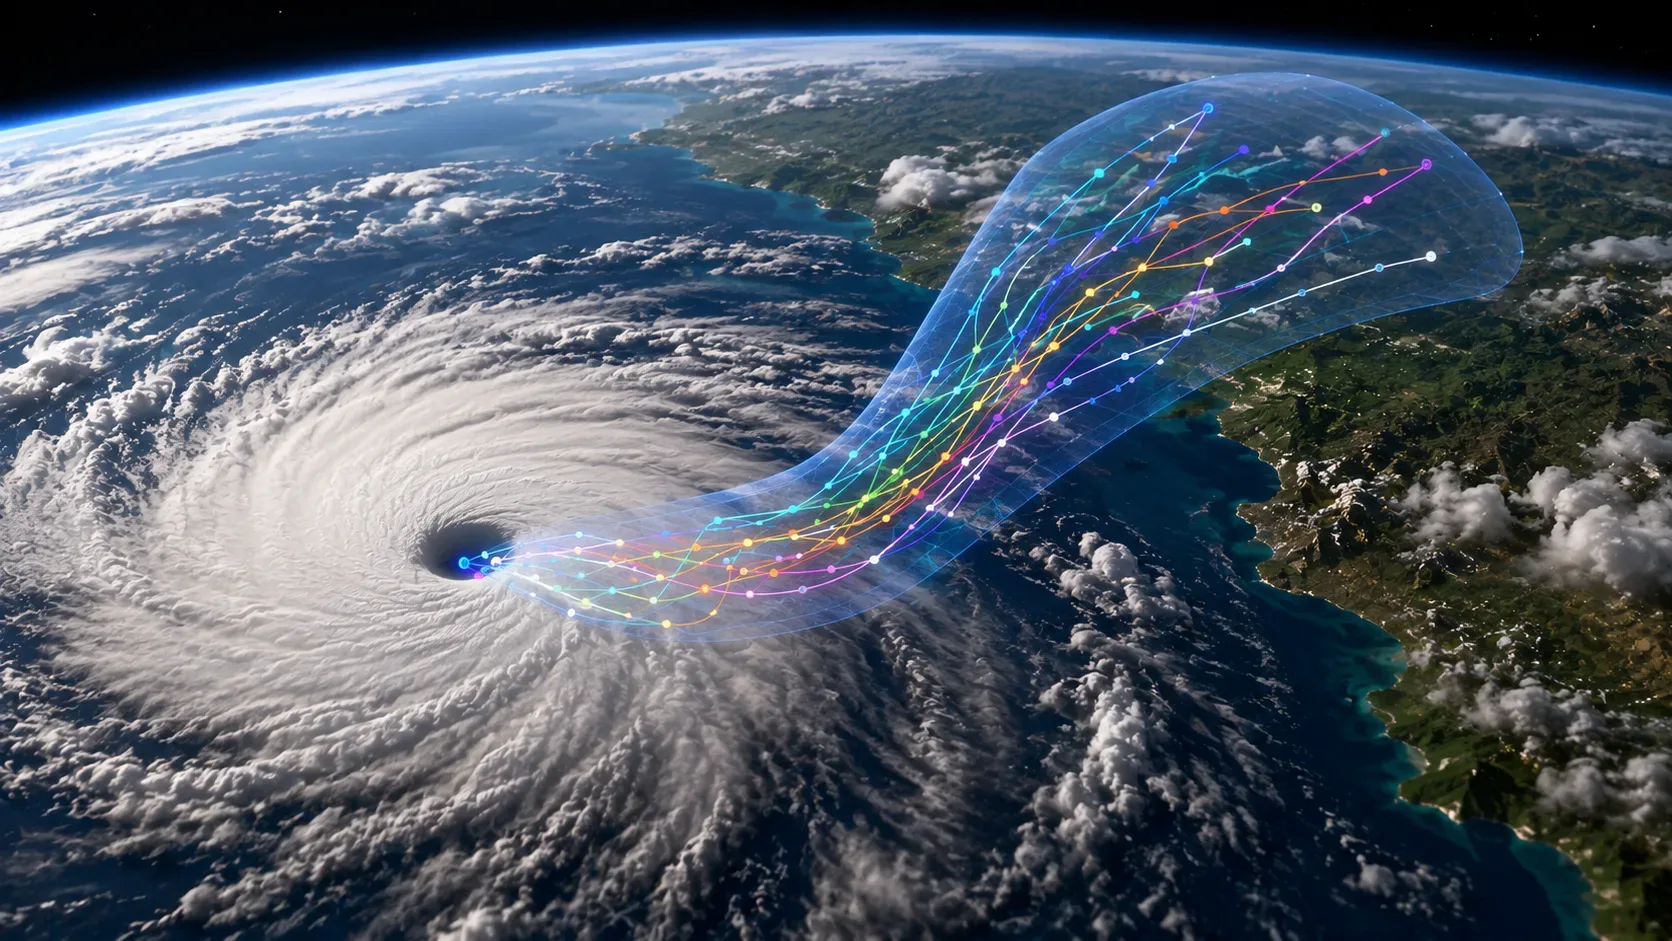
Trajetórias probabilísticas de um ciclone em vários membros de ensemble, usadas para ilustrar a incerteza da previsão.
Testes e Comparações06/08/202610 min de leitura

WeatherNext Cyclones dá “um dia extra” para prever ciclones? O que o novo estudo realmente comparou

O “dia extra” do WeatherNext Cyclones é uma vantagem média de desempenho em benchmarks, não uma garantia. Veja comparações, métricas, amostra e limites.

Ler artigo
Tabela comparando custo, latência e taxa de conclusão entre GPT-5.6 Luna, Terra e Sol
Testes e Comparações04/08/202613 min de leitura

GPT-5.6 Luna ficou 80% mais barato: quando vale trocar Terra ou Sol?

O Luna caiu a um décimo do preço do Terra. Veja o ponto de equilíbrio por tarefa, como contabilizar retrabalho e quando Sol ainda compensa.

Ler artigo