Cambiar dos oraciones en una pauta y que te guste más la siguiente respuesta no prueba que la pauta haya mejorado. Es posible que el caso haya cambiado, que el modelo haya variado el resultado o que la nueva versión haya sido mejor en un tipo de tarea y peor en otra. La pregunta útil, por lo tanto, no es "¿es buena esta respuesta?", sino "¿la nueva versión supera a la antigua repetidamente en los casos importantes, sin crear regresiones relevantes?".
Este razonamiento acerca la evaluación de las indicaciones a una prueba. La documentación de evaluación de OpenAI recomienda objetivos explícitos, conjuntos de datos vinculados al uso en el mundo real, métricas definidas y comparación continua. Anthropic también parte de criterios de éxito medibles, casos cercanos a la distribución real y rúbricas claras. Google Cloud, a su vez, documenta la evaluación por pares como una forma adecuada de elegir entre indicaciones cuando el objetivo es comparar dos alternativas. La idea común es simple: primero definir qué se considera éxito; luego genera evidencia.
El error más común: cambiar el mensaje y cambiar la prueba al mismo tiempo
Imagínese que la versión A respondió mal a una solicitud complicada. Reescribe el mensaje, envía otro ejemplo más simple y la versión B responde mejor. Esto puede ser una señal de progreso, pero no es una comparación. Para medir el efecto del cambio, el caso de entrada debe ser el mismo y las otras variables relevantes deben permanecer controladas tanto como sea posible.
Si el objetivo es probar solo el mensaje, mantenga el mismo modelo y versión del modelo, las mismas instrucciones del sistema, las mismas herramientas disponibles, el mismo contexto recuperado, la misma política de tamaño de salida y parámetros de generación equivalentes. Cuando sea necesario cambiar alguna de estas condiciones, registre el cambio. Sin esto, se puede atribuir una mejora al mensaje cuando proviene de otra parte del sistema.
En uso manual, el control no necesita convertirse en un laboratorio académico. Simplemente escriba lo que se mantuvo arreglado y ejecute A y B en el mismo conjunto de casos. Lo importante es que la comparación tenga reglas estables.
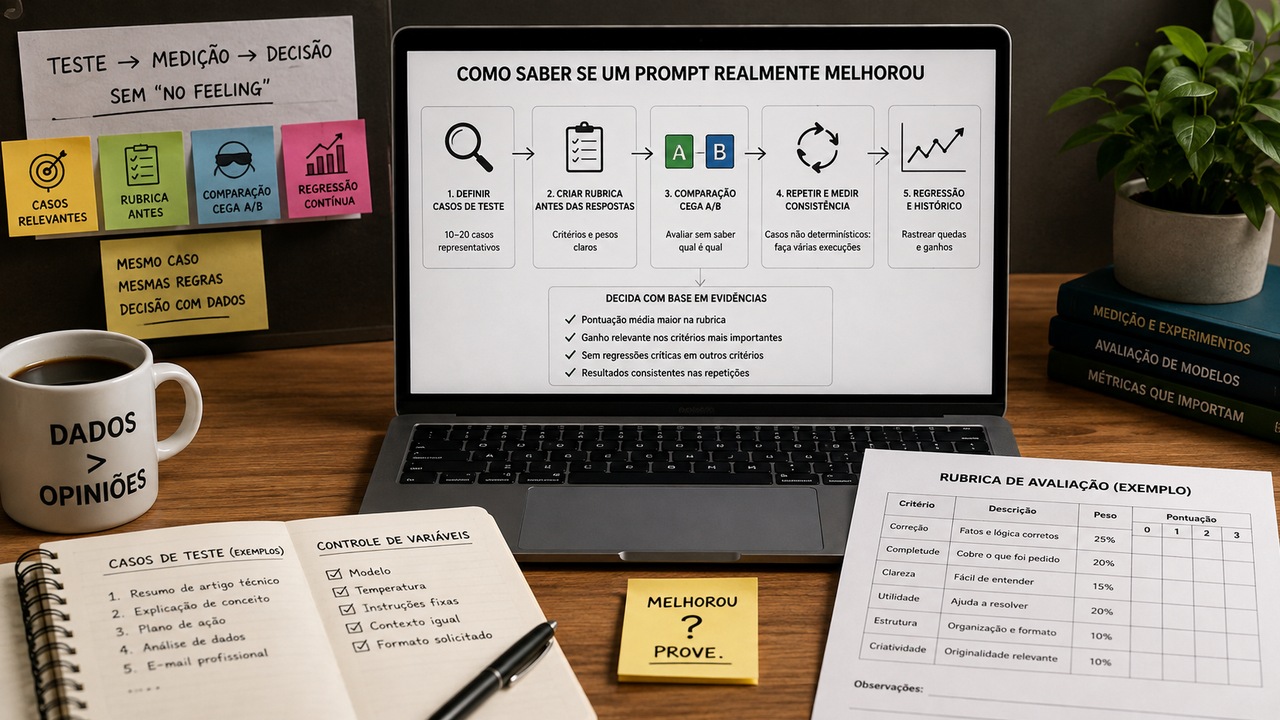
Comience con 10 a 20 casos que representen un trabajo real
Para una primera evaluación operativa, un conjunto de 10 a 20 casos puede ser suficiente para descubrir grandes diferencias entre dos versiones. Este número no es un estándar estadístico universal ni garantiza que un mensaje esté listo para cualquier uso. Sirve como un conjunto inicial de gran utilidad, lo suficientemente pequeño como para revisarlo manualmente y lo suficientemente grande como para no depender de un solo ejemplo.
Los estuches deben cubrir el centro y los bordes de la tarea. Si el mensaje resume documentos, no se limite a probar textos breves y bien escritos; incluya material extenso, información faltante, pasajes contradictorios y entradas con detalles irrelevantes. Si el mensaje responde a los clientes, incluya una solicitud común, un mensaje ambiguo, una solicitud fuera de política, un cliente enojado y un caso en el que la respuesta correcta sea admitir que falta información.
Es útil separar los casos por sectores. Un segmento puede ser “simple solicitud”, otro “ambigüedad”, otro “riesgo de inventar información”, otro “formateo”. Cuando cambia el promedio final, estos sectores muestran dónde se produjo la ganancia y dónde se ocultó una regresión.
También vale la pena reservar algunos casos que no se utilizarán al reescribir el mensaje.. Funcionan como una pequeña validación fuera del conjunto que guió la mejora. Esto reduce el riesgo de ajustar la versión B solo para los ejemplos que ya conoce.
Establece la rúbrica antes de mirar las respuestas
Una rúbrica convierte "me gustó más" en criterios observables. El momento de escribirlo importa: si los criterios aparecen después de haber visto A y B, existe la tentación de elegir reglas que favorezcan la respuesta preferida. Por lo tanto, escriba la rúbrica antes de generar o comparar resultados.
Para una tarea de texto general, una rúbrica puede combinar corrección, cumplimiento de las instrucciones, integridad, claridad y formato. No existe una combinación universal. La rúbrica debe reflejar qué causaría el éxito o el fracaso en el uso real. Si omitir una advertencia crítica es peor que escribir con menos elegancia, este peso debe aparecer en la evaluación.
Una escala corta suele ser más fácil de aplicar de manera consistente. Por ejemplo, cada criterio se puede calificar de 0 a 3. Cero significa falla grave o ausencia del requisito; 1 significa servicio parcial con problema relevante; 2 significa servicio adecuado con defectos menores; 3 significa servicio completo. El valor de la escala está menos en el número y más en los anclajes que explican lo que significa cada nota.
Los pesos pueden reflejar prioridad. En una solicitud de respuesta de un cliente, un ejemplo plausible sería la corrección con un 30%, el cumplimiento de las instrucciones con un 25%, la integridad con un 20%, la claridad con un 15% y el formato con un 10%. Si una dimensión no es negociable, trátela también como un criterio de bloqueo. Por lo tanto, una versión no se aprueba sólo porque compensó un defecto crítico con buena redacción en otros elementos.
Compare A y B sin dejar que el nombre de la versión contamine el juicio
Una simple comparación ciega ayuda cuando la evaluación es humana. En lugar de mostrar una “pregunta antigua” y una “pregunta mejorada”, etiquete las respuestas como X e Y, mezcle el orden en cada caso y solicite al evaluador que aplique la rúbrica sin saber qué versión produjo cada resultado. Luego, revela el origen.
Este diseño es especialmente útil cuando la persona que lo evalúa también escribió la nueva versión. La persona naturalmente espera que el cambio funcione. Ocultar la identidad de las respuestas no elimina todos los sesgos, pero reduce la posibilidad de convertir las expectativas en puntuaciones.
Además de la calificación por rúbrica, registre la preferencia directa: X mejor, Y mejor o empate. Las evaluaciones por pares son útiles cuando dos respuestas son aceptables, pero una cumple mejor el objetivo. La propia documentación de OpenAI destaca que los modelos tienden a ser más confiables al discriminar opciones que en evaluaciones completamente abiertas, y Google Cloud ofrece métricas por pares específicamente para comparar indicaciones y modelos.
Repita los casos en los que la salida varía
Los modelos generativos pueden producir diferentes respuestas para la misma entrada. Una sola ejecución puede favorecer a A o a B por casualidad. Si un caso importante fluctúa, ejecute ambas versiones nuevamente manteniendo la misma configuración.
En un proceso manual, tres repeticiones ya pueden revelar un patrón útil: una versión que parecía excelente en la primera ronda puede fallar en las dos siguientes, mientras que otra puede ser menos brillante pero más estable. Para tareas con mayor riesgo o mayor variabilidad, aumente el número de repeticiones y trate la estabilidad como un criterio en sí mismo.
No agregues repeticiones como si fueran casos independientes sin pensar en el diseño. El objetivo práctico es descubrir si el comportamiento es consistente. Registre cada ejecución y luego resuma la tendencia por caso: una victoria estable, una victoria estable B, un empate o un resultado volátil.
La regresión es la parte que esconde la media
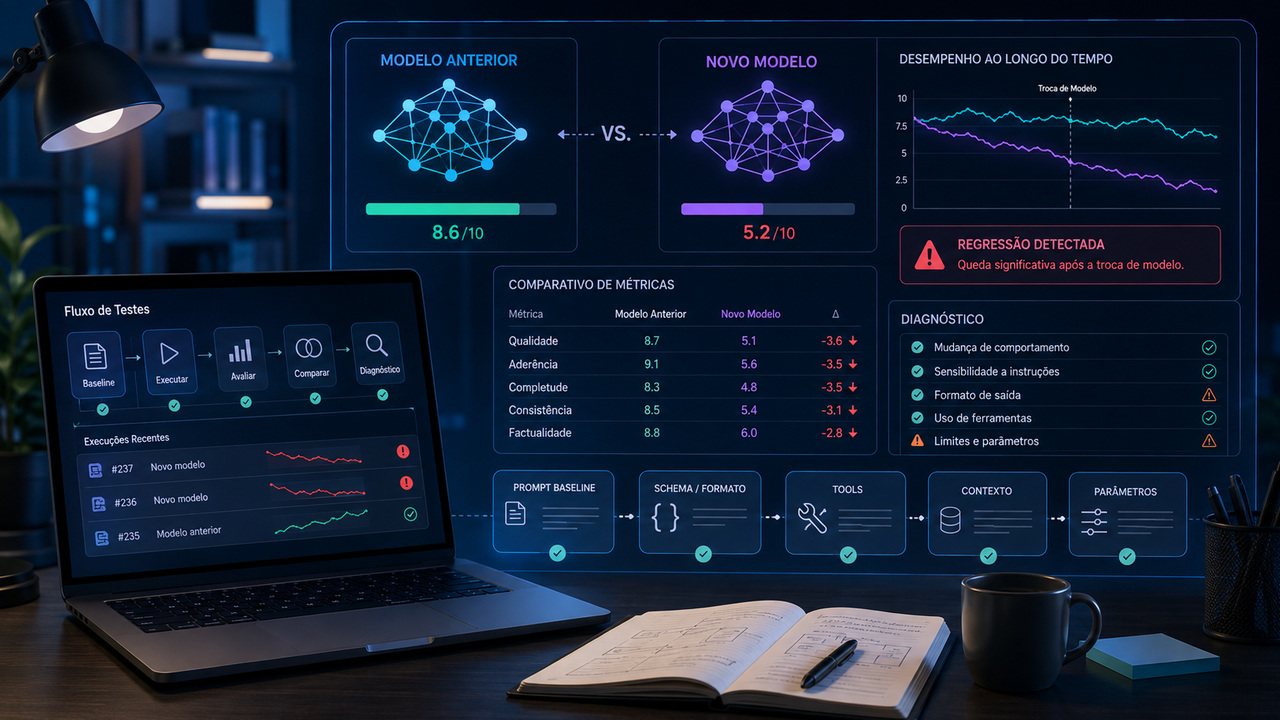
Una nueva versión podría elevar la puntuación media y ser aún peor. Esto sucede cuando mejora muchos casos fáciles, pero falla un caso raro e importante. La regresión es precisamente la pérdida de rendimiento en algo que antes funcionaba.
Por lo tanto, compare caso por caso. Marque como regresión cualquier situación en la que B empeoró en comparación con A y califique la gravedad. Una pequeña caída en el estilo puede ser tolerable; inventar información que la versión anterior no inventó puede bloquear el cambio.
Antes de realizar la prueba, defina la regla de decisión. Un ejemplo práctico sería: B necesita tener una puntuación ponderada más alta, ganar más casos de los que pierde y no mostrar una regresión crítica. Otro proyecto puede requerir una ganancia mínima en un criterio específico, como el cumplimiento del formato. Lo importante es evitar crear la regla después de ver el marcador.
La hoja de cálculo modelo puede ser sencilla
No necesitas una plataforma de evaluación para comenzar. Una hoja de cálculo ya le permite ejecutar un proceso disciplinado. Cada línea representa un caso o una repetición de un caso. Las columnas esenciales pueden ser: ID de caso, segmento, entrada, comportamiento esperado, criticidad, versión calificada, número de repetición, respuesta, calificaciones por criterio, calificación ponderada, preferencia A/B, regresión, observación, modelo y configuración utilizada.
Si desea mantener A y B uno al lado del otro, use una fila por caso con dos bloques de columnas: respuesta A y calificaciones A, respuesta B y calificaciones B. Agregue una columna de “ganador” y otra de “regresión crítica”. Para una comparación ciega, evalúe primero en una copia donde las respuestas aparecen como X e Y; solo entonces complete la columna que revela qué mensaje generó cada uno.
La hoja de cálculo también debe guardar la versión exacta de las indicaciones. Evite nombres vagos como "nuevo mensaje". Utilice identificadores como A-2026-08-16 y B-2026-08-16. Si la evaluación se repite en el futuro después de cambiar el modelo, contexto o herramienta, este historial ayuda a distinguir la regresión de los cambios provocados en el resto del sistema.
Ejemplo completo: de un mensaje genérico a un mensaje comprobable
Considere un caso ficticio: un equipo utiliza IA para responder correos electrónicos de clientes sobre el progreso de las solicitudes. La versión A del mensaje dice: "Responda al cliente de manera cortés y objetiva, explicándole el estado y el siguiente paso". Suena razonable, pero deja implícitas decisiones importantes.
La versión B dice: "Responder al cliente en hasta 120 palabras. Explicar sólo la información presente en el contexto proporcionado. Informar el estado actual, confirmar el siguiente paso y, si no hay una fecha límite confirmada, indicar explícitamente que la fecha límite aún no está disponible. No inventar fechas, responsables ni garantías. Mantener un tono cordial y directo."
Antes de realizar la prueba, el equipo define cuatro criterios. La corrección de hechos recibe una ponderación del 35%; adherencia a restricciones, 30%; integridad, 20%; claridad, 15%. Inventar una fecha límite o un responsable es una regresión crítica y bloquea la aprobación, independientemente del promedio.
El set contiene 12 estuches. Hay mensajes simples, pedidos sin fecha límite confirmada, clientes enojados, contexto incompleto y un caso en el que el historial muestra dos fechas contradictorias. Las respuestas se generan con el mismo modelo, la misma configuración y el mismo contexto para cada caso. Un evaluador sólo recibe X e Y, sin saber cuál corresponde a A o B.
Supongamos que, en este ejemplo hipotético, B gana 8 casos, A gana 2 y hay 2 empates. B también obtiene un promedio ponderado más alto. Sin embargo, en un caso con fechas contradictorias, B elige una fecha y la presenta como confirmada, mientras que A evita indicar una fecha límite. Según la regla definida antes de la prueba, B aún no está aprobado: ha habido una regresión crítica.
Luego, el equipo cambia solo la declaración relacionada con el conflicto de información, creando una versión C. Se repiten los mismos 12 casos, prestando especial atención al caso que fracasó. Si C mantiene las ganancias de B y elimina la regresión crítica, hay evidencia de mejora mucho más fuerte que la impresión que produce una respuesta bonita.
El objetivo del ejemplo no es que cada prueba necesite 12 casos, cuatro criterios o esas ponderaciones. La cuestión es que la decisión se decidió antes de la puntuación, las versiones se enfrentaron a las mismas entradas y una mejora media no borró un defecto importante.
Cómo elegir entre calificación absoluta y preferencia A/B
La puntuación absoluta responde "¿en qué medida esta respuesta cumple con el estándar?". Es mejor cuando el equipo necesita saber si cada versión pasa un nivel mínimo. La preferencia A/B responde “¿cuál de las dos es mejor en este caso?”. Es útil cuando es difícil calificar las respuestas con precisión, pero la diferencia entre ellas es notable.
Los dos enfoques pueden coexistir. Utilice la rúbrica para comprobar la calidad mínima y los criterios críticos; utilice la preferencia por pares para comparar versiones directamente. Cuando la rúbrica y la preferencia no estén de acuerdo, investigue el caso en lugar de ocultar la divergencia en la media.
La evaluación automática también se puede incluir en el proceso. Las reglas de código son excelentes para requisitos objetivos como la presencia de campos, el formato válido o el tamaño máximo. El juicio humano es más flexible, pero cuesta tiempo. Un modelo de evaluación puede escalar evaluaciones subjetivas, pero debe probarse y calibrarse con evaluaciones humanas antes de recibir confianza operativa. La documentación de Anthropic y Google Cloud aborda explícitamente esta necesidad de rúbricas claras y calibración automática del calificador.
Cuando un mensaje puede considerarse mejor
Un cambio está bien sustentado cuando hay convergencia de evidencia: la nueva versión mejora la métrica principal, gana casos más relevantes, mantiene o mejora criterios de prioridad, no crea regresiones críticas y repite el resultado en los casos que presentan variabilidad.
Esto es diferente a exigir la perfección. Las indicaciones reales casi siempre implican compensaciones. Una versión podría ser un poco más larga y, a su vez, reducir las omisiones. Otro puede ganar claridad pero perder velocidad. Las pruebas hacen visible este costo para que el equipo pueda elegir conscientemente.
También es saludable registrar un resultado no concluyente. Si A y B están empatados, si las repeticiones fluctúan mucho o si la rúbrica no puede separar la calidad, la conclusión correcta puede ser “todavía no hay evidencia de mejora”.. Esto es mejor que forzar una victoria para justificar el trabajo ya realizado.
Convertir nuevos fallos en casos permanentes
El conjunto de pruebas no debe congelarse. Siempre que surja un fracaso realmente importante, conviértalo en un nuevo caso de regresión. En el siguiente cambio de solicitud, este caso se ejecuta nuevamente. Con el tiempo, la suite llega a representar no sólo ejemplos planificados, sino también errores que el sistema ya ha cometido.
Este ciclo es el que hace que la evaluación puntual deje de ser una revisión ocasional y se convierta en control de calidad. La nueva versión no sólo tiene que sonar inteligente en la conversación; necesita sobrevivir a la historia de problemas que el equipo ya ha aprendido a reconocer.
Al final, “mejor mensaje” es una afirmación comparativa. Sólo tiene sentido cuando existe una versión de referencia, un conjunto de casos, criterios definidos antes de la observación y una regla de decisión. El sentimiento sigue siendo útil para formular hipótesis y darse cuenta de que algo podría ser mejor. Sin embargo, la aprobación debe provenir de pruebas.